
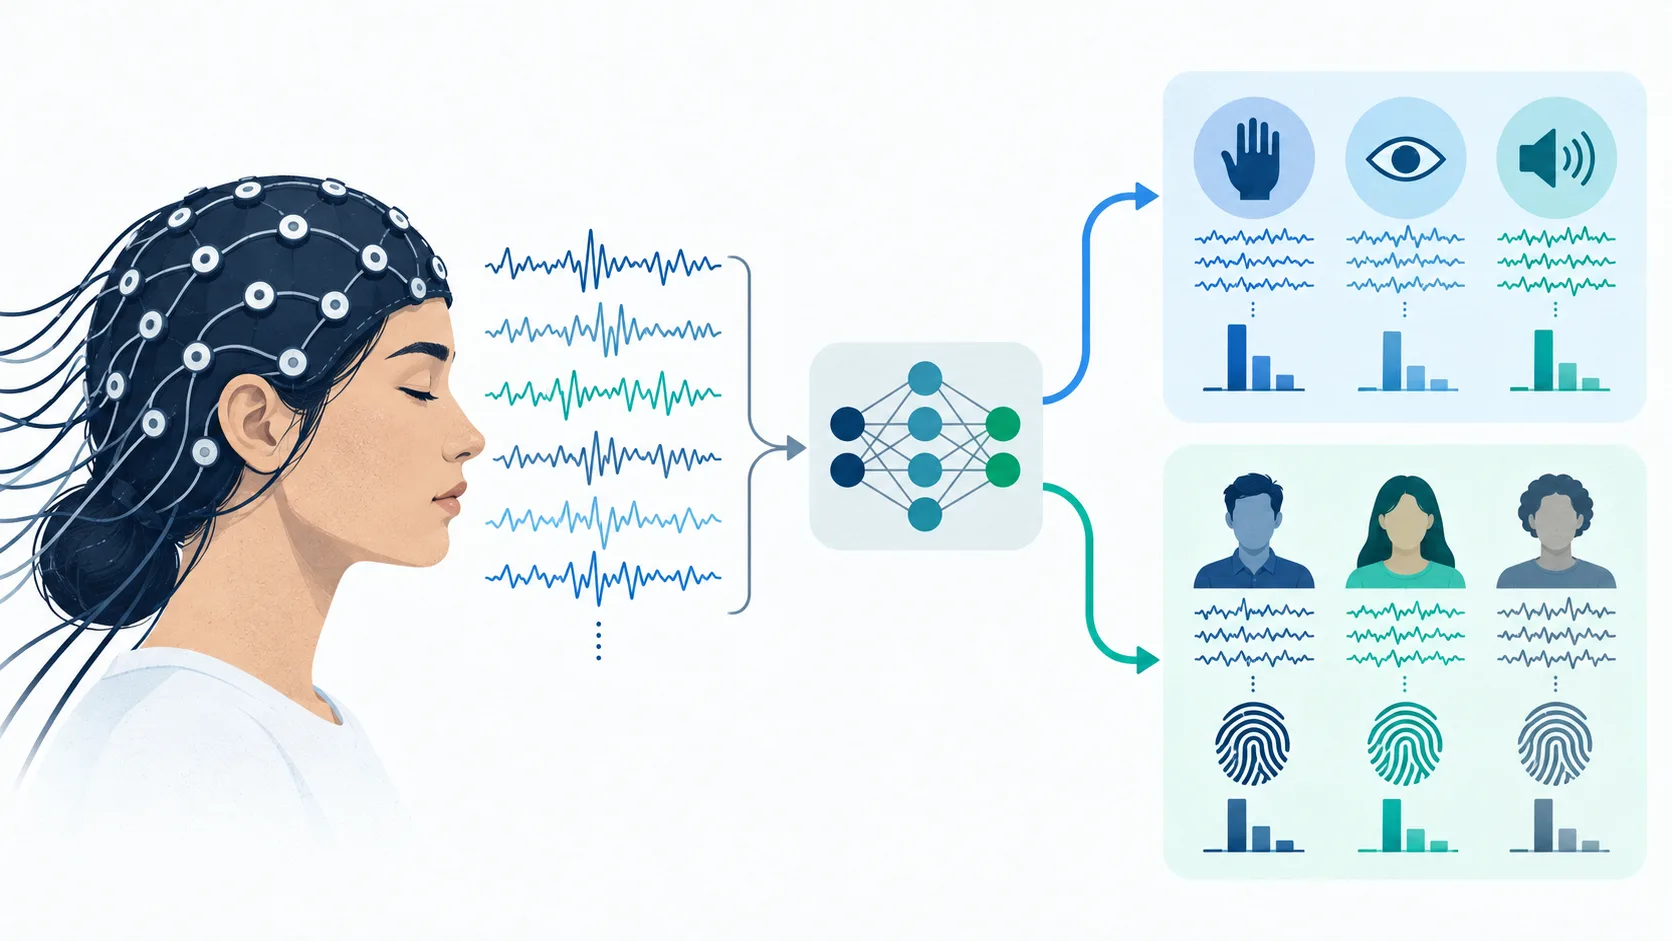
Ao implementar pipelines de aprendizado de máquina para EEG, dividir os dados em janelas aleatórias pode gerar resultados enganosamente otimistas se o mesmo sujeito aparecer nos conjuntos de treino e de teste. Essa abordagem não testa a verdadeira generalização para novos sujeitos, pois os modelos podem aprender padrões específicos de cada participante em vez de sinais relacionados à tarefa. O problema vai além do EEG e se aplica a qualquer área com medições repetidas da mesma fonte, como sensores vestíveis ou dados comportamentais.
Neste estudo, os pesquisadores replicaram um experimento simples de EEG que comparava dados de uma tarefa de fundo e de cálculo mental, usando características espectrais e três algoritmos padrão de aprendizado de máquina. Eles contrastaram a divisão aleatória de janelas com uma avaliação com participantes retidos, na qual todas as janelas de um sujeito são atribuídas exclusivamente ao treino ou ao teste. O conjunto de dados utilizado foi o EEG During Mental Arithmetic Tasks (EEGMAT), do Physio Net, com 36 registros (18 sujeitos, cada um com gravações de fundo e de aritmética). Após a filtragem e o janelamento, foram extraídas 2.134 janelas de quatro segundos, sendo 1.594 de fundo e 540 de aritmética, o que resultou em 76 características por janela, por meio da potência relativa em quatro bandas de frequência em 19 canais de EEG. A análise buscava isolar o efeito da metodologia de avaliação, e não desenvolver novos biomarcadores, por isso usou características convencionais e controlou o equilíbrio entre classes e o poder discriminativo das características.
Os resultados mostraram que a avaliação com consciência dos participantes alterou significativamente as estimativas de desempenho, revelando que divisões aleatórias padrão superestimam a generalização do modelo quando há estrutura específica de cada sujeito.
Fonte: Towards Data Science · Resumido por HeadlinesBriefing