
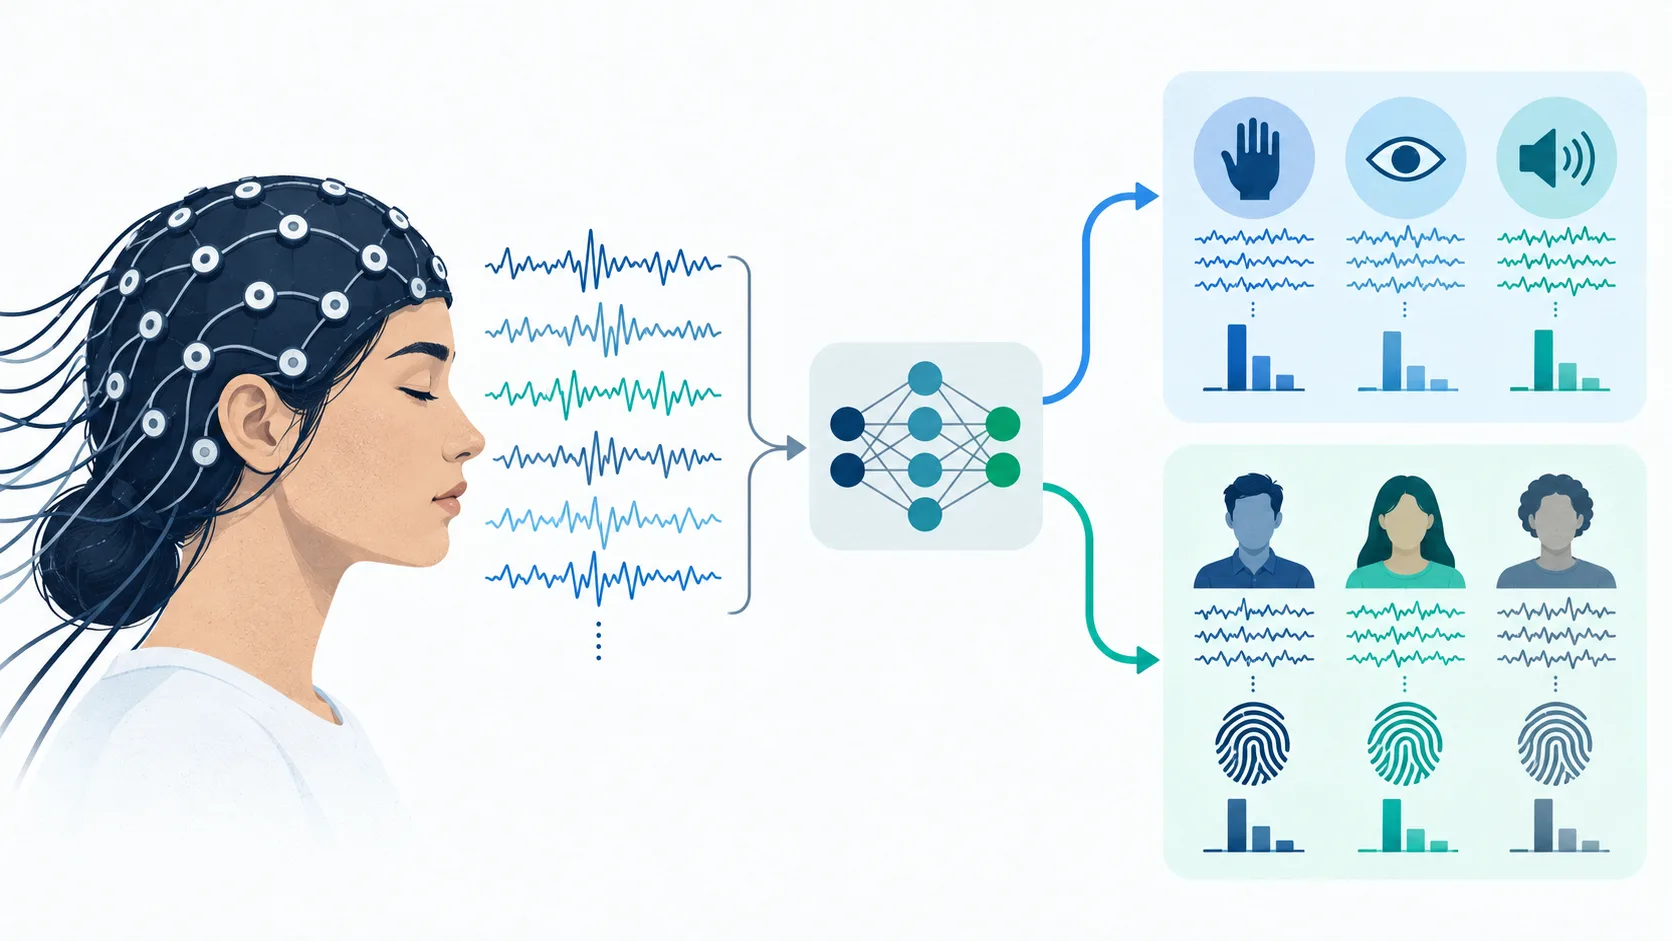
При построении конвейеров машинного обучения для ЭЭГ разбиение данных на случайные окна может давать обманчиво оптимистичные результаты, если один и тот же испытуемый попадает одновременно в обучающую и тестовую выборки. Такой подход не проверяет истинную способность модели обобщать на новых испытуемых, поскольку модели могут выучивать особенности конкретных участников, а не сигналы, связанные с задачей. Проблема выходит за рамки ЭЭГ и касается любой области с повторными измерениями из одного источника, например носимых датчиков или поведенческих данных.
В этом исследовании учёные воспроизвели простой эксперимент с ЭЭГ, сравнивая данные фонового состояния и задачи на ментальный счёт, с использованием спектральных признаков и трёх стандартных алгоритмов машинного обучения. Они сопоставили случайное разбиение по окнам с оценкой по удержанным участникам, при которой все окна одного испытуемого назначаются исключительно либо для обучения, либо для тестирования. Использовался набор данных EEG During Mental Arithmetic Tasks (EEGMAT) с сайта Physio Net, включающий 36 записей (18 испытуемых, у каждого запись в фоновом состоянии и при арифметической задаче). После фильтрации и разбиения на окна было извлечено 2 134 четырёхсекундных окна, из них 1 594 фоновых и 540 арифметических, что дало 76 признаков на окно за счёт относительной мощности в четырёх частотных диапазонах по 19 каналам ЭЭГ. Анализ был направлен на выделение влияния методологии оценки, а не на разработку новых биомаркеров, поэтому применялись традиционные признаки, а баланс классов и дискриминативная способность признаков контролировались.
Результаты показали, что оценка с учётом участников существенно изменила оценки качества, выявив, что стандартные случайные разбиения завышают обобщающую способность модели при наличии структуры, специфичной для испытуемых.
Источник: Towards Data Science · Сводку подготовил HeadlinesBriefing