
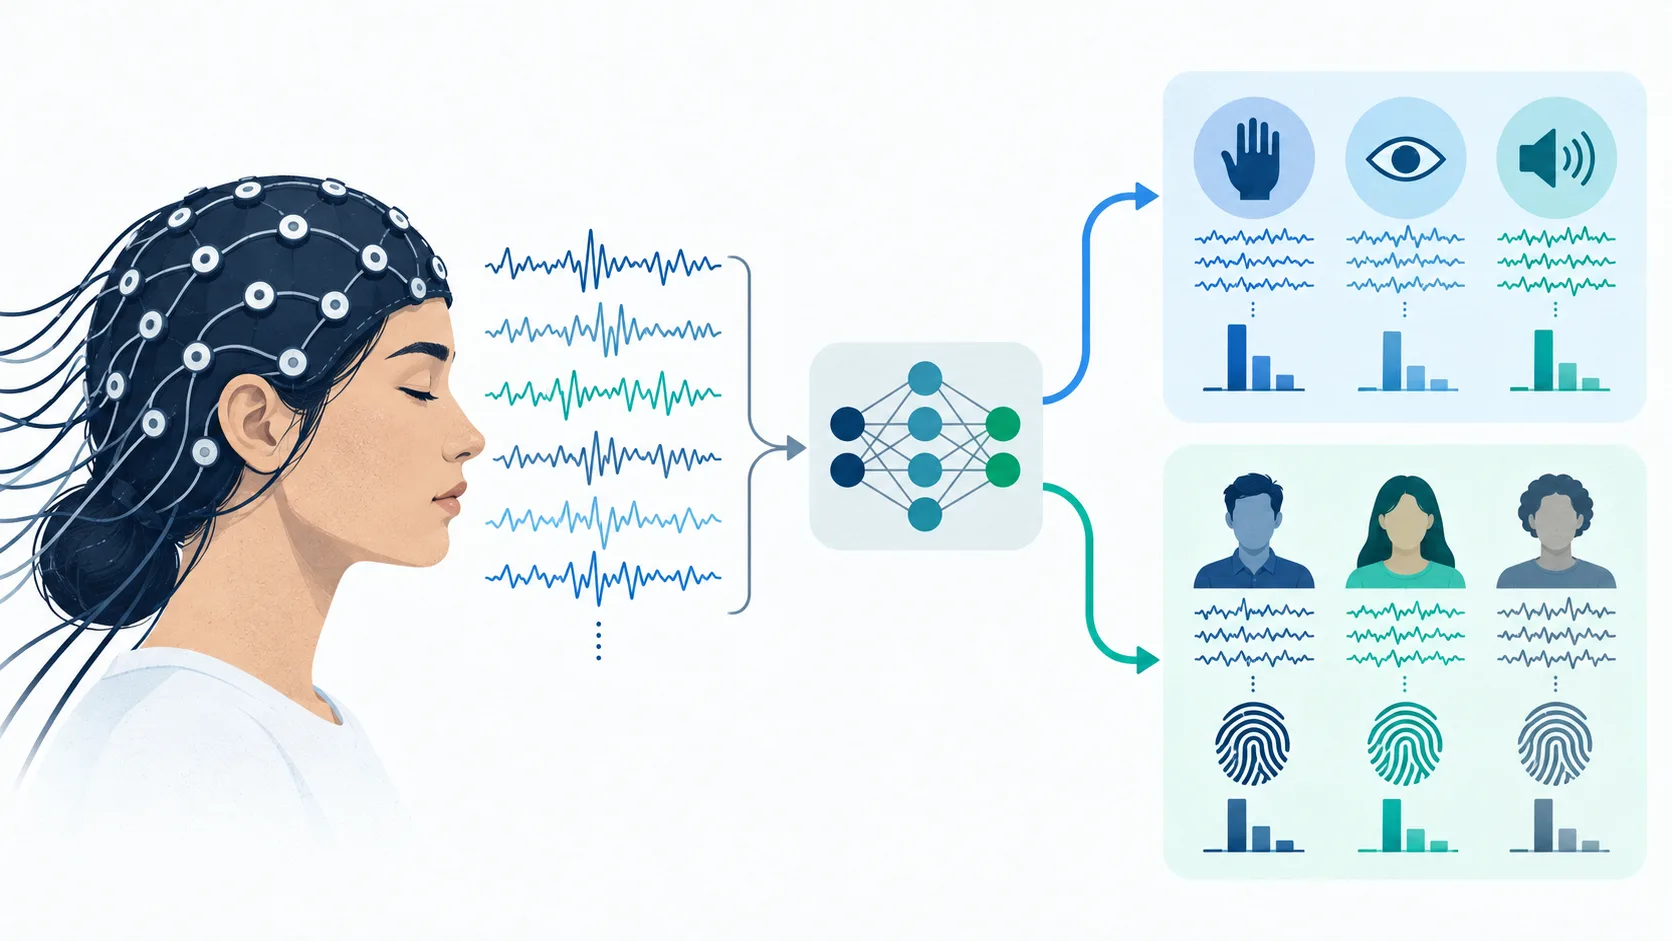
在实施EEG机器学习流程时,如果同一受试者同时出现在训练集和测试集中,将数据随机划分为窗口可能会产生误导性的乐观结果。这种方法无法检验模型对新受试者的真正泛化能力,因为模型可能学习的是受试者特有的模式,而非与任务相关的信号。该问题不仅限于EEG,也适用于任何存在同一来源重复测量的领域,例如可穿戴传感器或行为数据。
在本研究中,研究人员复现了一个简单的EEG实验,使用频谱特征和三种标准机器学习算法,比较背景任务和心算任务的数据。他们对比了随机窗口划分与按受试者留出的评估方式,后者将某一受试者的所有窗口只分配给训练集或测试集之一。所用数据集为Physio Net的心算任务EEG数据集(EEGMAT),包含36条记录(18名受试者,每人有背景和心算两段记录)。经过滤波和加窗处理后,共提取2,134个4秒窗口,其中1,594个为背景窗口,540个为心算窗口,并在19个EEG通道上计算四个频段的相对功率,每个窗口得到76个特征。该分析旨在分离评估方法本身的影响,而非开发新的生物标志物,因此采用常规特征,并控制了类别平衡和特征判别性。
结果表明,按受试者感知的评估方式显著改变了性能估计值。研究发现,当存在受试者特异性结构时,标准的随机划分会高估模型的泛化能力。
来源: Towards Data Science · 由HeadlinesBriefing整理摘要