
向聊天机器人索要1到100之间的随机数时,答案很少是均匀分布的。语言模型会反复偏爱少数几个数值,而当模型的选择用于保护某些秘密时,这种习惯会带来实际影响。
本分析从安全角度看待这一问题:如果模型选择的是守护秘密的数字,攻击者需要多少次猜测?作者并不是统计多次采样运行中的答案,而是直接从模型的logits中读取模型为1到100每个数值分配的概率。根据这100个概率,分析计算出随机性的比特数以及破解该选择所需的预期猜测次数。研究还将基础模型与其指令微调版本进行并排比较,以判断这种习惯来自预训练还是后训练。
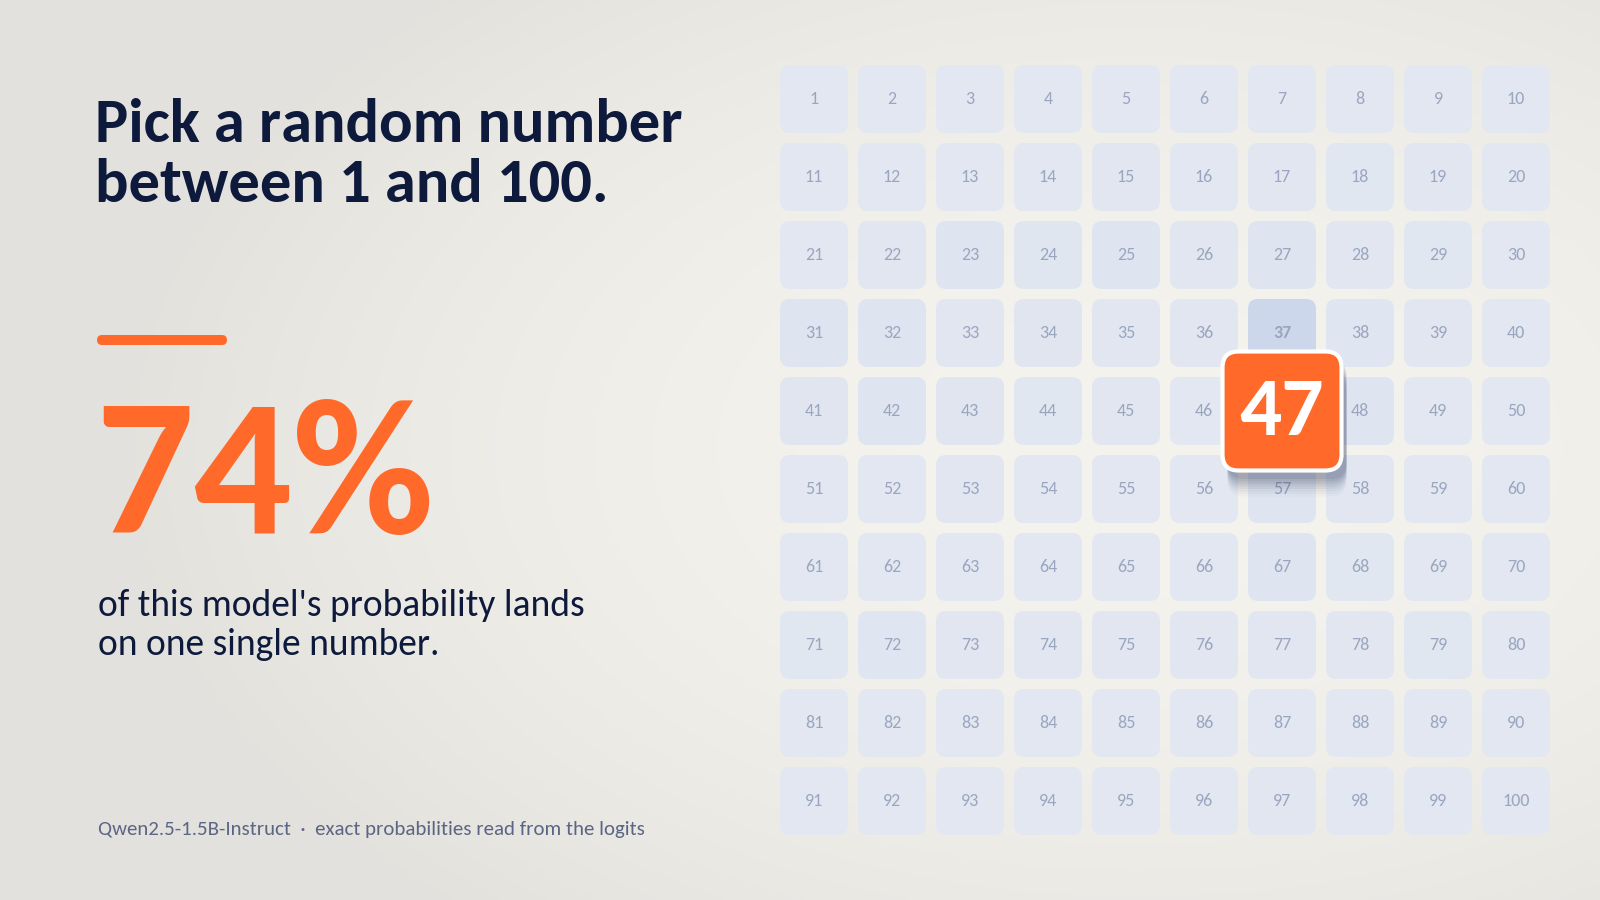
核心发现十分醒目。在使用纯文本提示时,一个15亿参数的指令微调模型大约四次中有三次选择了47。即使改写提示词,它仍有超过三分之一的概率选择47。
早期研究也记录了同样的模式。一项涵盖六个模型、七种语言的采样研究报告了包括37、47和73在内的热门选择,并将这种偏差与人类的倾向联系起来。一项2022年对OpenAI模型的非正式比较发现,基础模型较为均匀,而经过调优的模型则有一个明显的偏爱数值。关于微调阶段的研究也发现,基于人类反馈的强化学习会显著降低输出的多样性。
由于开放的模型检查点现在允许任何人重复这一读取过程,作者能够追踪每个后训练阶段中的选择变化。对于依赖模型生成“随机”数值的人来说,结论很明确:一个可预测的偏爱选项可以被迅速破解。
来源: Towards Data Science · 由HeadlinesBriefing整理摘要