
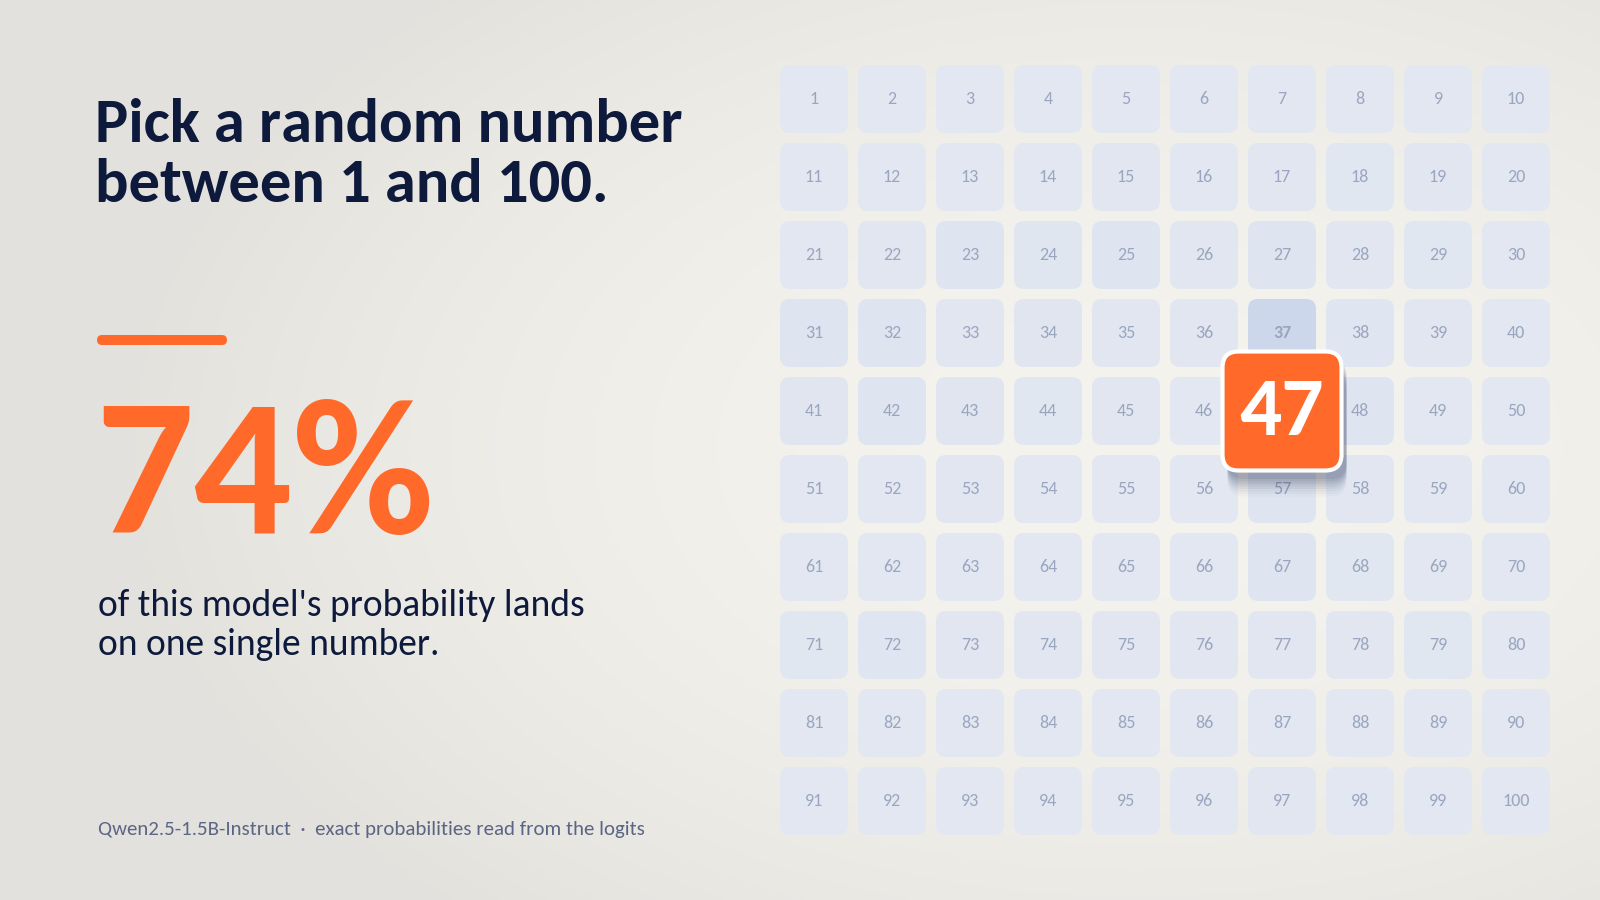
किसी चैटबॉट से 1 से 100 के बीच एक रैंडम नंबर माँगें, तो उसका उत्तर शायद ही कभी समान रूप से वितरित होता है। भाषा मॉडल बार-बार कुछ ही मानों को प्राथमिकता देते हैं, और जब किसी मॉडल की चुनी हुई संख्या किसी चीज़ की सुरक्षा के लिए हो, तो इस आदत के वास्तविक परिणाम होते हैं।
यह विश्लेषण इस प्रश्न को सुरक्षा के नज़रिए से देखता है: यदि कोई मॉडल वह संख्या चुनता है जो किसी गुप्त जानकारी की रक्षा करती है, तो हमलावर को कितने अनुमानों की आवश्यकता होगी? कई नमूना-रनों में उत्तरों की गिनती करने के बजाय, लेखक मॉडल के लॉजिट्स से सीधे 1 से 100 तक हर मान को दी गई संभावना पढ़ते हैं। इन 100 संभावनाओं से विश्लेषण यादृच्छिकता के बिट्स और चुनाव को तोड़ने के लिए अपेक्षित अनुमानों की संख्या की गणना करता है। यह देखने के लिए कि यह आदत प्रीट्रेनिंग से आती है या पोस्ट-ट्रेनिंग से, बेस मॉडल और उनके निर्देश-ट्यून किए गए संस्करणों की साथ-साथ तुलना की जाती है।
मुख्य निष्कर्ष स्पष्ट है। सादे-पाठ प्रॉम्प्ट के साथ, 1.5 अरब पैरामीटर वाले एक निर्देश-ट्यून्ड मॉडल ने लगभग चार में से तीन बार 47 चुना। प्रॉम्प्ट के शब्द बदलने पर भी वह एक-तिहाई से अधिक बार 47 चुनता रहा।
पहले के अध्ययनों में भी यही पैटर्न दर्ज हुआ है। छह मॉडलों और सात भाषाओं पर किए गए एक नमूना-अध्ययन ने 37, 47 और 73 जैसे पसंदीदा मान बताए और इस पूर्वाग्रह को मानवीय प्रवृत्तियों से जोड़ा। OpenAI मॉडलों की 2022 की एक अनौपचारिक तुलना में एक अधिक समान बेस मॉडल और एक ट्यून्ड मॉडल मिला जिसका एक तीखा पसंदीदा मान था। फाइन-ट्यूनिंग चरणों पर हुए शोध में भी पाया गया है कि मानव फ़ीडबैक से रीइनफोर्समेंट लर्निंग आउटपुट की विविधता को काफी कम कर देती है।
चूँकि अब खुले चेकपॉइंट्स के कारण कोई भी यह रीडआउट दोहरा सकता है, लेखक हर पोस्ट-ट्रेनिंग चरण के माध्यम से चुनाव का अनुसरण कर सकते हैं। जो लोग मॉडल द्वारा बनाए गए "रैंडम" मान पर निर्भर हैं, उनके लिए निष्कर्ष स्पष्ट है: एक अनुमानित पसंदीदा मान को जल्दी तोड़ा जा सकता है।
स्रोत: Towards Data Science · HeadlinesBriefing द्वारा सारांशित