
কোনো চ্যাটবটকে ১ থেকে ১০০-এর মধ্যে একটি র্যান্ডম সংখ্যা চাইলে উত্তর খুব কমই সমানভাবে বণ্টিত হয়। ভাষা মডেলগুলি বারবার কয়েকটি মানকেই পছন্দ করে, এবং যখন কোনো মডেলের বাছাই কিছু সুরক্ষার জন্য হয়, তখন এই অভ্যাসের বাস্তব প্রভাব থাকে।
এই বিশ্লেষণ প্রশ্নটিকে নিরাপত্তার দৃষ্টিকোণ থেকে দেখে: যদি কোনো মডেল কোনো গোপন তথ্য রক্ষাকারী সংখ্যাটি বেছে নেয়, তবে একজন আক্রমণকারীর কতবার অনুমান করতে হবে? বহু নমুনা-চালনায় উত্তর গণনা না করে লেখক সরাসরি মডেলের লজিট থেকে ১ থেকে ১০০-এর প্রতিটি মানের জন্য নির্ধারিত সম্ভাব্যতা পড়েন। এই ১০০টি সম্ভাব্যতা থেকে বিশ্লেষণটি র্যান্ডমনেসের বিট এবং বাছাইটি ভাঙতে প্রত্যাশিত অনুমানের সংখ্যা হিসাব করে। অভ্যাসটি প্রি-ট্রেনিং থেকে এসেছে, নাকি পোস্ট-ট্রেনিং থেকে, তা জানতে বেস মডেল এবং নির্দেশনা-টিউন করা সংস্করণগুলি পাশাপাশি তুলনা করা হয়।
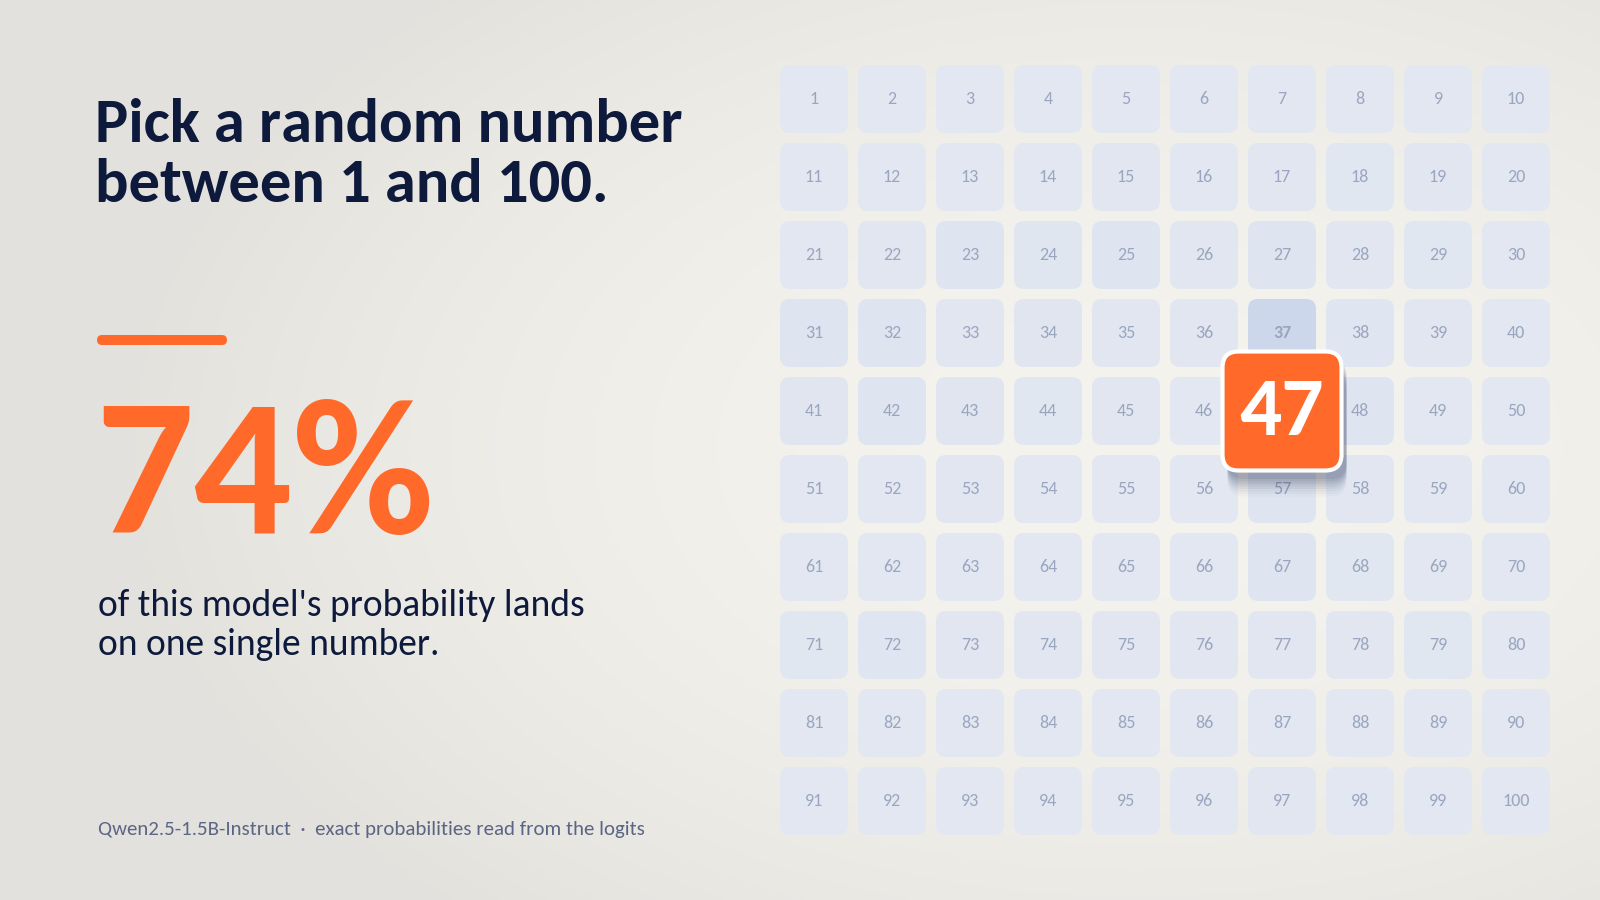
মূল ফলাফলটি স্পষ্ট। সাধারণ টেক্সট প্রম্পটে, ১.৫ বিলিয়ন প্যারামিটারের একটি নির্দেশনা-টিউন করা মডেল প্রায় চার বারে তিন বার 47 বেছে নিয়েছে। প্রম্পটের শব্দ বদলালেও এটি এক-তৃতীয়াংশের বেশি সময় 47 বেছে নেয়।
আগের গবেষণাতেও একই ধরন লক্ষ্য করা গেছে। ছয়টি মডেল ও সাতটি ভাষা জুড়ে একটি নমুনা-গবেষণায় 37, 47 ও 73-এর মতো প্রিয় মান পাওয়া গেছে এবং এই পক্ষপাতকে মানুষের প্রবণতার সঙ্গে যুক্ত করা হয়েছে। OpenAI মডেলগুলির ২০২২ সালের একটি অনানুষ্ঠানিক তুলনায় একটি অধিকতর সমরূপ বেস মডেল এবং একটি টিউন করা মডেল পাওয়া গেছে যার একটি তীব্র প্রিয় মান ছিল। ফাইন-টিউনিং পর্যায় নিয়ে গবেষণায় দেখা গেছে, মানুষের প্রতিক্রিয়া থেকে রিইনফোর্সমেন্ট লার্নিং আউটপুটের বৈচিত্র্য উল্লেখযোগ্যভাবে কমিয়ে দেয়।
খোলা চেকপয়েন্ট থাকায় এখন যে কেউ এই পাঠ পুনরাবৃত্তি করতে পারেন, তাই লেখক প্রতিটি পোস্ট-ট্রেনিং পর্যায়ে বাছাইটি অনুসরণ করতে পারেন। যারা মডেল-তৈরি "র্যান্ডম" মানের উপর নির্ভর করেন, তাদের জন্য শিক্ষা স্পষ্ট: একটি অনুমানযোগ্য প্রিয় মান দ্রুত ভাঙা যায়।
উৎস: Towards Data Science · সারাংশ: HeadlinesBriefing