
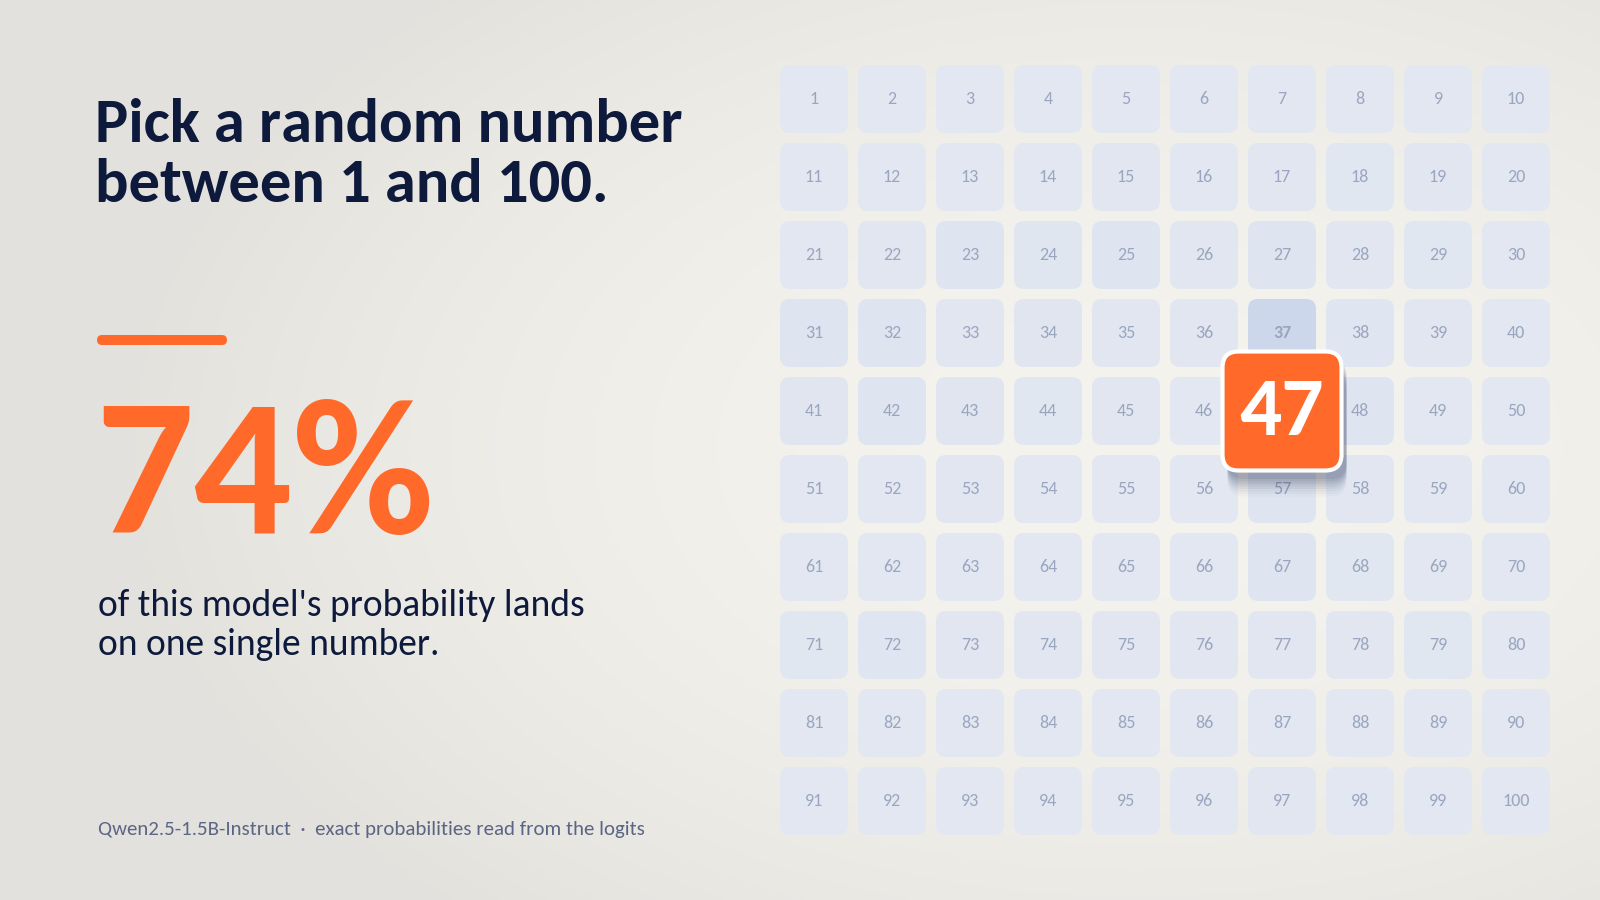
チャットボットに1から100の間で乱数を尋ねても、答えが均等に分布することはほとんどありません。言語モデルは繰り返し少数の値を好み、その傾向はモデルの選択が何かを守るためのものである場合、現実的な影響をもたらします。
この分析はセキュリティの観点からこの問題を検討します。モデルが秘密を守る数字を選ぶとしたら、攻撃者には何回の推測が必要でしょうか。多数のサンプリング実行で回答を数える代わりに、著者はモデルのロジットから1から100までの各値に割り当てられた確率を直接読み取ります。これらの100個の確率から、分析はランダム性のビット数と、選択を破るために必要な推測回数の期待値を算出します。この傾向が事前学習によるものか、事後学習によるものかを確かめるため、ベースモデルと指示調整済みのバージョンを並べて比較しています。
主要な発見は鮮明です。平文のプロンプトでは、15億パラメータの指示調整済みモデルが47を約4回に3回選びました。言い回しを変えたプロンプトでも、3分の1以上の割合で47を選び続けました。
以前の研究でも同様のパターンが報告されています。6つのモデルと7つの言語にわたるサンプリング研究では、37、47、73などの好まれる値が報告され、この偏りが人間の傾向と関連づけられました。2022年のOpenAIモデルの非公式な比較では、より均一なベースモデルと、特定の値に強く偏ったチューニング済みモデルが見つかりました。ファインチューニングの段階に関する研究でも、人間のフィードバックによる強化学習が出力の多様性を大きく低下させることがわかっています。
現在はオープンなチェックポイントによって誰でもこの読み取りを再現できるため、著者は事後学習の各段階を通じて選択を追跡できます。モデルが生成した「ランダム」な値に頼る人にとっての結論は明確です。予測可能なお気に入りの値は、すぐに破られてしまう可能性があります。
出典: Towards Data Science · 要約:HeadlinesBriefing