
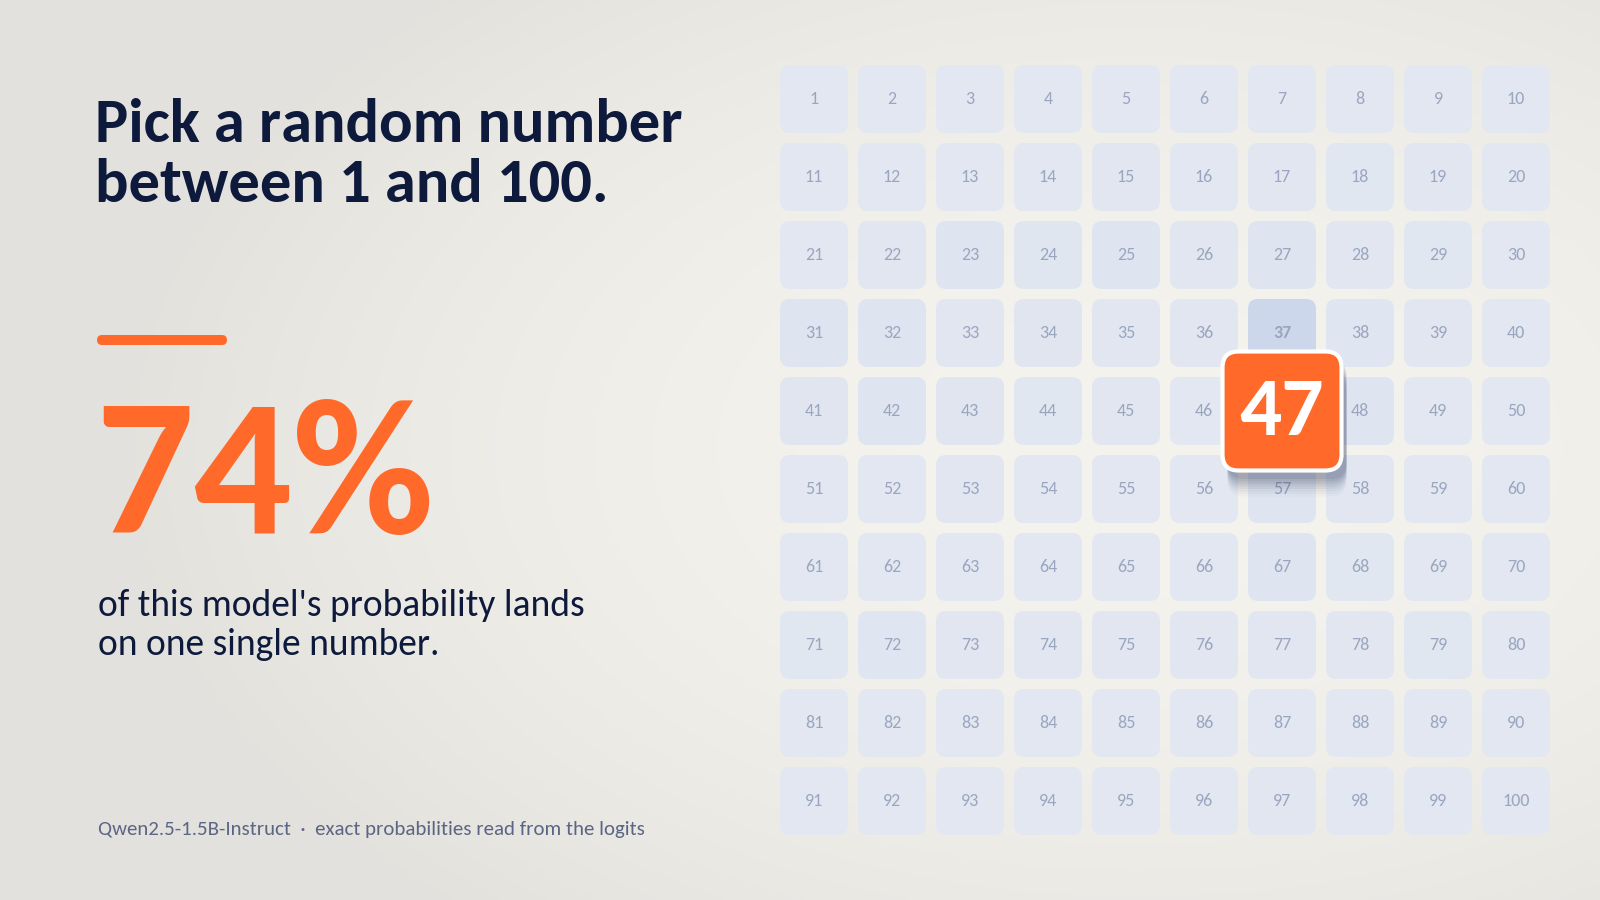
Pide a un chatbot un número aleatorio entre 1 y 100 y la respuesta rara vez será uniforme. Los modelos de lenguaje favorecen repetidamente unos pocos valores, y ese hábito tiene implicaciones reales cuando la elección de un modelo sirve para proteger algo.
Este análisis aborda la cuestión desde una perspectiva de seguridad: si un modelo elige el número que protege un secreto, ¿cuántos intentos necesita un atacante? En lugar de contar respuestas en muchas ejecuciones muestreadas, el autor lee directamente de los logits del modelo la probabilidad asignada a cada valor del 1 al 100. A partir de esas 100 probabilidades, el análisis calcula los bits de aleatoriedad y el número esperado de intentos necesarios para descifrar la elección. Se comparan modelos base y sus versiones ajustadas por instrucciones para determinar si el hábito proviene del preentrenamiento o del posentrenamiento.
El hallazgo principal es contundente. Con un prompt de texto simple, un modelo de 1.500 millones de parámetros ajustado por instrucciones eligió 47 alrededor de tres veces de cada cuatro. Con un prompt reformulado, seguía seleccionando el 47 más de un tercio de las veces.
Estudios anteriores documentaron el mismo patrón. Un estudio de muestreo sobre seis modelos y siete idiomas informó de favoritos como 37, 47 y 73, y vinculó el sesgo con tendencias humanas. Una comparación informal de 2022 de modelos de OpenAI encontró un modelo base más uniforme y un modelo ajustado con un favorito muy marcado. Las investigaciones sobre las fases de ajuste fino también han constatado que el aprendizaje por refuerzo a partir de retroalimentación humana reduce significativamente la diversidad de las respuestas.
Como los puntos de control abiertos permiten ahora que cualquiera repita la lectura, el autor puede rastrear la elección a lo largo de cada fase de posentrenamiento. Para quien depende de un valor «aleatorio» generado por un modelo, la conclusión es clara: un favorito predecible puede descifrarse rápidamente.
Fuente: Towards Data Science · Resumido por HeadlinesBriefing