
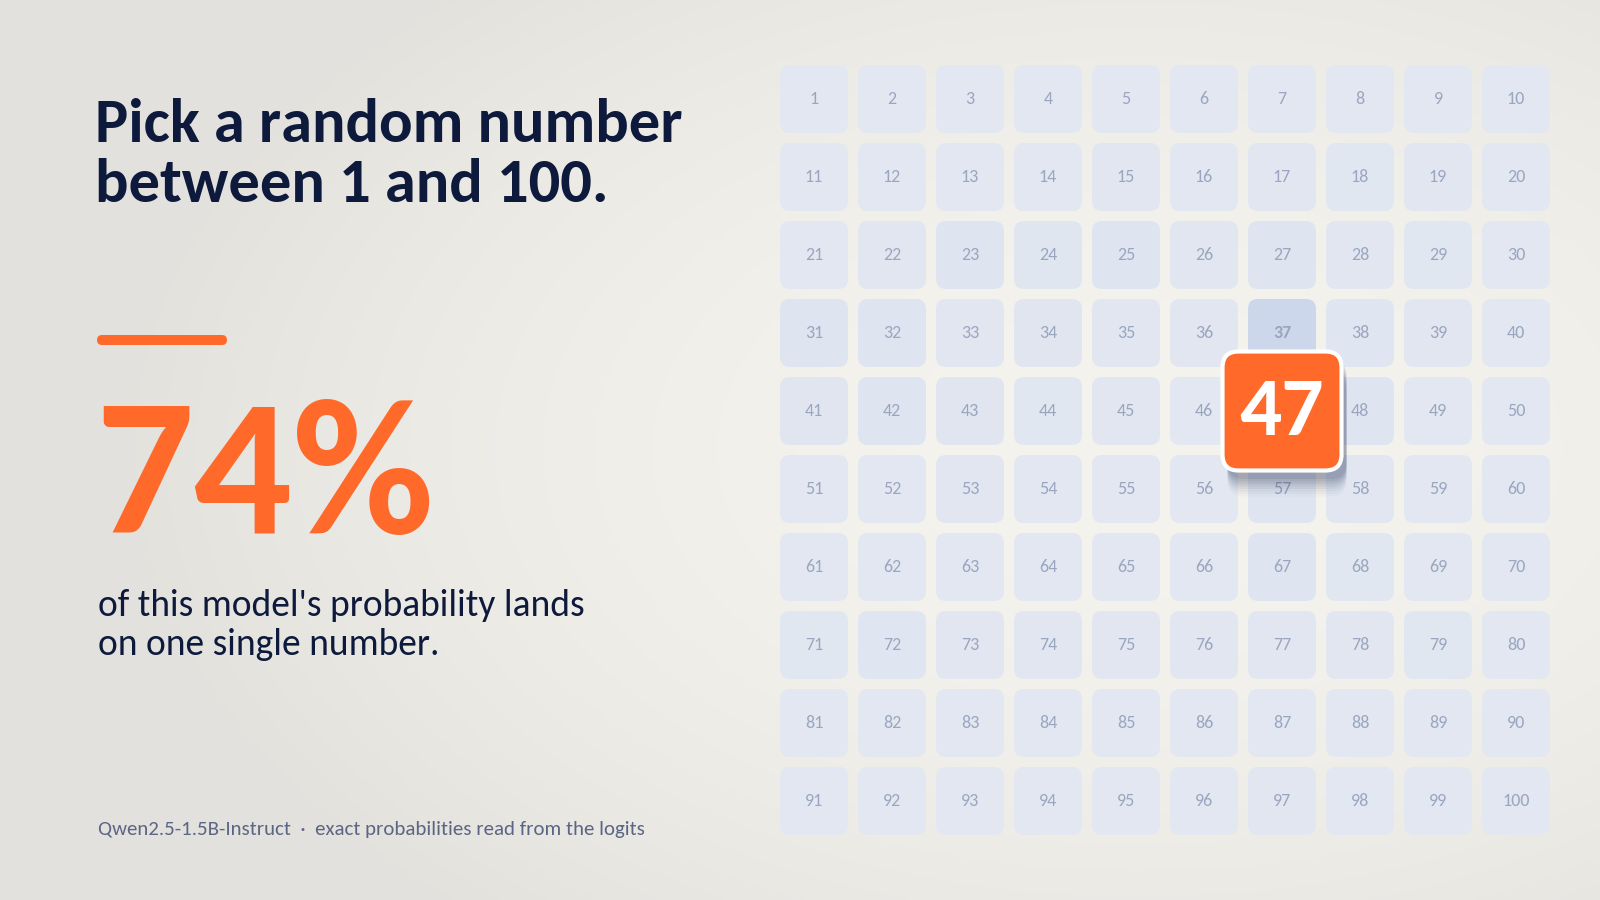
اطلب من روبوت محادثة رقمًا عشوائيًا بين 1 و100، وقلّما تكون الإجابة موزعة بالتساوي. فنماذج اللغة تميل مرارًا إلى تفضيل عدد قليل من القيم، وهذه العادة لها تبعات حقيقية عندما يكون اختيار النموذج مخصصًا لحماية شيء ما.
يتناول هذا التحليل المسألة من منظور أمني: إذا اختار النموذج الرقم الذي يحمي سرًا ما، فكم عدد التخمينات التي يحتاجها المهاجم؟ وبدلًا من عدّ الإجابات عبر عدة تشغيلات عينية، يقرأ الكاتب احتمال كل قيمة من 1 إلى 100 مباشرة من قيم اللوجيت (logits) في النموذج. ومن هذه الاحتمالات المئة يحسب التحليل بتات العشوائية وعدد التخمينات المتوقع لكسر الاختيار. وتُقارن النماذج الأساسية ونسخها المضبوطة على التعليمات جنبًا إلى جنب لمعرفة ما إذا كانت هذه العادة نابعة من التدريب المسبق أم من التدريب اللاحق.
النتيجة الرئيسية صارخة. فمع موجّه نصي بسيط، اختار نموذج مضبوط على التعليمات بحجم 1.5 مليار معامل الرقم 47 نحو ثلاث مرات من أصل كل أربع. ومع صياغة مختلفة للموجّه، ظل يختار 47 في أكثر من ثلث المرات.
وقد وثّقت دراسات سابقة النمط نفسه. فقد ذكرت دراسة عينية شملت ستة نماذج وسبع لغات قيمًا مفضلة مثل 37 و47 و73، وربطت هذا الانحياز بميول بشرية. أما مقارنة غير رسمية أُجريت عام 2022 لنماذج OpenAI فوجدت نموذجًا أساسيًا أكثر تجانسًا ونموذجًا مضبوطًا له قيمة مفضلة حادة. كما وجدت أبحاث حول مراحل الضبط الدقيق أن التعلم المعزز من التغذية الراجعة البشرية يقلل تنوع المخرجات بشكل ملحوظ.
ولأن نقاط التحقق المفتوحة تتيح الآن لأي شخص تكرار هذه القراءة، يستطيع الكاتب تتبع الاختيار عبر كل مرحلة من مراحل التدريب اللاحق. وبالنسبة لمن يعتمد على قيمة «عشوائية» يولّدها نموذج، فالخلاصة واضحة: يمكن كسر قيمة مفضلة يمكن التنبؤ بها بسرعة.
المصدر: Towards Data Science · لخّصه HeadlinesBriefing