
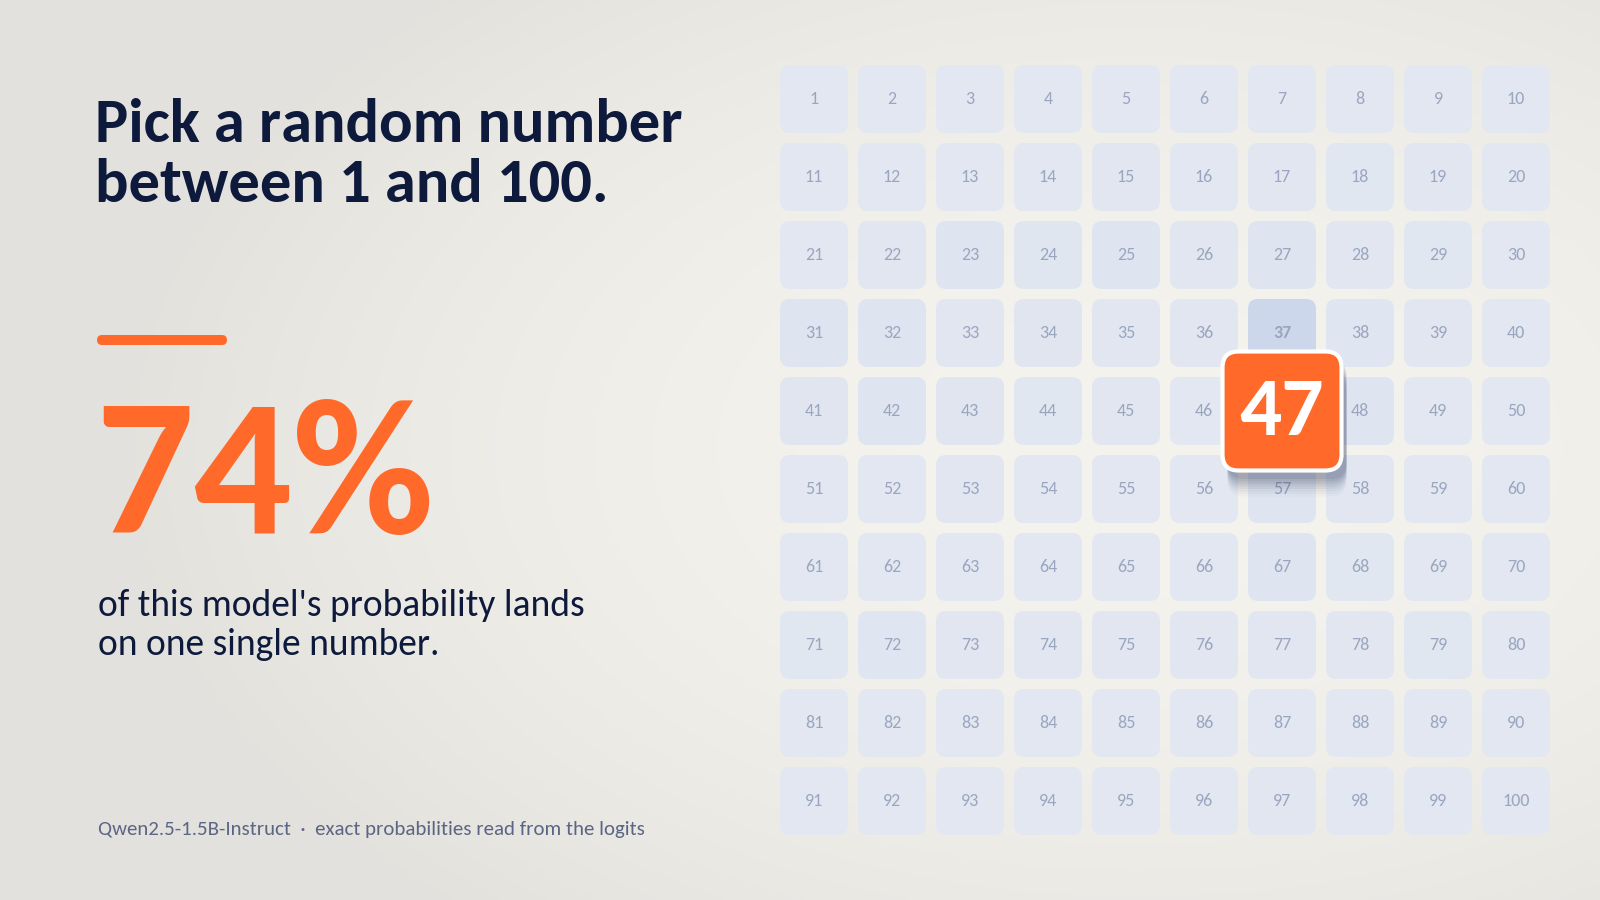
Bitten Sie einen Chatbot um eine Zufallszahl zwischen 1 und 100, und die Antwort ist selten gleichmäßig verteilt. Sprachmodelle bevorzugen immer wieder einige wenige Werte, und diese Gewohnheit hat reale Folgen, wenn die Wahl eines Modells etwas schützen soll.
Diese Analyse betrachtet die Frage aus Sicht der Sicherheit: Wenn ein Modell die Zahl wählt, die ein Geheimnis schützt, wie viele Versuche braucht ein Angreifer? Anstatt Antworten über viele Stichprobenläufe zu zählen, liest der Autor die jedem Wert von 1 bis 100 zugewiesene Wahrscheinlichkeit direkt aus den Logits des Modells ab. Aus diesen 100 Wahrscheinlichkeiten berechnet die Analyse die Zufallsbits und die erwartete Anzahl der Versuche, die nötig sind, um die Auswahl zu knacken. Basismodelle und ihre auf Anweisungen abgestimmten Versionen werden nebeneinander verglichen, um festzustellen, ob die Gewohnheit aus dem Vortraining oder dem Nachtraining stammt.
Das zentrale Ergebnis ist eindeutig. Bei einem einfachen Textprompt wählte ein auf Anweisungen abgestimmtes Modell mit 1,5 Milliarden Parametern in etwa drei von vier Fällen die 47. Auch bei einem umformulierten Prompt wählte es die 47 in mehr als einem Drittel der Fälle.
Frühere Studien dokumentierten dasselbe Muster. Eine Stichprobenstudie über sechs Modelle und sieben Sprachen nannte Favoriten wie 37, 47 und 73 und führte die Verzerrung auf menschliche Neigungen zurück. Ein informeller Vergleich von OpenAI-Modellen aus dem Jahr 2022 fand ein gleichmäßigeres Basismodell und ein abgestimmtes Modell mit einem deutlichen Favoriten. Forschung zu den Feinabstimmungsphasen hat außerdem ergeben, dass verstärkendes Lernen aus menschlichem Feedback die Vielfalt der Ausgaben deutlich verringert.
Da offene Checkpoints heute jedem erlauben, diese Auslesung zu wiederholen, kann der Autor die Wahl durch jede Phase des Nachtrainings verfolgen. Für alle, die sich auf einen vom Modell erzeugten „Zufallswert“ verlassen, ist die Schlussfolgerung klar: Ein vorhersehbarer Favorit lässt sich schnell knacken.
Quelle: Towards Data Science · Zusammengefasst von HeadlinesBriefing