
Demandez à un chatbot un nombre aléatoire entre 1 et 100 : la réponse est rarement uniforme. Les modèles de langage privilégient à plusieurs reprises quelques valeurs, et cette habitude a des conséquences réelles lorsque le choix d'un modèle est censé protéger quelque chose.
Cette analyse aborde la question sous un angle de sécurité : si un modèle choisit le nombre qui protège un secret, combien de tentatives un attaquant doit-il faire ? Plutôt que de compter les réponses sur de nombreuses exécutions échantillonnées, l'auteur lit directement dans les logits du modèle la probabilité attribuée à chaque valeur de 1 à 100. À partir de ces 100 probabilités, l'analyse calcule les bits d'aléatoire et le nombre moyen de tentatives nécessaires pour casser le choix. Les modèles de base et leurs versions ajustées aux instructions sont comparés côte à côte afin de déterminer si l'habitude provient du préentraînement ou de l'après-entraînement.
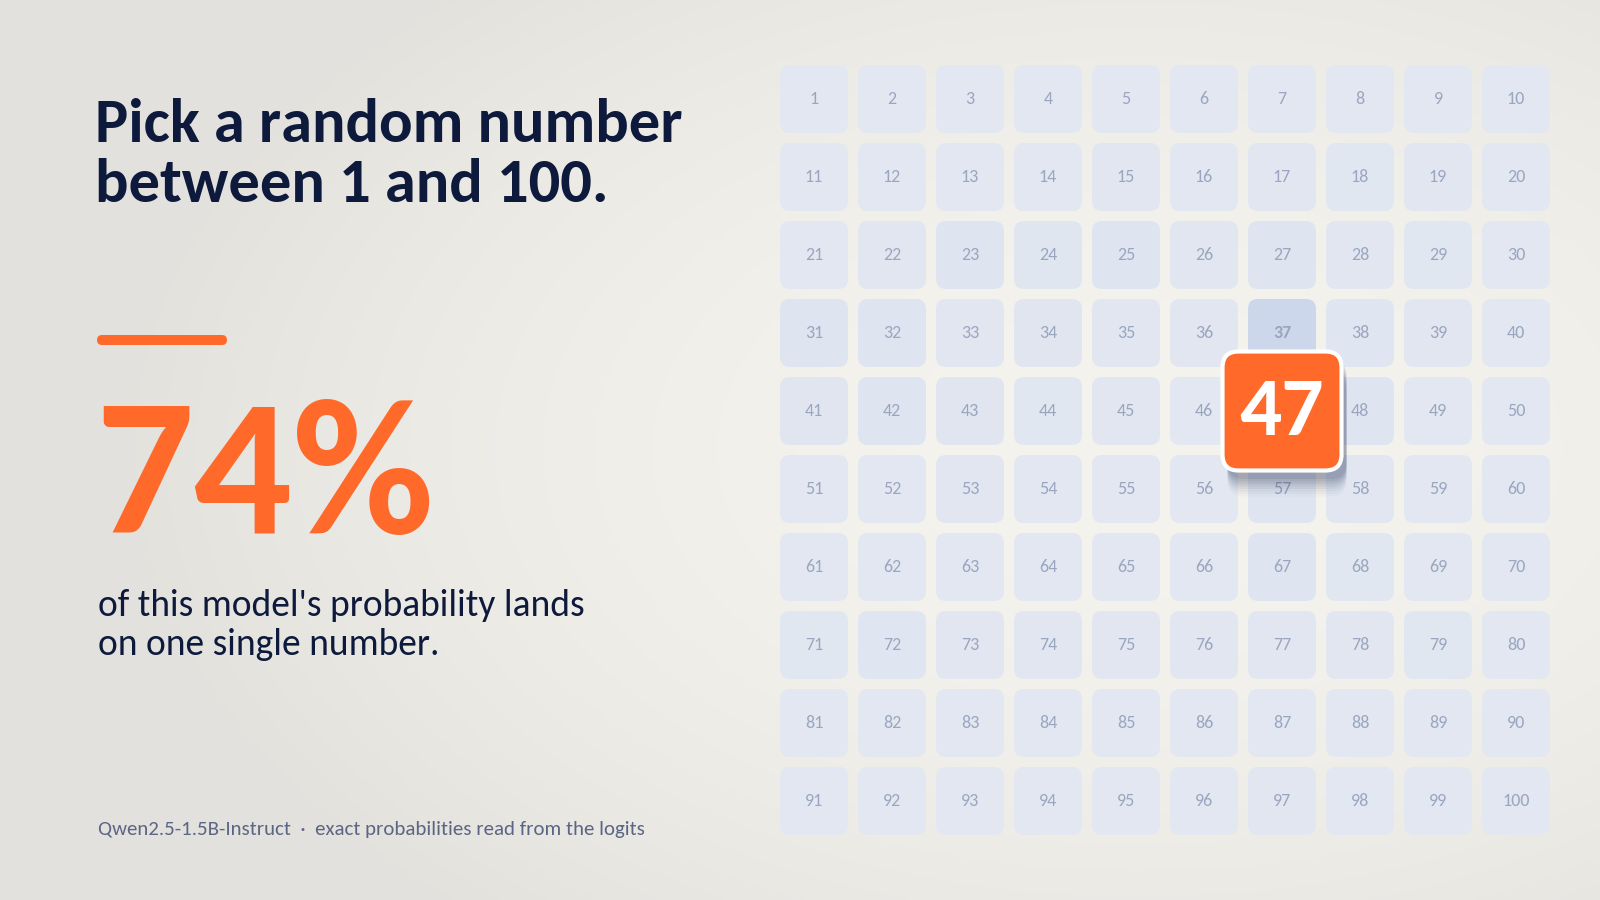
La conclusion principale est frappante. Avec une invite en texte brut, un modèle ajusté aux instructions de 1,5 milliard de paramètres a choisi 47 environ trois fois sur quatre. Avec une invite reformulée, il sélectionne encore 47 plus d'un tiers du temps.
Des études antérieures ont documenté le même schéma. Une étude par échantillonnage portant sur six modèles et sept langues a relevé des favoris tels que 37, 47 et 73, et a relié ce biais aux tendances humaines. Une comparaison informelle de 2022 des modèles d'OpenAI a trouvé un modèle de base plus uniforme et un modèle ajusté avec un favori marqué. Des travaux sur les étapes de réglage fin ont également montré que l'apprentissage par renforcement à partir de retours humains réduit sensiblement la diversité des sorties.
Dès lors que des points de contrôle ouverts permettent à chacun de reproduire cette lecture, l'auteur peut suivre le choix à travers chaque étape de l'après-entraînement. Pour quiconque s'appuie sur une valeur « aléatoire » générée par un modèle, la conclusion est claire : un favori prévisible peut être percé rapidement.
Source: Towards Data Science · Résumé par HeadlinesBriefing