
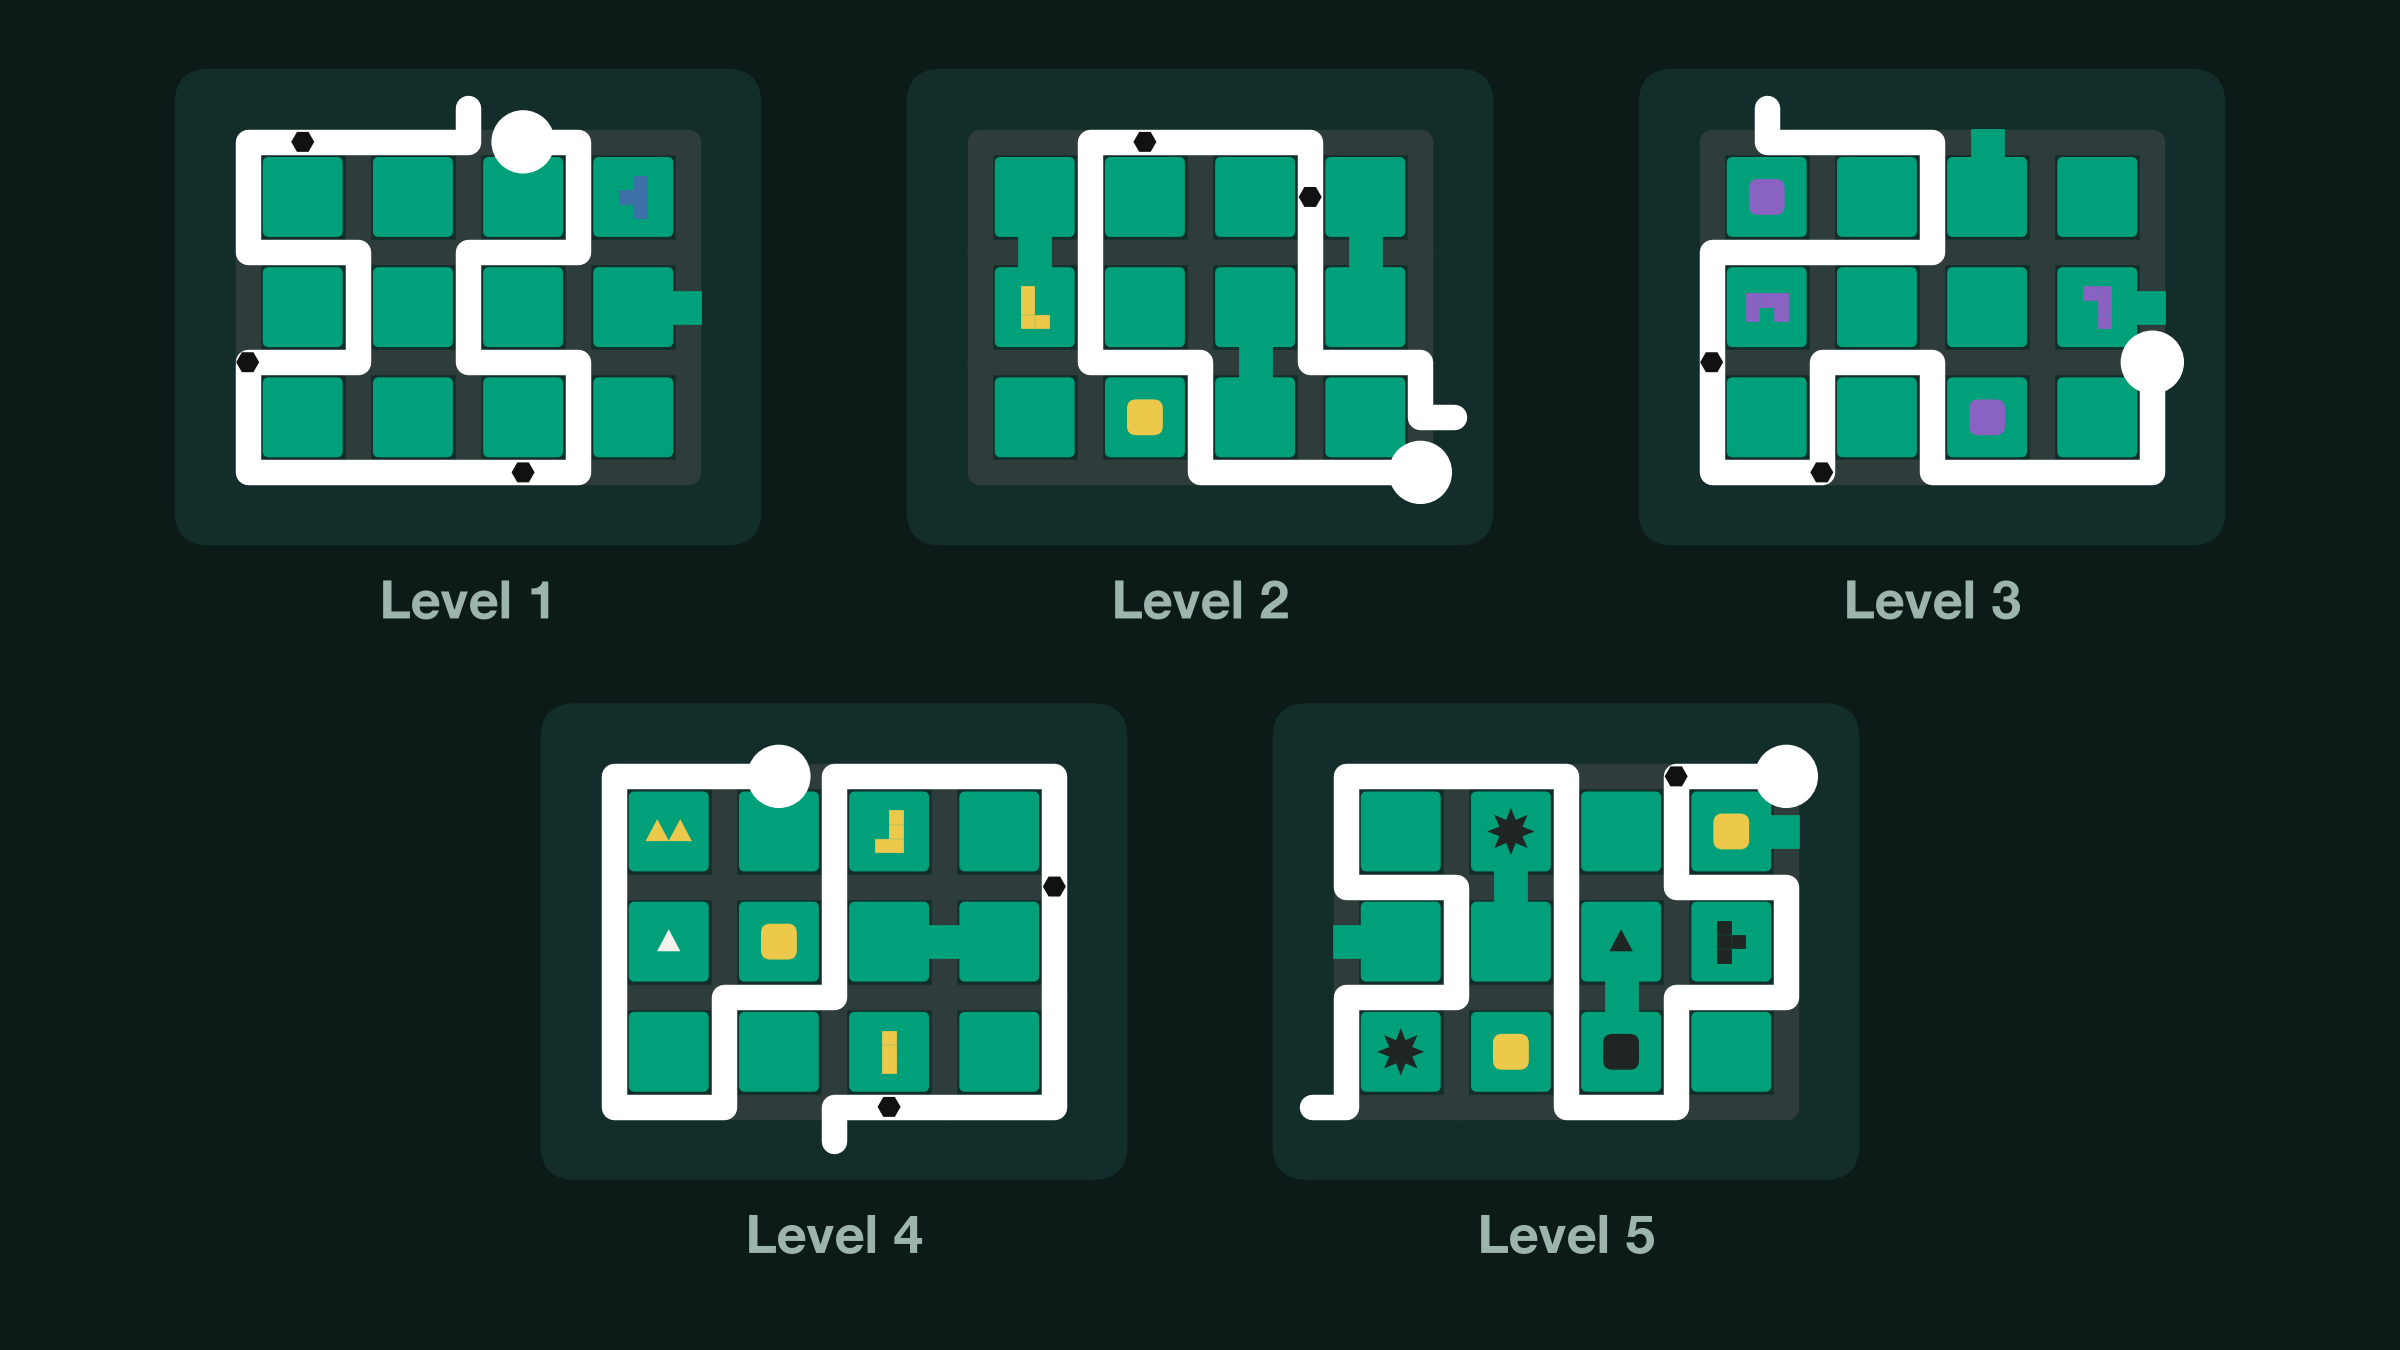
In dieser Studie lösten Menschen 98,0 % der Rasterrätsel, für ein leichtes Rätsel brauchten sie etwa 11 Sekunden und für das schwerste etwas mehr als zwei Minuten. Das beste getestete Modell, GPT-6.1 Sol, löst 83,6 % davon. Das klingt nah am Menschen, doch auf der schwersten Stufe löst es 49,4 %, während Menschen 94,5 % lösen.
Die Lösung eines dieser Rätsel erfordert mehrere getrennte Fähigkeiten, und eine einzige Genauigkeitszahl verbirgt, welche davon einem Modell fehlt. Die Forschenden teilten die Aufgabe deshalb in vier Fragen auf: Können Modelle das Spielfeld lesen, besonders aus einem Bild? Können sie ihre eigene Linie im Blick behalten? Können sie den Regeln folgen? Strengen sie sich mehr an, wenn ein Rätsel schwieriger ist? Der Beitrag stützt sich auf drei Arbeiten, darunter SPa RC, eine auf EMNLP 2025 veröffentlichte Herausforderung zum räumlichen Pfadfinden.
Jedes Rätsel ist ein Spielfeld aus grünen Feldern, die durch graue Gassen verbunden sind. Der Spieler zieht eine überschneidungsfreie Linie von einem großen Kreis am Rand zu einem Ausgangsstummel. Symbole bestimmen, welche Linien gültig sind: Punkte müssen auf der Linie liegen, Lücken blockieren Gassenabschnitte, und Steine verschiedener Farben müssen in getrennten, durch die Linie abgeschlossenen Bereichen liegen. Eine Linie, die beide Punkte passiert, aber einen violetten, einen schwarzen und einen roten Stein im selben Bereich lässt, verletzt die Steinregel, und die richtige Lösung nimmt einen längeren Weg über das Feld.
Menschen lösten die Rätsel in einer Zeichen-App, Modelle erhalten das Spielfeld meist als Textraster mit Koordinaten. Die Modelle erklären ihre Überlegungen und schreiben die Linie dann Schritt für Schritt als Liste von Positionen auf. Der vollständige Benchmark umfasst sieben Regeltypen, und die Lücke zwischen Menschen und Modellen bei den schwierigsten Rätseln zeigt, wo heutige Systeme noch Schwierigkeiten haben.
Quelle: Towards Data Science · Zusammengefasst von HeadlinesBriefing