
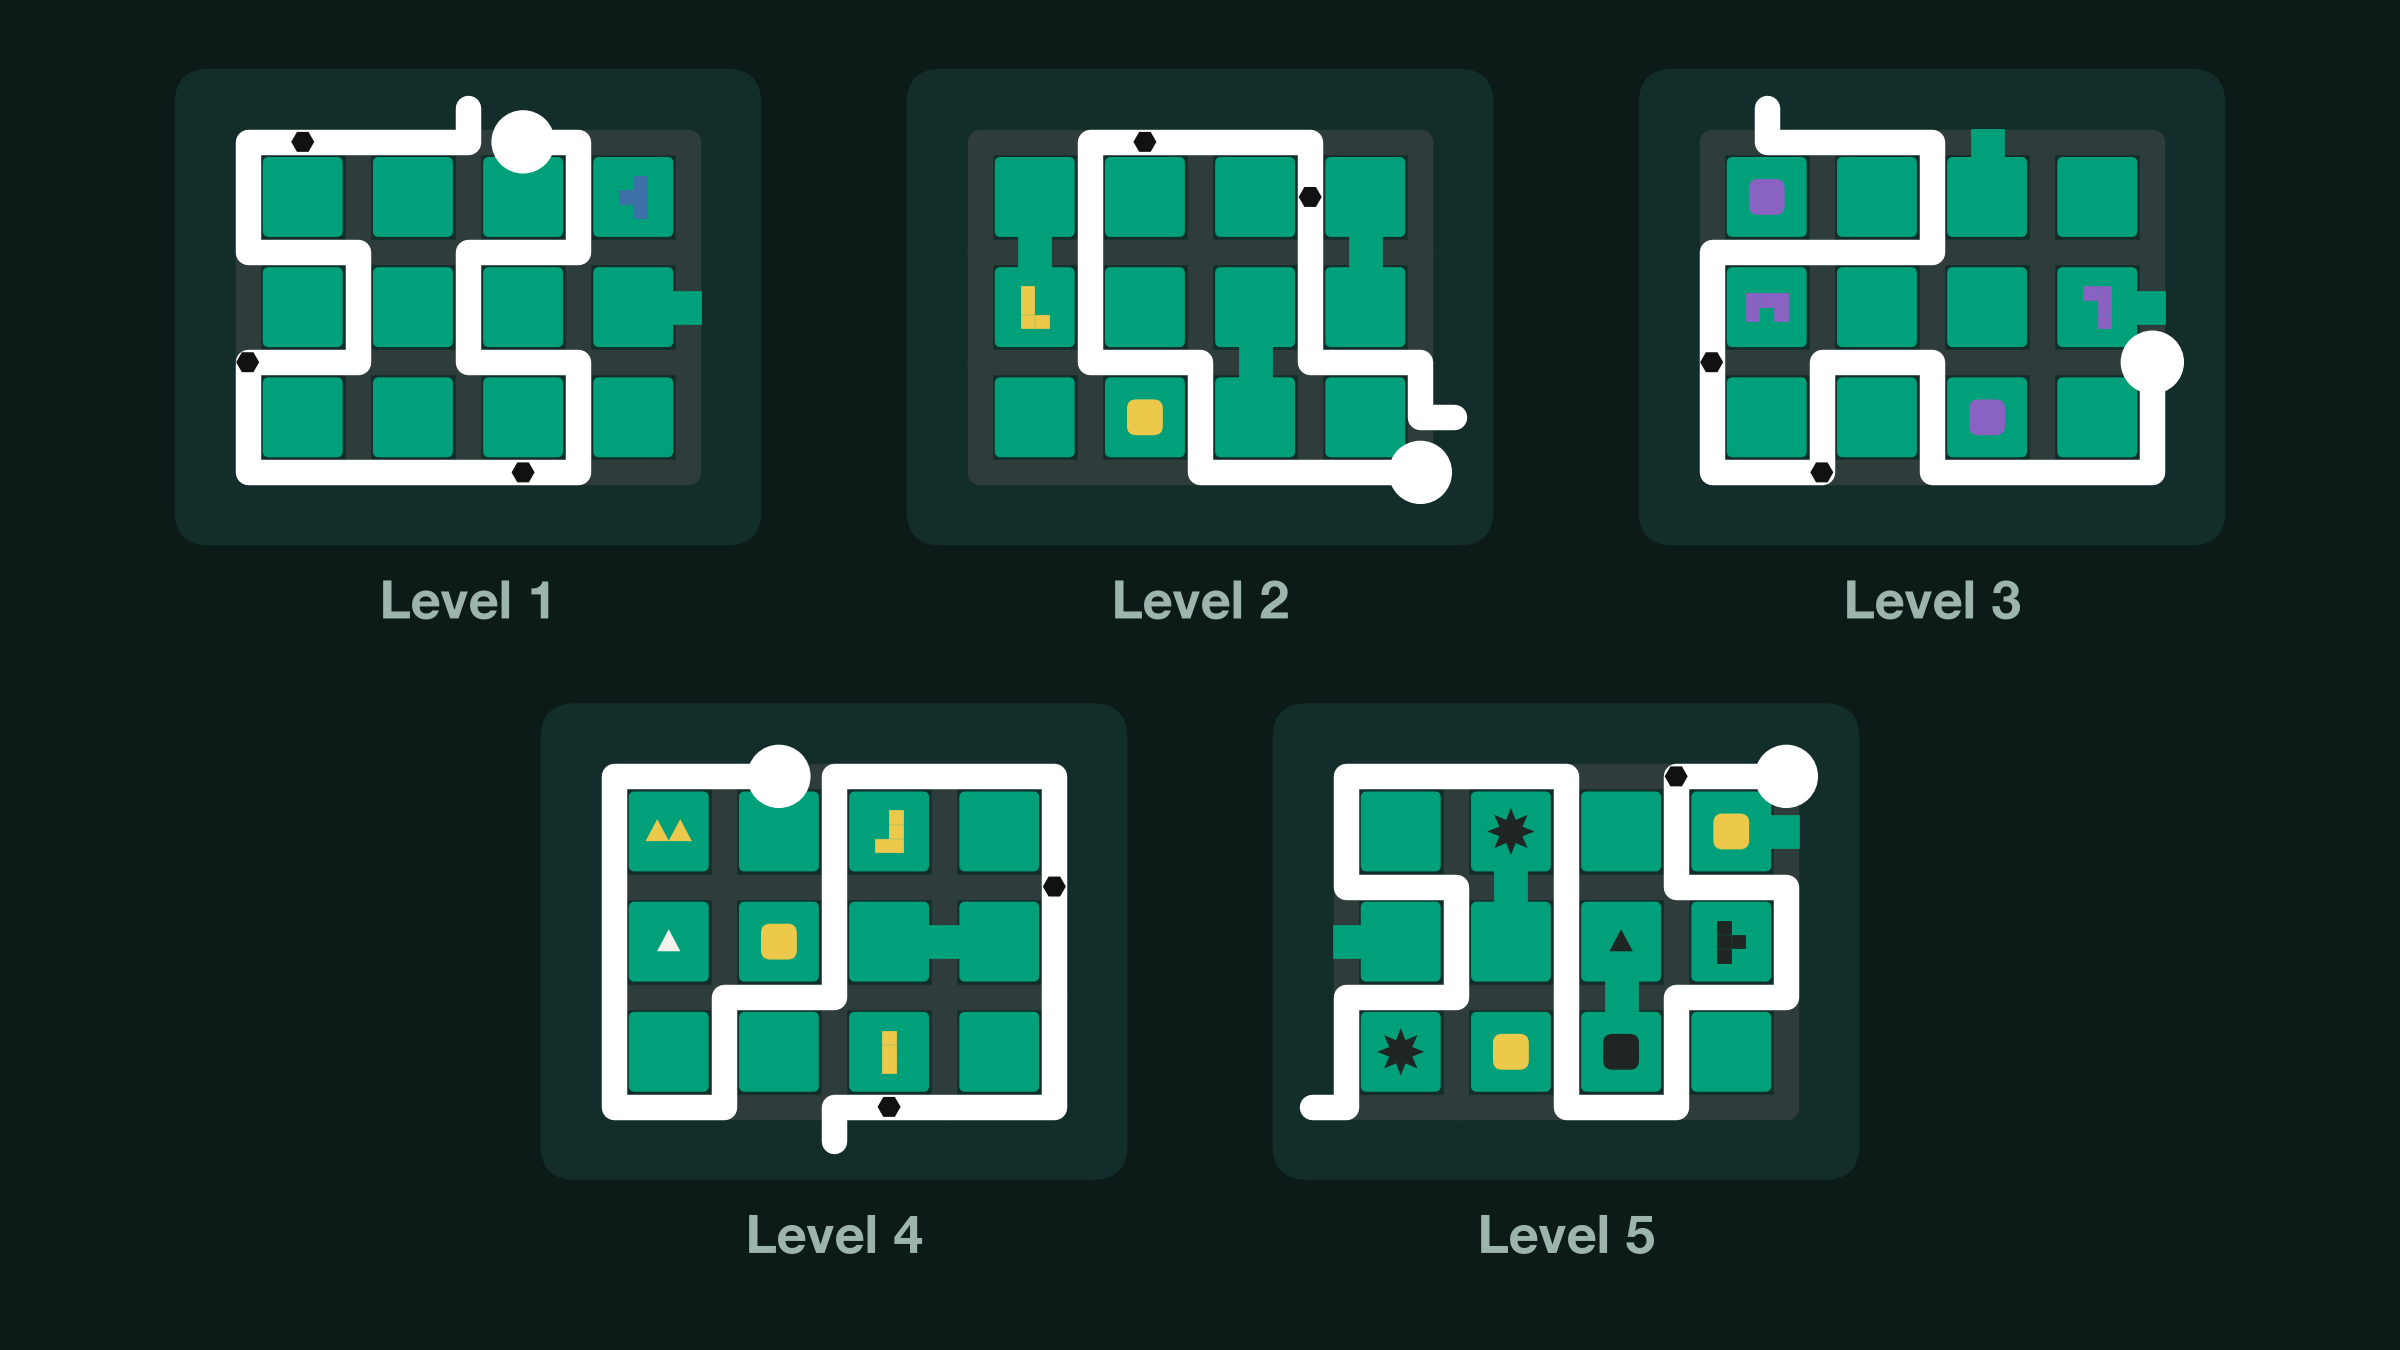
この研究では、人間がグリッドパズルの98.0%を解き、簡単なパズルには約11秒、最も難しいパズルには2分をわずかに超える時間を要しました。テストされた中で最も優れたモデルであるGPT-6.1 Solは、そのうち83.6%を解きます。これは人間に近いように聞こえますが、最も難しいレベルでは49.4%しか解けず、人間は94.5%を解いています。
こうしたパズルを解くには、いくつかの別々の能力が必要であり、単一の正答率の数値では、モデルがどの能力を欠いているのかはわかりません。そこで研究者らは、この課題を4つの問いに分けました。モデルは、特に画像から盤面を読み取れるか。自分が引いた線を把握し続けられるか。ルールに従えるか。パズルが難しくなると、より努力するか。本稿は3本の論文に基づいており、その中にはEMNLP 2025で発表された空間経路探索の推論課題SPa RCも含まれます。
どのパズルも、灰色の通路で結ばれた緑のマスからなる盤面です。プレイヤーは、縁にある大きな円から出口の突起まで、交差しない線を1本引きます。記号が有効な線を決めます。点は線上になければならず、隙間は通路の区間を遮ります。異なる色の石は、線によって閉じられた別々の領域に入っていなければなりません。2つの点を通りながら、紫、黒、赤の石を同じ領域に残してしまう線は石のルールに違反し、正しい解は盤面上のより長い経路を通ります。
人間は描画アプリでパズルを解きましたが、モデルには通常、座標付きのテキストグリッドとして盤面が与えられます。モデルは推論を説明し、そのうえで線を位置のリストとして一歩ずつ書き出します。完全なベンチマークには7種類のルールがあり、最も難しいパズルにおける人間とモデルの差は、現在のシステムがまだどこで苦戦しているかを示しています。
出典: Towards Data Science · 要約:HeadlinesBriefing