
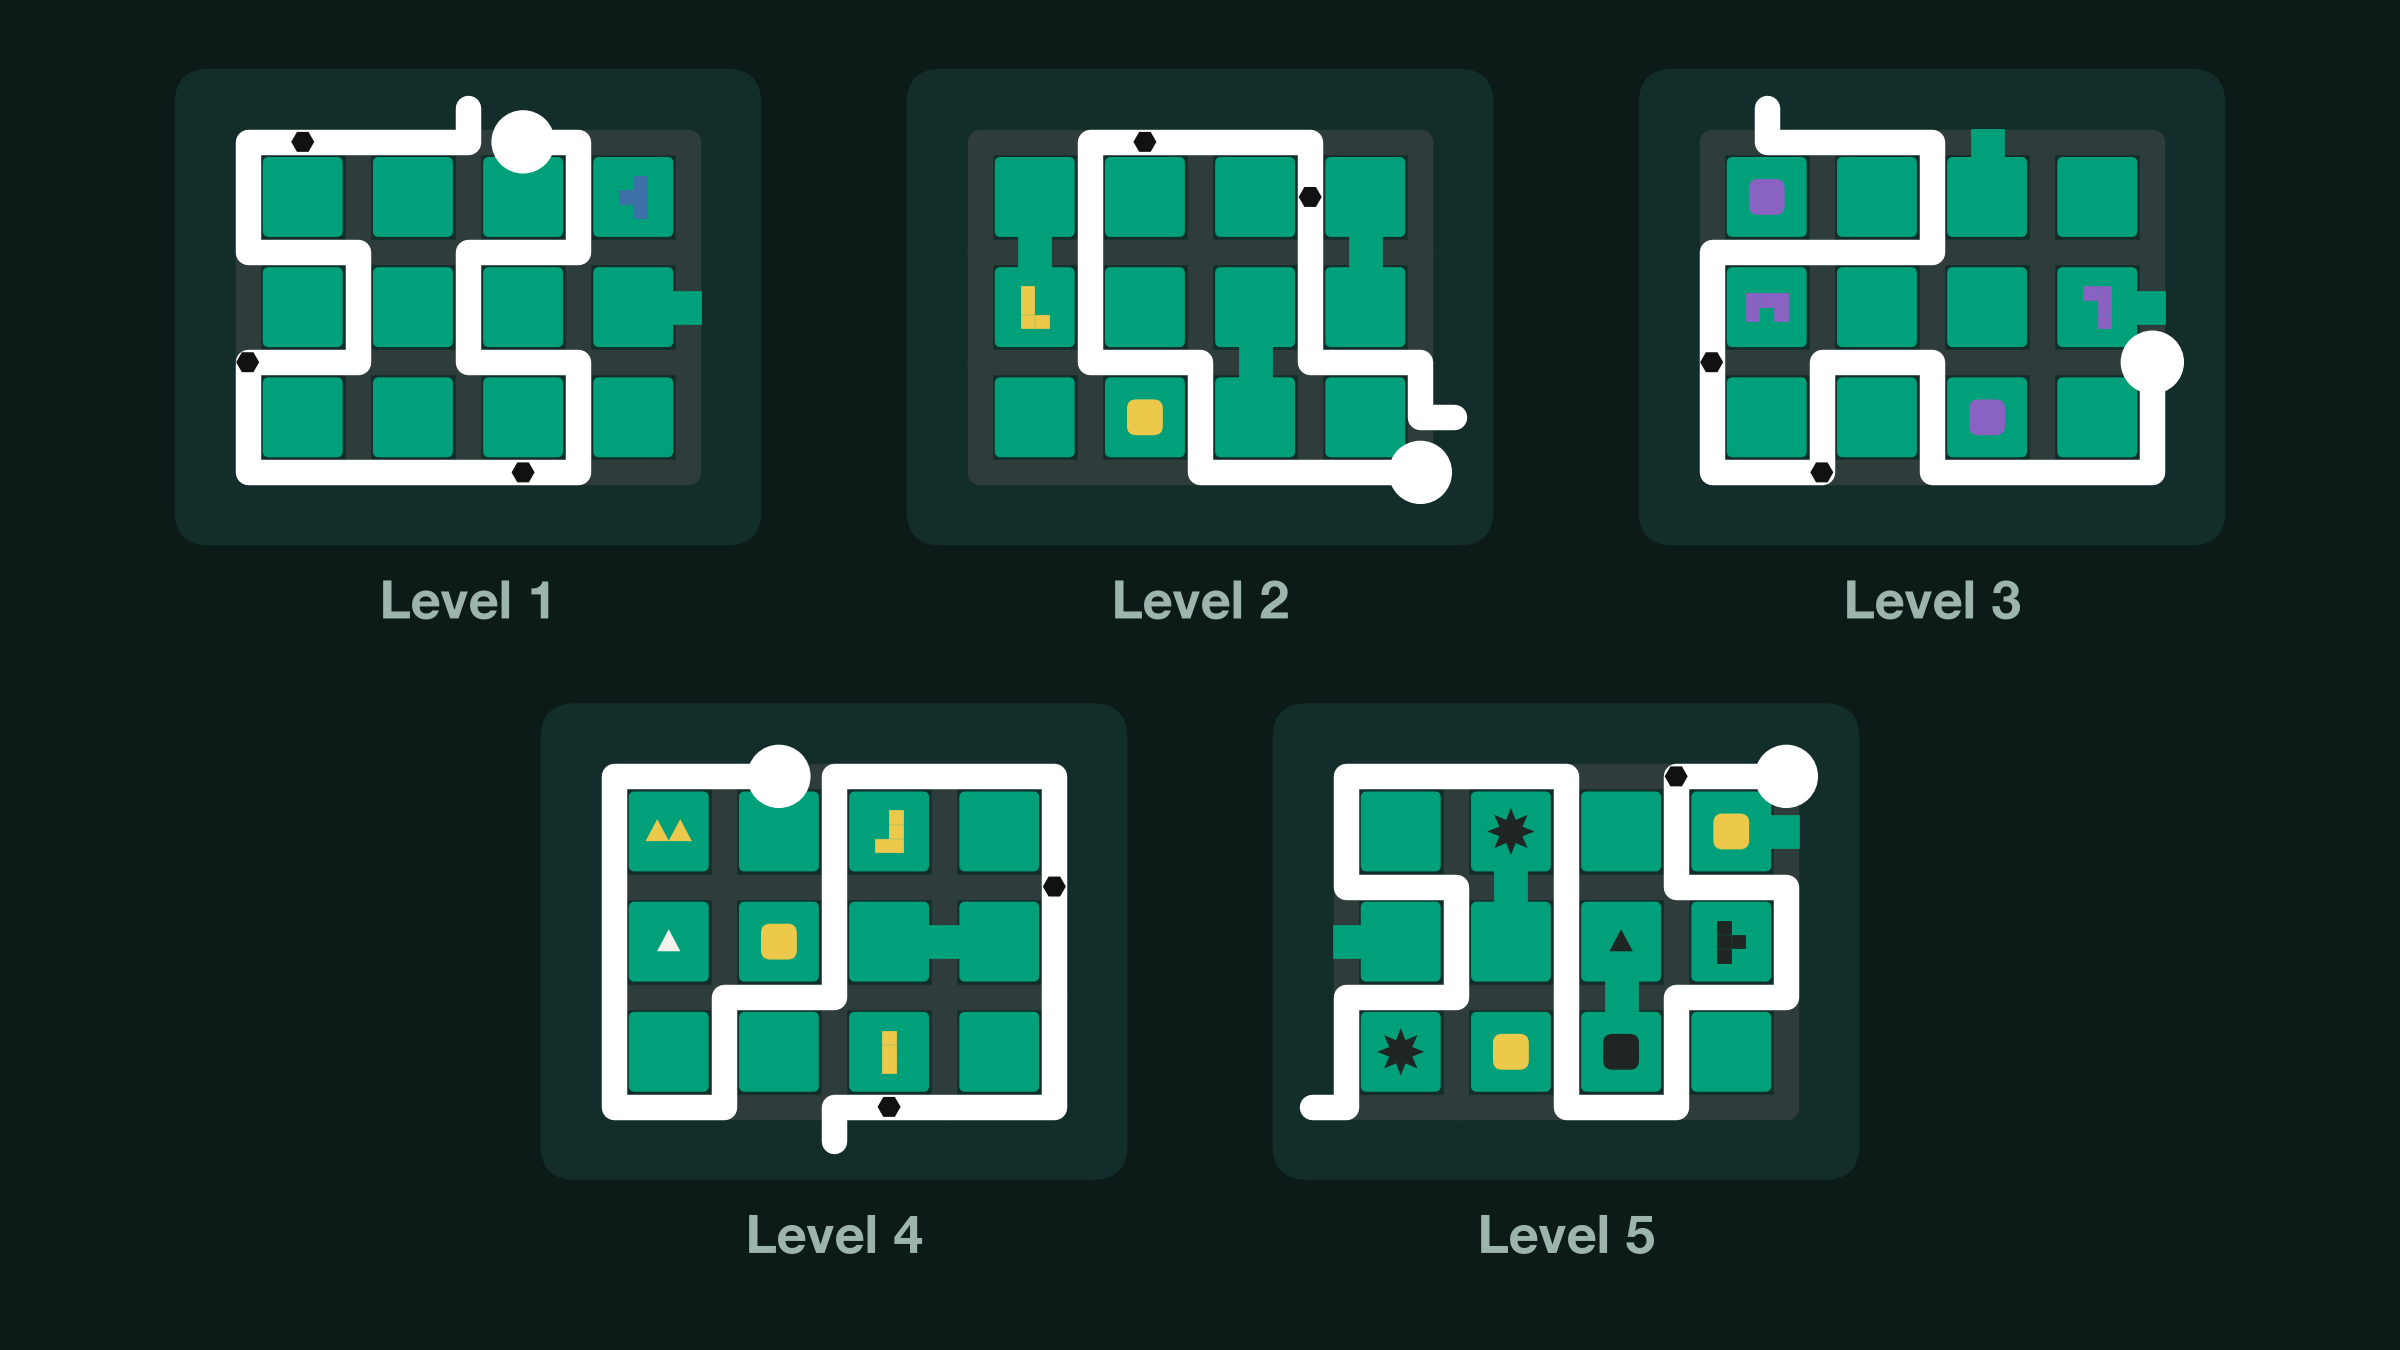
Neste estudo, as pessoas resolveram 98,0% dos quebra-cabeças de grade, levando cerca de 11 segundos para um fácil e pouco mais de dois minutos para o mais difícil. O melhor modelo testado, GPT-6.1 Sol, resolve 83,6% deles. Isso parece próximo do humano, mas no nível mais difícil ele resolve 49,4%, enquanto as pessoas resolvem 94,5%.
Resolver um desses quebra-cabeças exige várias habilidades separadas, e um único número de precisão esconde qual delas um modelo não possui. Por isso, os pesquisadores dividiram a tarefa em quatro perguntas: os modelos conseguem ler o tabuleiro, especialmente a partir de uma imagem? Conseguem acompanhar a própria linha? Conseguem seguir as regras? Eles se esforçam mais quando o quebra-cabeça é mais difícil? A publicação se baseia em três artigos, incluindo o SPa RC, um desafio de raciocínio de busca de caminhos espaciais publicado na EMNLP 2025.
Cada quebra-cabeça é um tabuleiro de células verdes unidas por faixas cinzas. O jogador traça uma linha sem cruzamentos a partir de um grande círculo na borda até um toco de saída. Símbolos determinam quais linhas são válidas: os pontos devem ficar sobre a linha, as lacunas bloqueiam segmentos das faixas, e pedras de cores diferentes devem ficar em regiões separadas, fechadas pela linha. Uma linha que passa pelos dois pontos, mas deixa uma pedra roxa, preta e vermelha na mesma região, quebra a regra das pedras, e a solução correta segue um caminho mais longo pelo tabuleiro.
As pessoas resolveram os quebra-cabeças em um aplicativo de desenho, mas os modelos geralmente recebem o tabuleiro como uma grade de texto com coordenadas. Os modelos explicam seu raciocínio e depois escrevem a linha como uma lista de posições, passo a passo. O benchmark completo contém sete tipos de regras, e a diferença entre pessoas e modelos nos quebra-cabeças mais difíceis mostra onde os sistemas atuais ainda têm dificuldades.
Fonte: Towards Data Science · Resumido por HeadlinesBriefing