
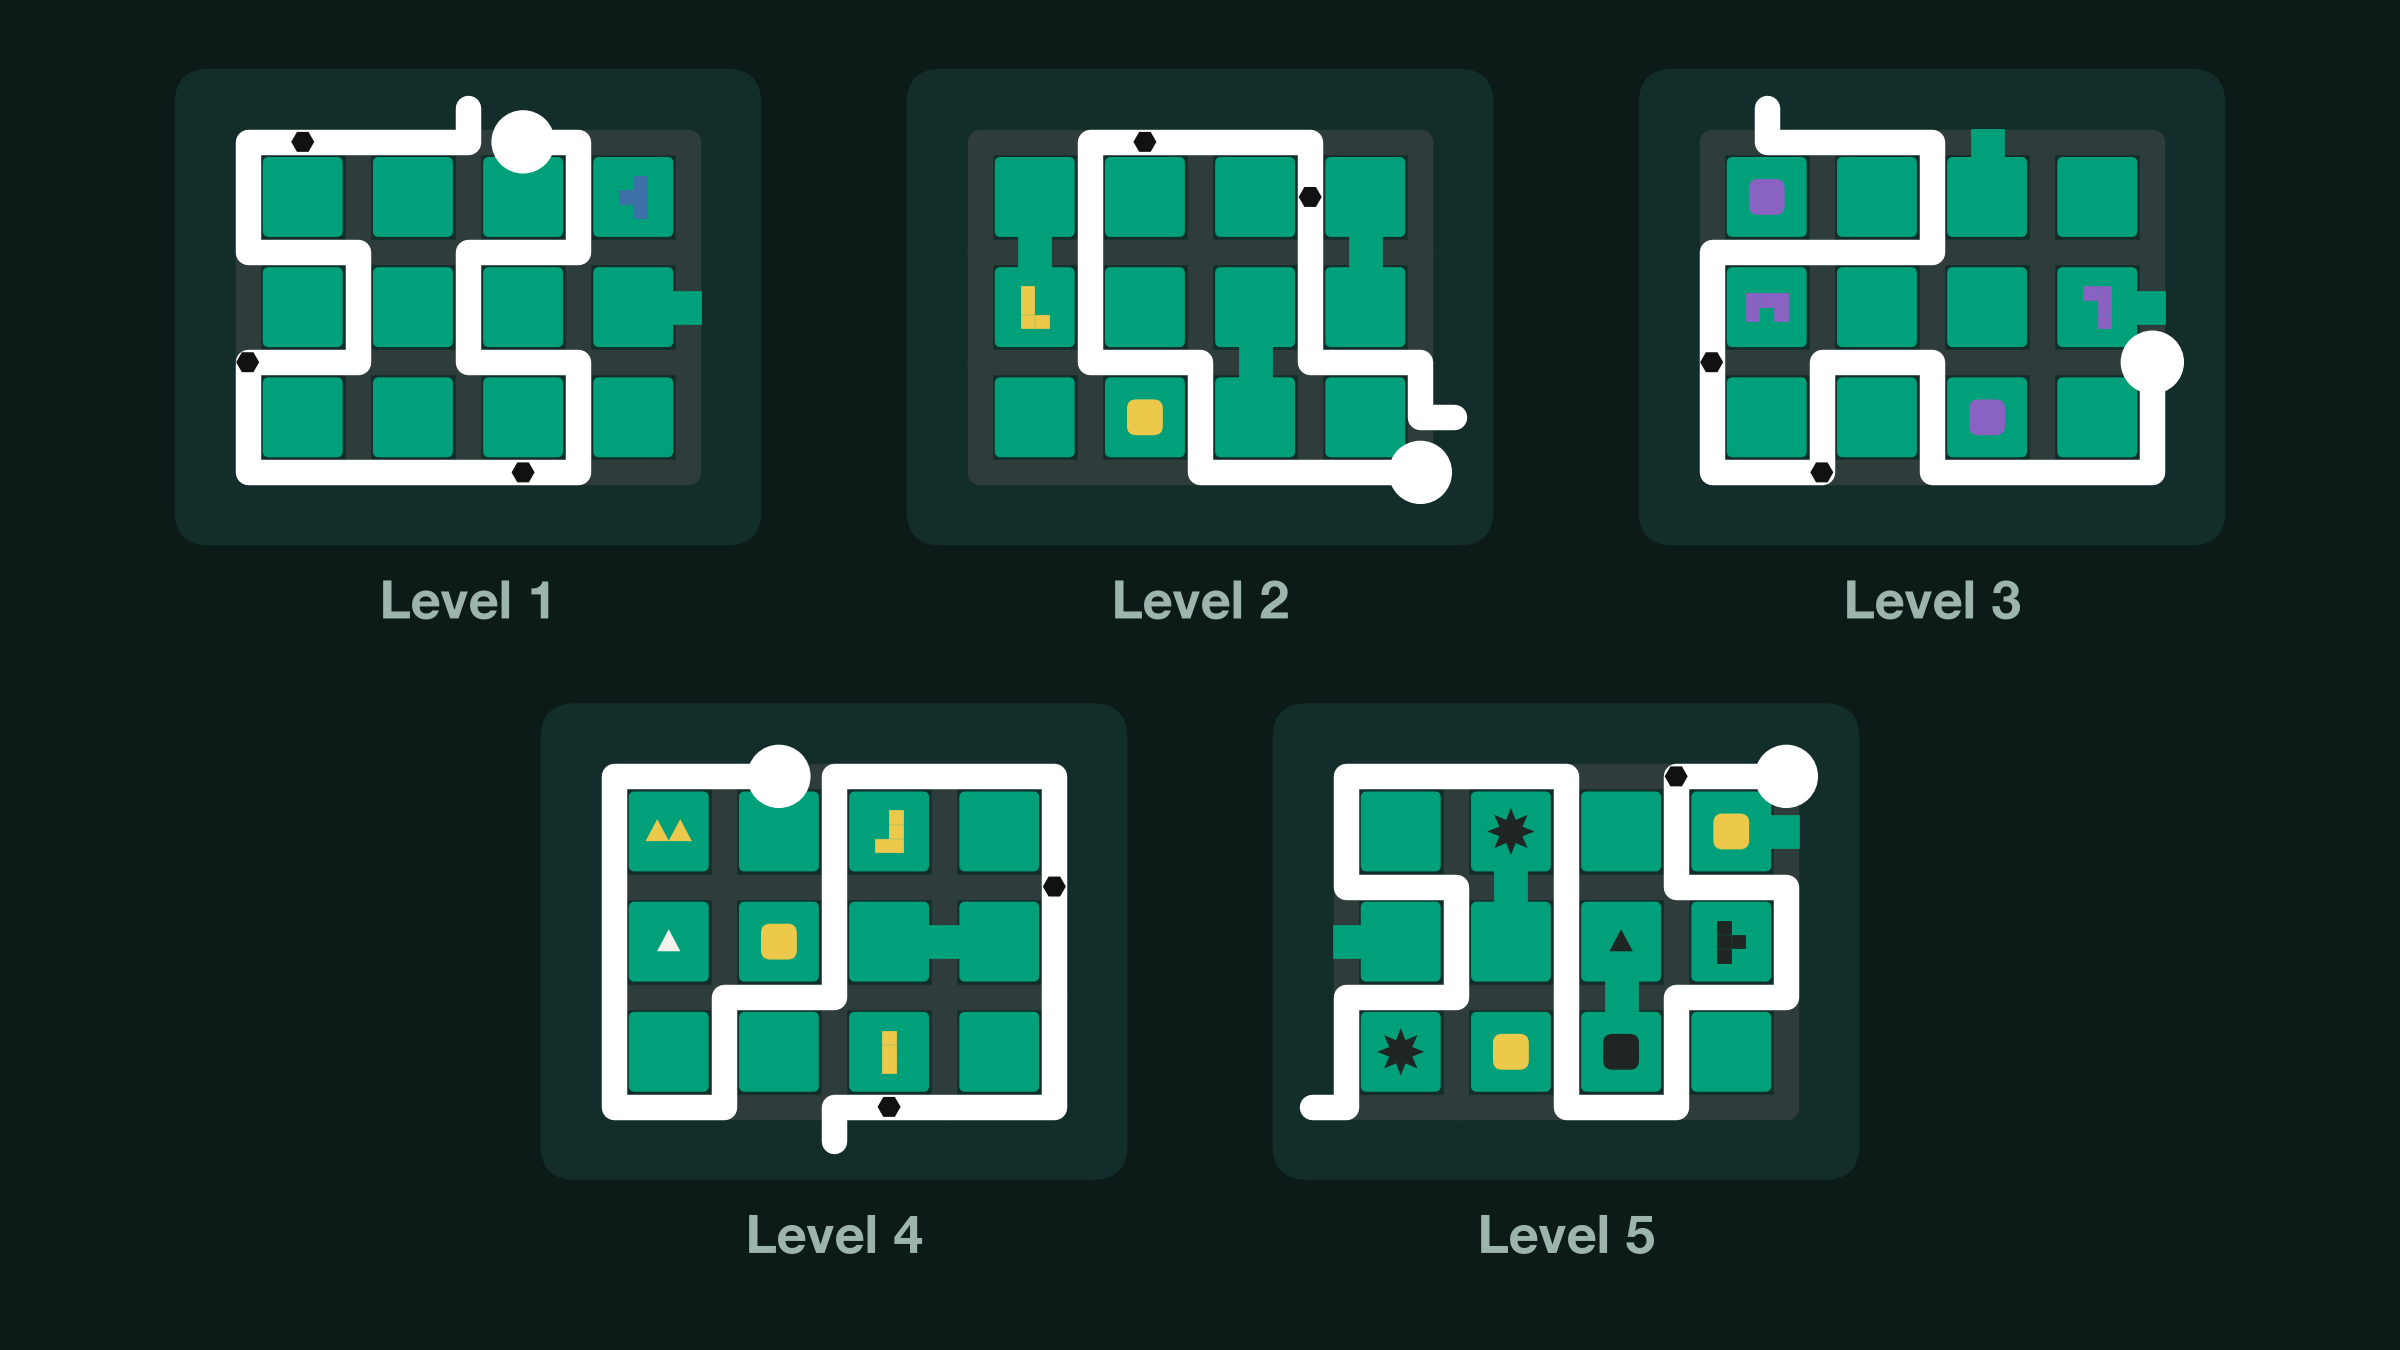
在本研究中,人类解决了98.0%的网格谜题,简单题约需11秒,最难的一题则耗时两分钟多一点。测试中表现最好的模型GPT-6.1 Sol解决了83.6%的谜题。这听起来接近人类水平,但在最难的级别上,它只解决了49.4%,而人类的解决率为94.5%。
解决这类谜题需要多项相互独立的技能,单一的准确率数字无法显示模型缺少的是哪一项。因此,研究人员将任务拆分为四个问题:模型能否读懂棋盘,尤其是从图像中读取?它们能否记住自己画过的线?它们能否遵循规则?谜题变难时,它们会否更加努力?这篇文章借鉴了三篇论文,其中包括发表于EMNLP 2025的空间路径推理挑战SPa RC。
每个谜题都是由灰色通道连接绿色方格组成的棋盘。玩家需要画一条不相交的线,从边缘的大圆圈连到出口短线。符号决定哪些线段有效:圆点必须位于线上,缺口会阻挡通道的线段,不同颜色的石头必须位于由该线封闭的不同区域中。如果一条线穿过了两个圆点,却使紫色、黑色和红色石头位于同一区域,就违反了石头规则,正确的解法需要绕行棋盘上更长的路线。
人类在绘图应用中解决这些谜题,但模型通常接收的是带坐标的文本网格。模型会先解释其推理过程,然后逐步将线路写成一系列位置列表。完整的基准测试包含七种规则类型,人类与模型在最难谜题上的差距,显示出当前系统仍然在哪些地方存在困难。
来源: Towards Data Science · 由HeadlinesBriefing整理摘要