
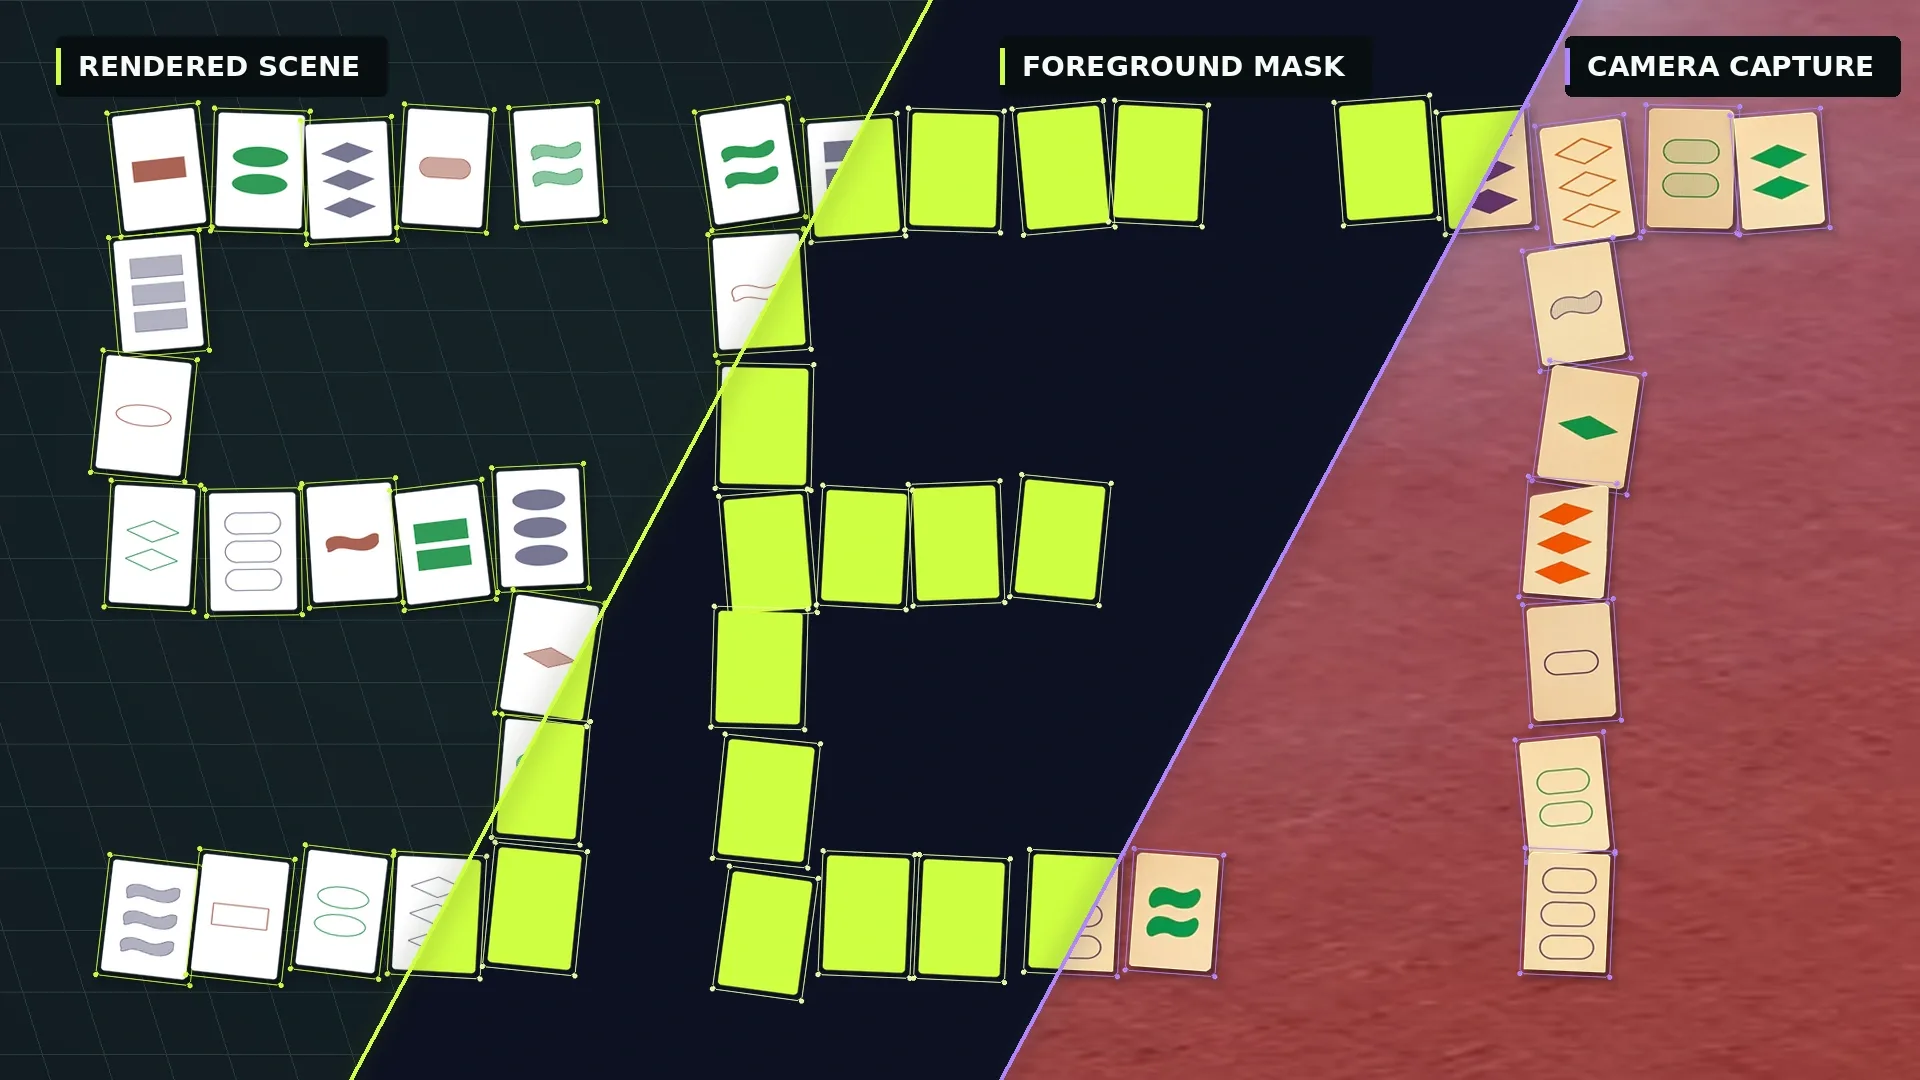
मशीन लर्निंग में डेटा सबसे मूल्यवान हिस्सा है, लेकिन किसी विशिष्ट कार्य के लिए डेटा एकत्र करना और उसे लेबल करना अक्सर कठिन होता है। मैन्युअल रूप से कैप्चर करने से पूर्वाग्रह आने का जोखिम रहता है, और तृतीय पक्षों से या पूर्व-एनोटेशन के लिए उपयोग किए गए विज़न-लैंग्वेज मॉडल से प्राप्त एनोटेशन को सत्यापित करने में और अधिक प्रयास लगता है। सिंथेटिक रूप से तैयार किया गया डेटा एक विकल्प प्रदान करता है, क्योंकि ग्राउंड ट्रुथ एनोटेशन डिज़ाइन द्वारा ही अंतर्निहित होते हैं। मुख्य चुनौती यह है कि क्या सिंथेटिक चित्रों पर प्रशिक्षित मॉडल वास्तविक दुनिया के डेटा तक सामान्यीकृत हो सकते हैं।
यह परियोजना जाँचती है कि क्या एक अत्याधुनिक पूर्व-प्रशिक्षित फ़ीचर एक्सट्रैक्टर ऐसे समृद्ध प्रतिनिधित्व उत्पन्न कर सकता है जो केवल सिंथेटिक डेटा पर प्रशिक्षित हल्के टास्क हेड्स को वास्तविक चित्रों तक सामान्यीकृत करने दें। चुना गया डोमेन कार्ड गेम SET है, जिसमें खिलाड़ी 4x3 के क्षेत्र में कार्डों की तिकड़ियाँ खोजते हैं, जहाँ प्रत्येक विशेषता (आकार, रंग, शेडिंग और संख्या) तीनों कार्डों में या तो समान होती है या भिन्न। इन कार्डों की पहचान एक प्रबंधनीय जनरेशन समस्या है जो फिर भी रोचक बनी रहती है।
लेखक ने Meta के DINOv3 को उसके मज़बूत स्थानीकृत फ़ीचर निष्कर्षण और उसके डिस्टिल्ड छोटे वेरिएंट के लिए चुना। सीमित हार्डवेयर को देखते हुए, सबसे छोटा डिस्टिल्ड कन्वोल्यूशनल मॉडल ConvNeXt Tiny चुना गया, जिसमें लगभग 29M पैरामीटर हैं, और बाउंडिंग बॉक्स, की-पॉइंट्स या सेगमेंटेशन मास्क के लिए कार्य-विशिष्ट हेड्स जोड़े गए। पहले चरण के रूप में, परियोजना कार्डों की पहचान तो करती है, पर अभी उनके प्रकार का वर्गीकरण नहीं करती।
सिंथेटिक डेटा के लिए, OpenCV बुनियादी आकृतियाँ बनाता है, गोलाकार आयतों तथा आयतों और वृत्तों के संयोजनों से कार्ड बनाए जाते हैं। प्रक्रियात्मक जनरेशन कार्ड की दिखावट पर असीमित नियंत्रण देता है, जिससे वास्तविक फ़ोटो तक बेहतर स्थानांतरण के लिए पैरामीटर व्यापक रूप से बदले जा सकते हैं।
स्रोत: Towards Data Science · HeadlinesBriefing द्वारा सारांशित