
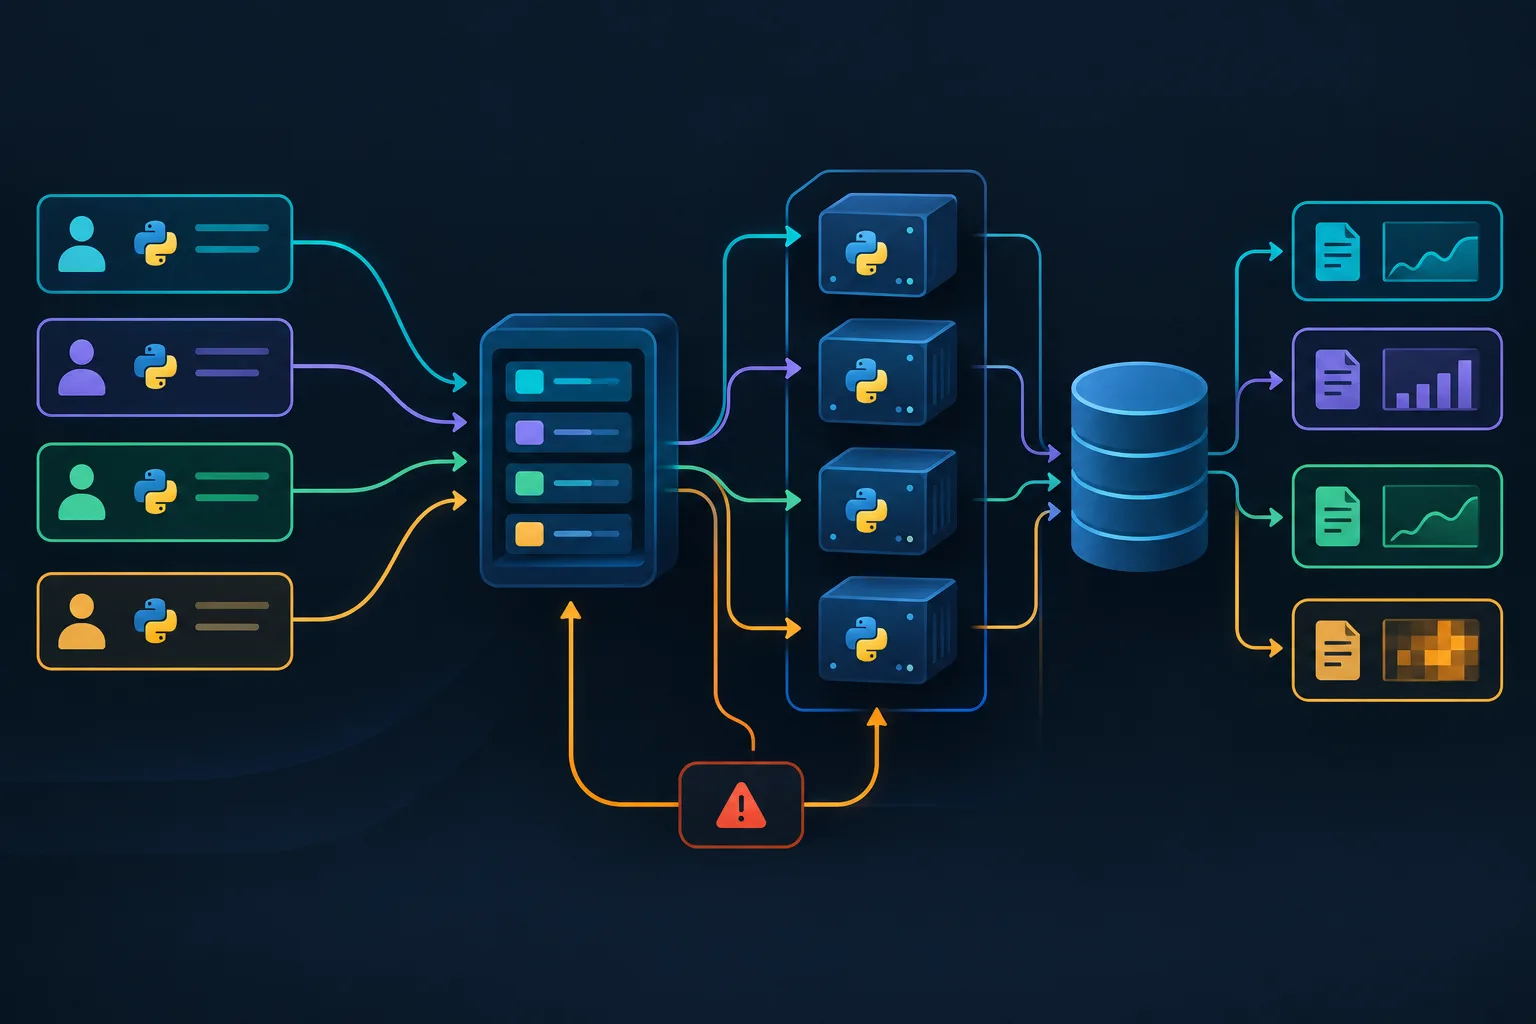
लंबे समय तक चलने वाला Python सिमुलेशन तब तक केवल एक कंप्यूट समस्या लगता है जब तक उसे एक ही व्यक्ति चलाता है। एक बार कई लोग उस पर निर्भर होते हैं, तो कठिनाई कतार प्रबंधन, विफलता से पुनर्प्राप्ति, जॉब की दृश्यता और पुनरुत्पादन की ओर खिसक जाती है। अनुरोध जॉब पूरे होने की तुलना में तेज़ी से आते हैं, कुछ रन बीच में ही विफल हो जाते हैं, और लोग चाहते हैं कि पिछले परिणाम माँग पर फिर से दोहराए जा सकें।
लेखक का तर्क है कि असली इंजीनियरिंग उस अंतर में है जो एक ऐसे प्रोग्राम और उस सेवा के बीच है जिस पर लोग भरोसा कर सकें। मॉडल मूल्यांकन और बैच प्रोसेसिंग को भी यही समस्या झेलनी पड़ती है। कोड को एक बार चलाना आसान है; लेकिन उसे कई उपयोगकर्ताओं के लिए बार-बार चलाना, ताकि हर रन खोजा, ट्रेस और दोहराया जा सके और दूसरों में बाधा न डाले, यह एक अलग तरह का काम है।
Amazon UK में AWS-आधारित परिवहन सिमुलेशन इंफ़्रास्ट्रक्चर पर काम करते समय बाधा कंप्यूट नहीं थी। कार्यप्रवाह बड़े पैमाने पर मैन्युअल था, जहाँ ऑपरेटर इनपुट, कॉन्फ़िगरेशन और इंफ़्रास्ट्रक्चर सेटअप हाथ से संभालते थे। हर नए अनुरोध ने किसी भी कंप्यूट के उपयोग से पहले इंजीनियरों का ध्यान खींच लिया, और विफल रन का पता लगाना कठिन था क्योंकि साक्ष्य इनपुट, कॉन्फ़िगरेशन और मशीनों में बिखरे हुए थे। मशीनें जोड़ने से सैद्धांतिक सीमा बढ़ जाती, लेकिन कतार, रनों के बीच अलगाव और डुप्लिकेट निष्पादन की समस्याएँ हल नहीं होतीं।
इसलिए प्रश्न बदल गया: सिमुलेशन को और तेज़ी से कैसे चलाएँ, से बदलकर यह हुआ कि कई लोग सुरक्षित रूप से काम कैसे सबमिट करें, हर जॉब की स्थिति कैसे देखें, और कुछ टूटने पर कैसे उबरें। लेखक का मूल दावा है कि जब कई लोग लंबे समय तक चलने वाले सिमुलेशन पर निर्भर होते हैं, तब असली समस्या जॉब नियंत्रण है, जिसे कतार, स्टेट प्रबंधन, अलगाव, पुनर्प्राप्ति और ट्रेसेबिलिटी जैसे छोटे विषयों में बाँटा जा सकता है।
स्रोत: Towards Data Science · HeadlinesBriefing द्वारा सारांशित