
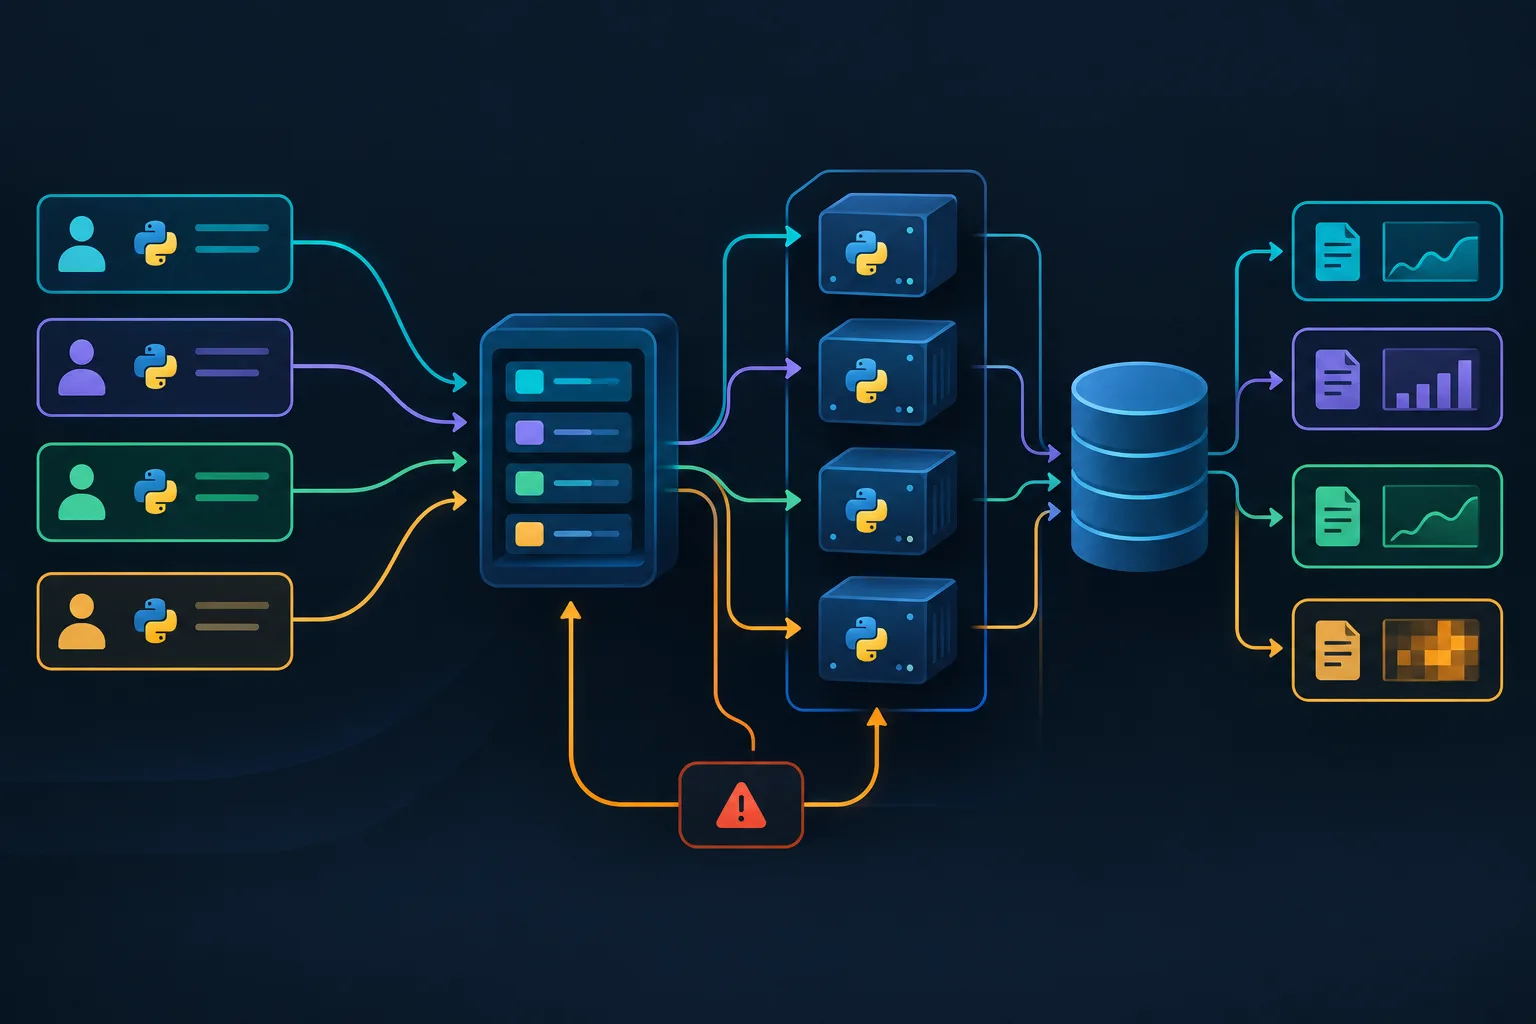
長時間実行される Python シミュレーションは、一人が実行しているうちは計算の問題に見えます。しかし複数の人がそれに依存し始めると、難しさはキュー管理、障害からの復旧、ジョブの可視性、再現性へと移ります。ジョブが完了するより速くリクエストが届き、途中で失敗する実行もあり、人々は過去の結果をいつでも再現できることを期待します。
著者は、本当のエンジニアリングは「動くプログラム」と「人々が頼れるサービス」の間のギャップにあると主張します。モデル評価やバッチ処理も同じ問題に直面します。コードを一度実行するのは簡単ですが、多数のユーザーのために繰り返し実行し、他の実行を妨げることなく、すべての実行を見つけ、追跡し、再現できるようにすることは、まったく別種の仕事です。
Amazon UK で AWS ベースの交通シミュレーション基盤に取り組んでいたとき、ボトルネックは計算資源ではありませんでした。ワークフローは大部分が手作業で、オペレーターが入力、設定、インフラのセットアップを手で行っていました。新しいリクエストごとに、計算が使われる前からエンジニアの注意が奪われ、失敗した実行は、証拠が入力、設定、マシンに散らばっているため追跡が困難でした。マシンを増やせば理論上の上限は上がりますが、キュー、実行間の分離、重複実行の問題は解決しませんでした。
そこで問いは、シミュレーションをどう速く実行するかから、複数の人が安全にジョブを投入し、各ジョブの状態を把握し、何かが壊れても回復できるようにするにはどうすればよいか、へと変わりました。著者の中心的な主張は、複数の人が長時間のシミュレーションに依存するようになると、真の問題はジョブ制御であり、それはキュー、状態管理、分離、回復、追跡可能性といった小さな課題に分解される、というものです。
出典: Towards Data Science · 要約:HeadlinesBriefing