
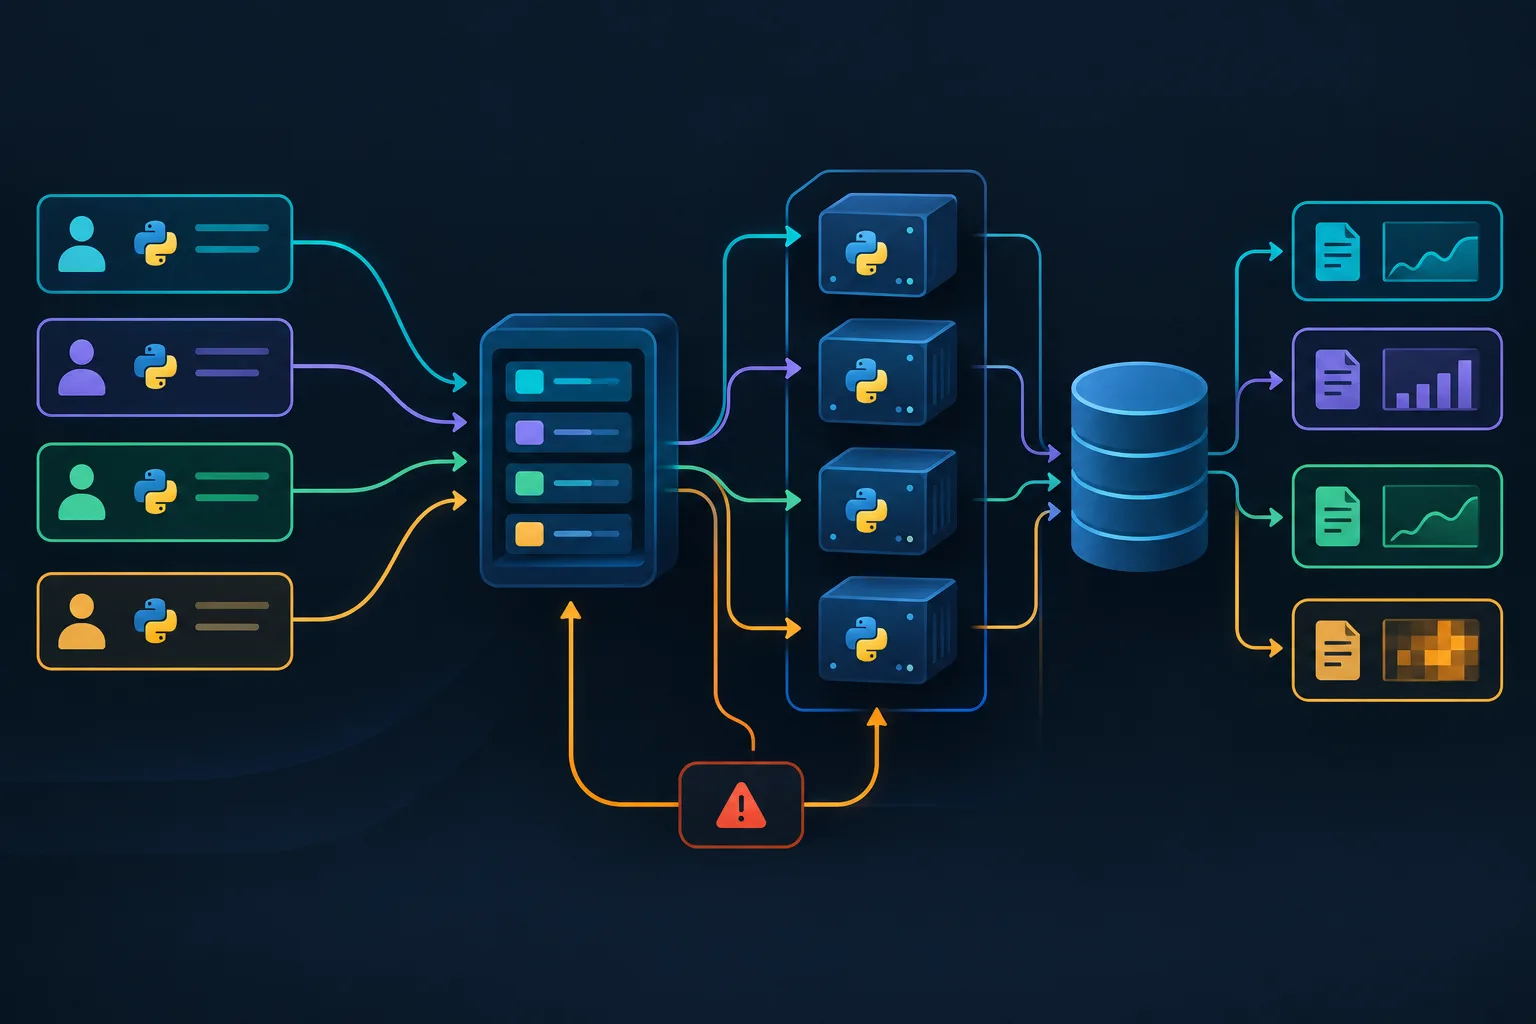
Une simulation Python de longue durée ressemble à un problème de calcul tant qu'une seule personne l'exécute. Dès que plusieurs personnes en dépendent, la difficulté se déplace vers les files d'attente, la reprise après échec, la visibilité des tâches et la reproductibilité. Les demandes arrivent plus vite que les tâches ne se terminent, certaines exécutions échouent à mi-parcours, et les utilisateurs attendent que les résultats passés puissent être reproduits à la demande.
L'auteur soutient que le véritable travail d'ingénierie se situe dans l'écart entre un programme qui fonctionne et un service sur lequel les gens peuvent compter. L'évaluation de modèles et le traitement par lots rencontrent le même problème. Exécuter du code une fois est facile ; l'exécuter de façon répétée pour de nombreux utilisateurs, de sorte que chaque exécution puisse être retrouvée, tracée et répétée sans interférer avec les autres, est un travail d'une tout autre nature.
Lors du développement de l'infrastructure de simulation des transports basée sur AWS chez Amazon UK, le goulot d'étranglement n'était pas le calcul. Le flux de travail était en grande partie manuel, les opérateurs gérant à la main les entrées, la configuration et la mise en place de l'infrastructure. Chaque nouvelle demande mobilisait l'attention des ingénieurs avant même qu'une quelconque puissance de calcul ne soit utilisée, et les exécutions en échec étaient difficiles à tracer, car les éléments de preuve étaient dispersés entre les entrées, la configuration et les machines. Ajouter des machines aurait relevé le plafond théorique, mais n'aurait pas résolu les problèmes de file d'attente, d'isolation entre les exécutions et d'exécution en double.
La question est donc passée de « comment exécuter les simulations plus vite ? » à « comment permettre à plusieurs personnes de soumettre des travaux en toute sécurité, de suivre l'état de chaque tâche et de se rétablir lorsque quelque chose casse ? ». La thèse centrale de l'auteur est qu'une fois que plusieurs personnes dépendent de simulations longues, le vrai problème est le contrôle des tâches, qui se décompose en préoccupations plus petites : files d'attente, gestion d'état, isolation, reprise et traçabilité.
Source: Towards Data Science · Résumé par HeadlinesBriefing