
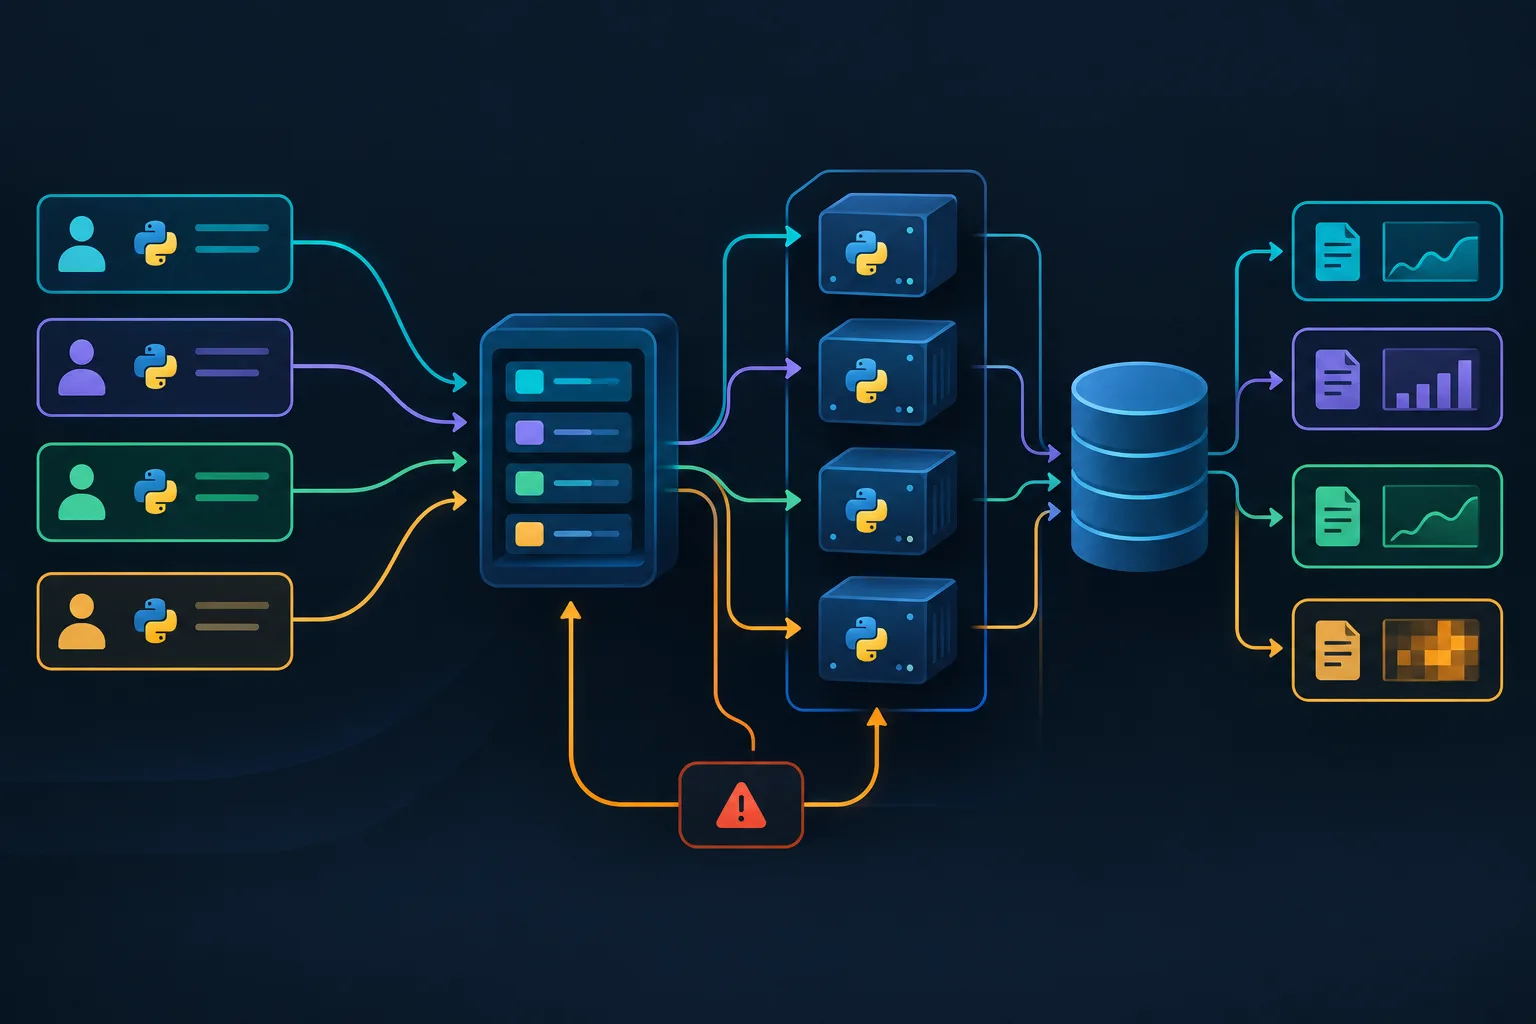
只要由一个人运行,长时间运行的 Python 模拟看起来像是一个计算问题。一旦有多人依赖它,难点就转移到排队、故障恢复、作业可见性和可复现性上。请求到达的速度快于作业完成的速度,一些运行会在中途失败,而人们期望能够随时复现过去的结果。
作者认为,真正的工程挑战在于能够工作的程序与人们可以依赖的服务之间的差距。模型评估和批处理也面临同样的问题。运行一次代码很容易;而为众多用户反复运行代码,使每次运行都能被找到、追溯和重复,且不干扰他人,则是另一类工作。
在英国亚马逊基于 AWS 的交通模拟基础设施的工作中,瓶颈并不在计算。工作流程大多是手动的,运营人员需要手工处理输入、配置和基础设施搭建。每个新请求在使用任何计算资源之前,就已经占用了工程师的精力;而且由于证据分散在输入、配置和机器之间,失败的运行很难追溯。增加机器会提高理论上限,但排队、运行之间的隔离以及重复执行的问题依然无法解决。
因此,问题从“如何更快地运行模拟”转变为“如何让多人安全地提交工作、观察每个作业的状态,并在出现故障时恢复”。作者的核心观点是:一旦多人依赖长时间运行的模拟,真正的问题就是作业控制,而它可以分解为更小的问题:排队、状态管理、隔离、恢复和可追溯性。
来源: Towards Data Science · 由HeadlinesBriefing整理摘要