
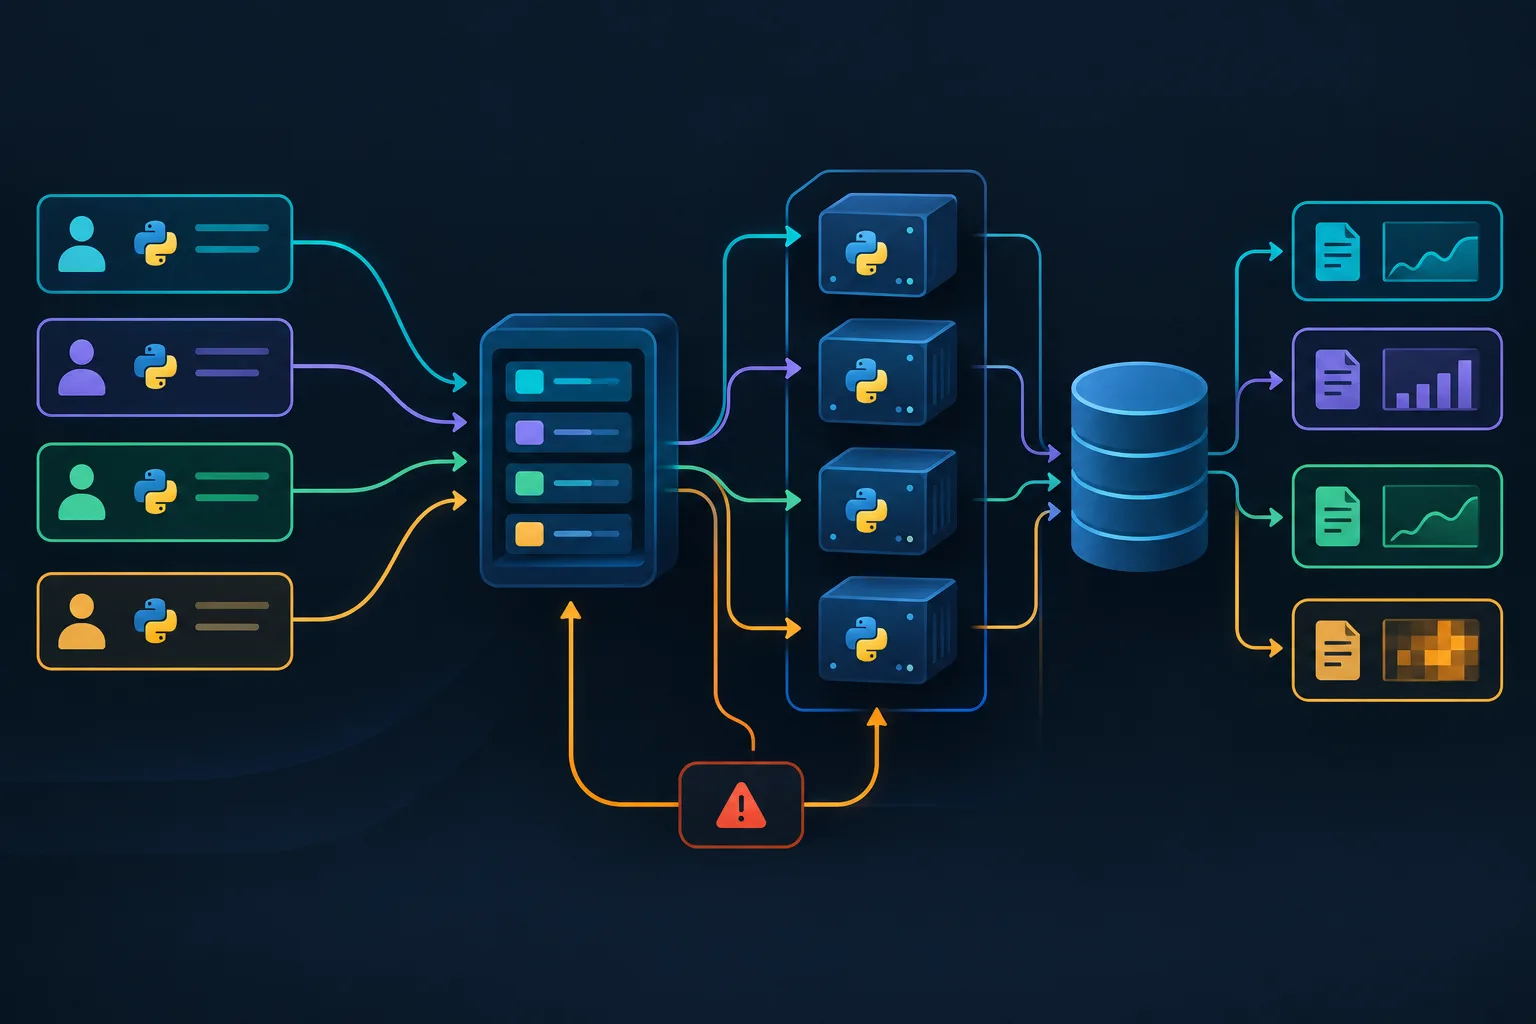
Долго выполняющаяся симуляция на Python выглядит как вычислительная задача, пока её запускает один человек. Как только от неё зависят несколько человек, трудность смещается к очередям, восстановлению после сбоев, видимости заданий и воспроизводимости. Запросы поступают быстрее, чем завершаются задания, некоторые запуски падают на полпути, а люди ожидают, что прошлые результаты можно будет воспроизвести по требованию.
Автор утверждает, что настоящая инженерная работа заключается в разрыве между программой, которая работает, и сервисом, на который люди могут полагаться. Оценка моделей и пакетная обработка сталкиваются с той же проблемой. Запустить код один раз легко; запускать его многократно для многих пользователей так, чтобы каждый запуск можно было найти, отследить и повторить, не мешая другим, — это работа иного рода.
Во время работы над основанной на AWS инфраструктурой транспортных симуляций в Amazon UK узким местом были не вычисления. Рабочий процесс был в основном ручным: операторы вручную занимались входными данными, конфигурацией и настройкой инфраструктуры. Каждый новый запрос отнимал внимание инженеров ещё до того, как использовались какие-либо вычислительные ресурсы, а неудачные запуски было трудно проследить, так как свидетельства были разбросаны между входными данными, конфигурацией и машинами. Добавление машин подняло бы теоретический потолок, но не решило бы проблемы очередей, изоляции запусков и дублирующего выполнения.
Поэтому вопрос сместился от того, как запускать симуляции быстрее, к тому, как позволить нескольким людям безопасно отправлять задания, видеть статус каждого из них и восстанавливаться, когда что-то ломается. Главный тезис автора состоит в том, что, когда несколько человек зависят от долгих симуляций, настоящая проблема — управление заданиями, которое распадается на более мелкие задачи: очереди, управление состоянием, изоляция, восстановление и отслеживаемость.
Источник: Towards Data Science · Сводку подготовил HeadlinesBriefing