
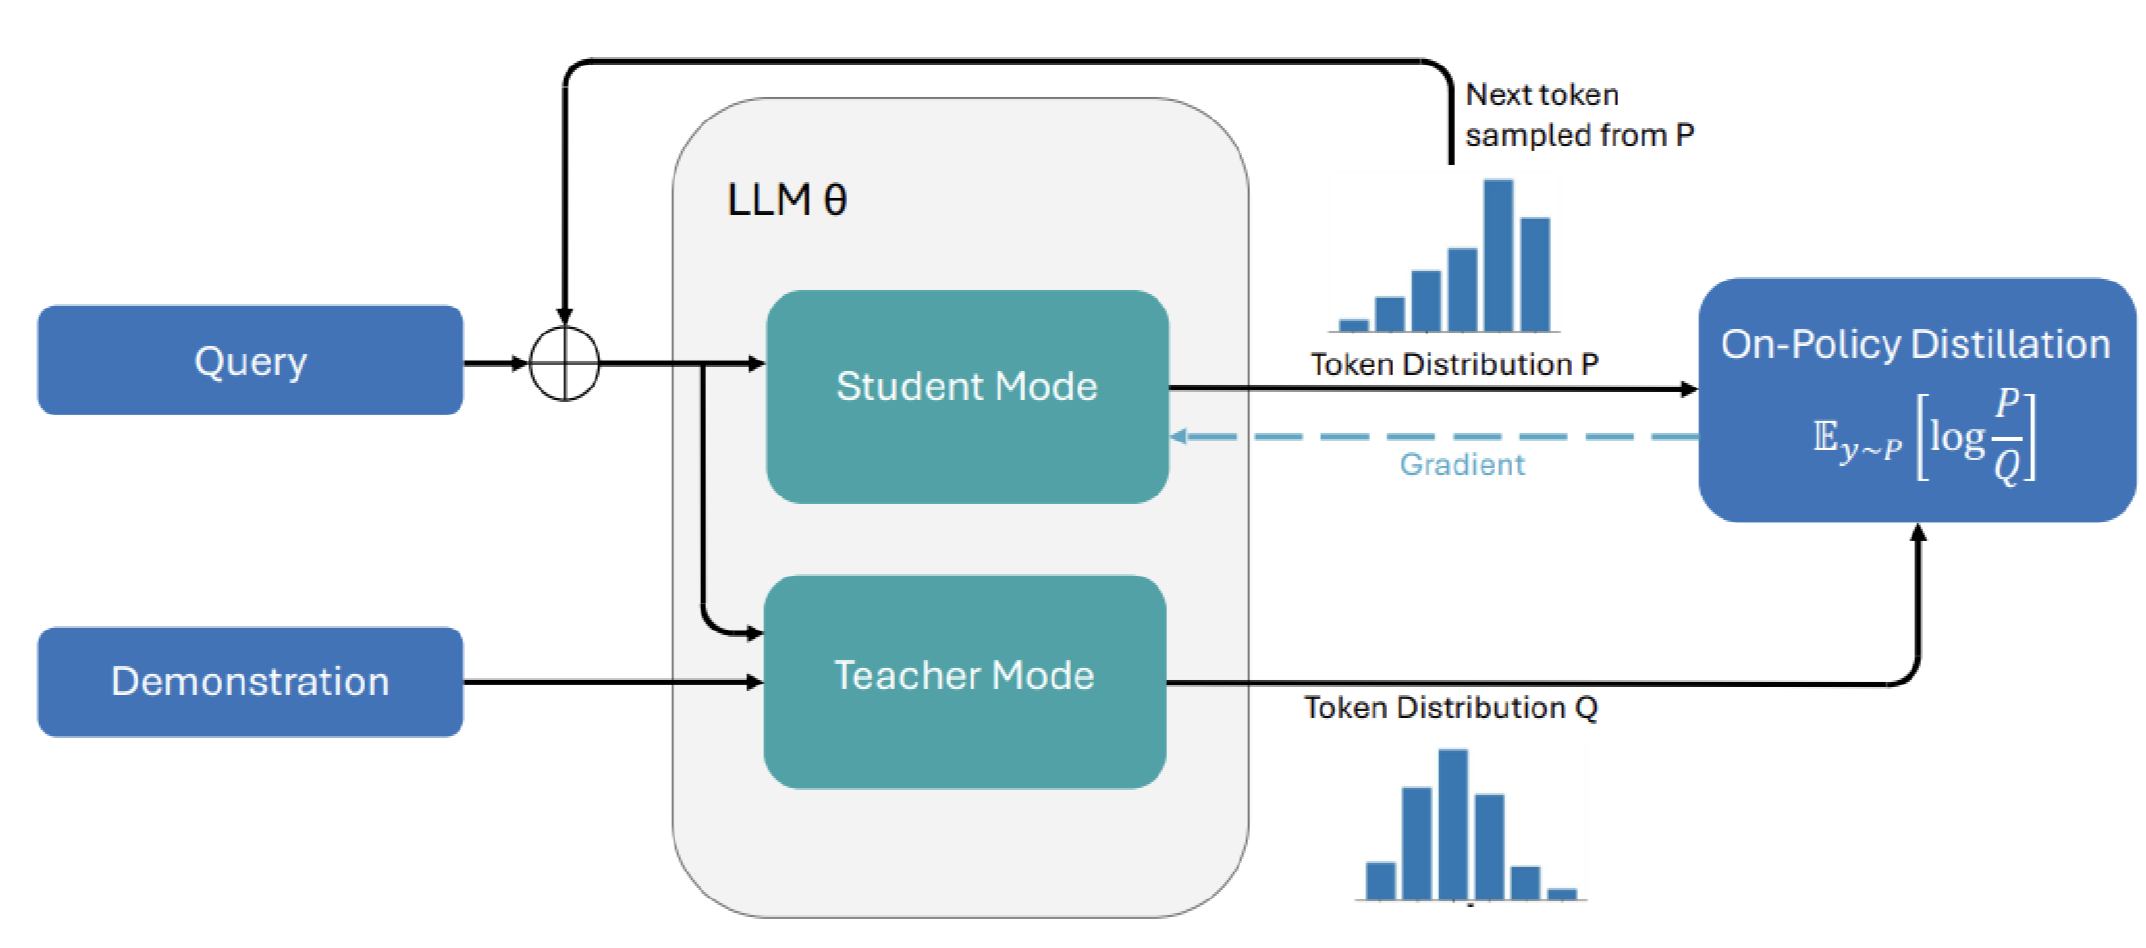
La autodestilación en política (OPSD) se ha convertido rápidamente en un tema destacado de la investigación en aprendizaje automático. Aunque sus marcos se basan en enfoques más antiguos y consolidados, los primeros artículos sobre el tema aparecieron solo a finales de enero de 2026, y en un breve período le han seguido varias decenas más. Este artículo explora la literatura sobre OPSD, principalmente desde la perspectiva del marco de Autodestilación para el Ajuste Fino (SDFT) presentado por Shenfeld et al. en "Self-distillation enables continual learning".
El término "aprendizaje continuo" en el título de ese artículo se refiere a la capacidad de un modelo para aprender de forma eficaz y dinámica a partir de un flujo de datos. El artículo comienza examinando el problema que los marcos OPSD pretenden resolver: el olvido catastrófico, en el que los modelos pierden la capacidad de manejar tareas antiguas a medida que aprenden nuevas. A medida que los modelos fundacionales se vuelven más potentes, posentrenarlos para tareas complejas o personalizadas se vuelve esencial, ya que entrenarlos desde cero resulta prohibitivamente caro.
A continuación, el artículo analiza cómo funciona SDFT y las explicaciones teóricas de su éxito. Los experimentos reportados en el artículo muestran resultados prometedores, lo que respalda la posibilidad de que OPSD sea ampliamente aplicable. Por último, aborda dos preocupaciones centrales que han surgido en torno al método.
Fuente: Towards Data Science · Resumido por HeadlinesBriefing