
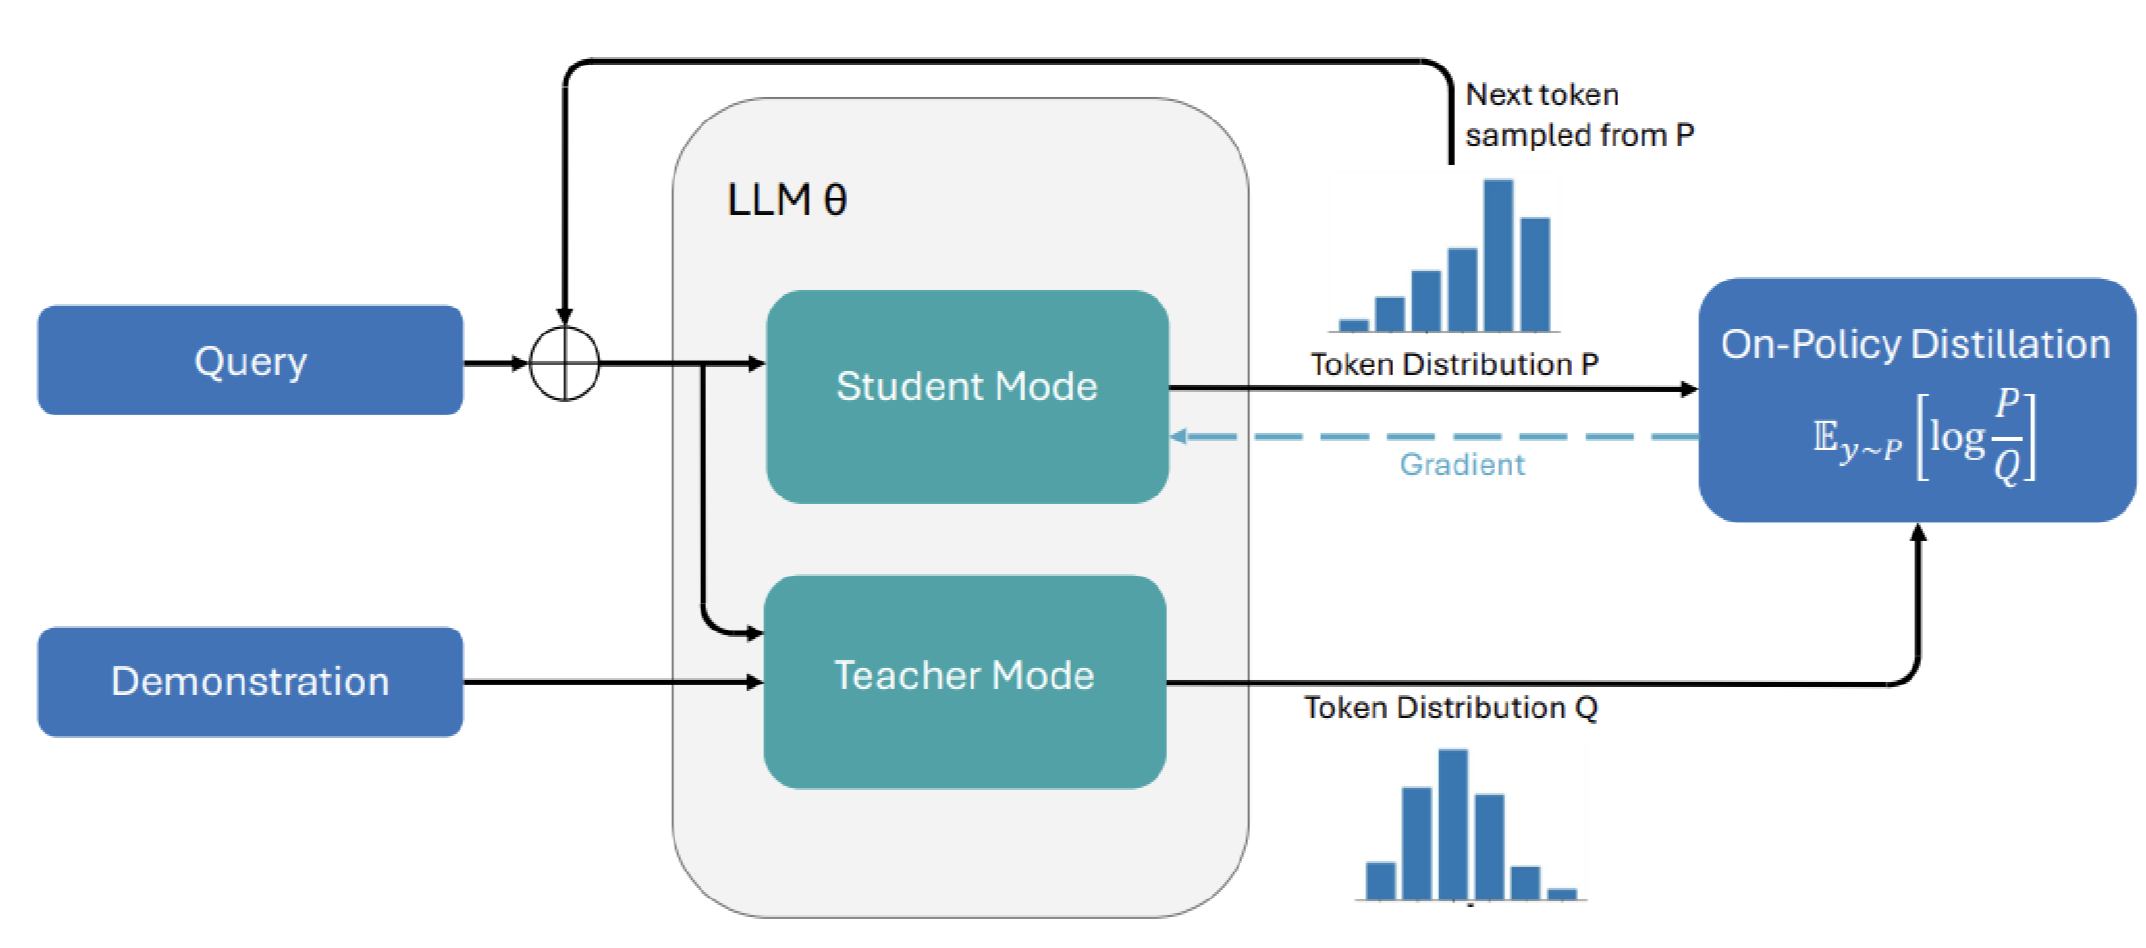
অন-পলিসি সেলফ-ডিস্টিলেশন (OPSD) দ্রুত মেশিন লার্নিং গবেষণার একটি প্রধান বিষয়ে পরিণত হয়েছে। যদিও এর কাঠামোগুলো পুরোনো, প্রতিষ্ঠিত পদ্ধতির উপর ভিত্তি করে তৈরি, তবু এই বিষয়ে প্রথম গবেষণাপত্র শুধুমাত্র ২০২৬ সালের জানুয়ারির শেষের দিকে প্রকাশিত হয়, এবং অল্প সময়ের মধ্যেই আরও কয়েক ডজন প্রকাশিত হয়। এই নিবন্ধটি মূলত Shenfeld প্রমুখ "Self-distillation enables continual learning" শীর্ষক গবেষণাপত্রে প্রবর্তিত Self-Distillation Fine-Tuning (SDFT) কাঠামোর দৃষ্টিকোণ থেকে OPSD সাহিত্য অনুসন্ধান করে।
সেই গবেষণাপত্রের শিরোনামে "continual learning" শব্দটি বলতে বোঝায় কোনো মডেলের ডেটাস্ট্রিম থেকে কার্যকর ও গতিশীলভাবে শেখার ক্ষমতা। নিবন্ধটি প্রথমে OPSD কাঠামোগুলো যে সমস্যা সমাধানের লক্ষ্যে কাজ করে তা পরীক্ষা করে: ক্যাটাস্ট্রফিক ফরগেটিং, যেখানে নতুন কাজ শিখতে গিয়ে মডেল পুরোনো কাজ করার ক্ষমতা হারিয়ে ফেলে। ফাউন্ডেশন মডেল যত শক্তিশালী হচ্ছে, জটিল বা কাস্টমাইজড কাজের জন্য সেগুলোর পোস্ট-ট্রেইনিং ততই অপরিহার্য হয়ে উঠছে, কারণ শূন্য থেকে প্রি-ট্রেইনিং অত্যন্ত ব্যয়বহুল।
এরপর নিবন্ধে SDFT কীভাবে কাজ করে এবং এর সাফল্যের তাত্ত্বিক ব্যাখ্যা নিয়ে আলোচনা করা হয়েছে। গবেষণাপত্রে উল্লিখিত পরীক্ষাগুলো আশাব্যঞ্জক ফলাফল দেখায়, যা OPSD-এর ব্যাপক প্রয়োগযোগ্যতার সম্ভাবনাকে জোরালো করে। সবশেষে, এই পদ্ধতি নিয়ে উদ্ভূত দুটি প্রধান উদ্বেগ নিয়ে আলোচনা করা হয়েছে।
উৎস: Towards Data Science · সারাংশ: HeadlinesBriefing