
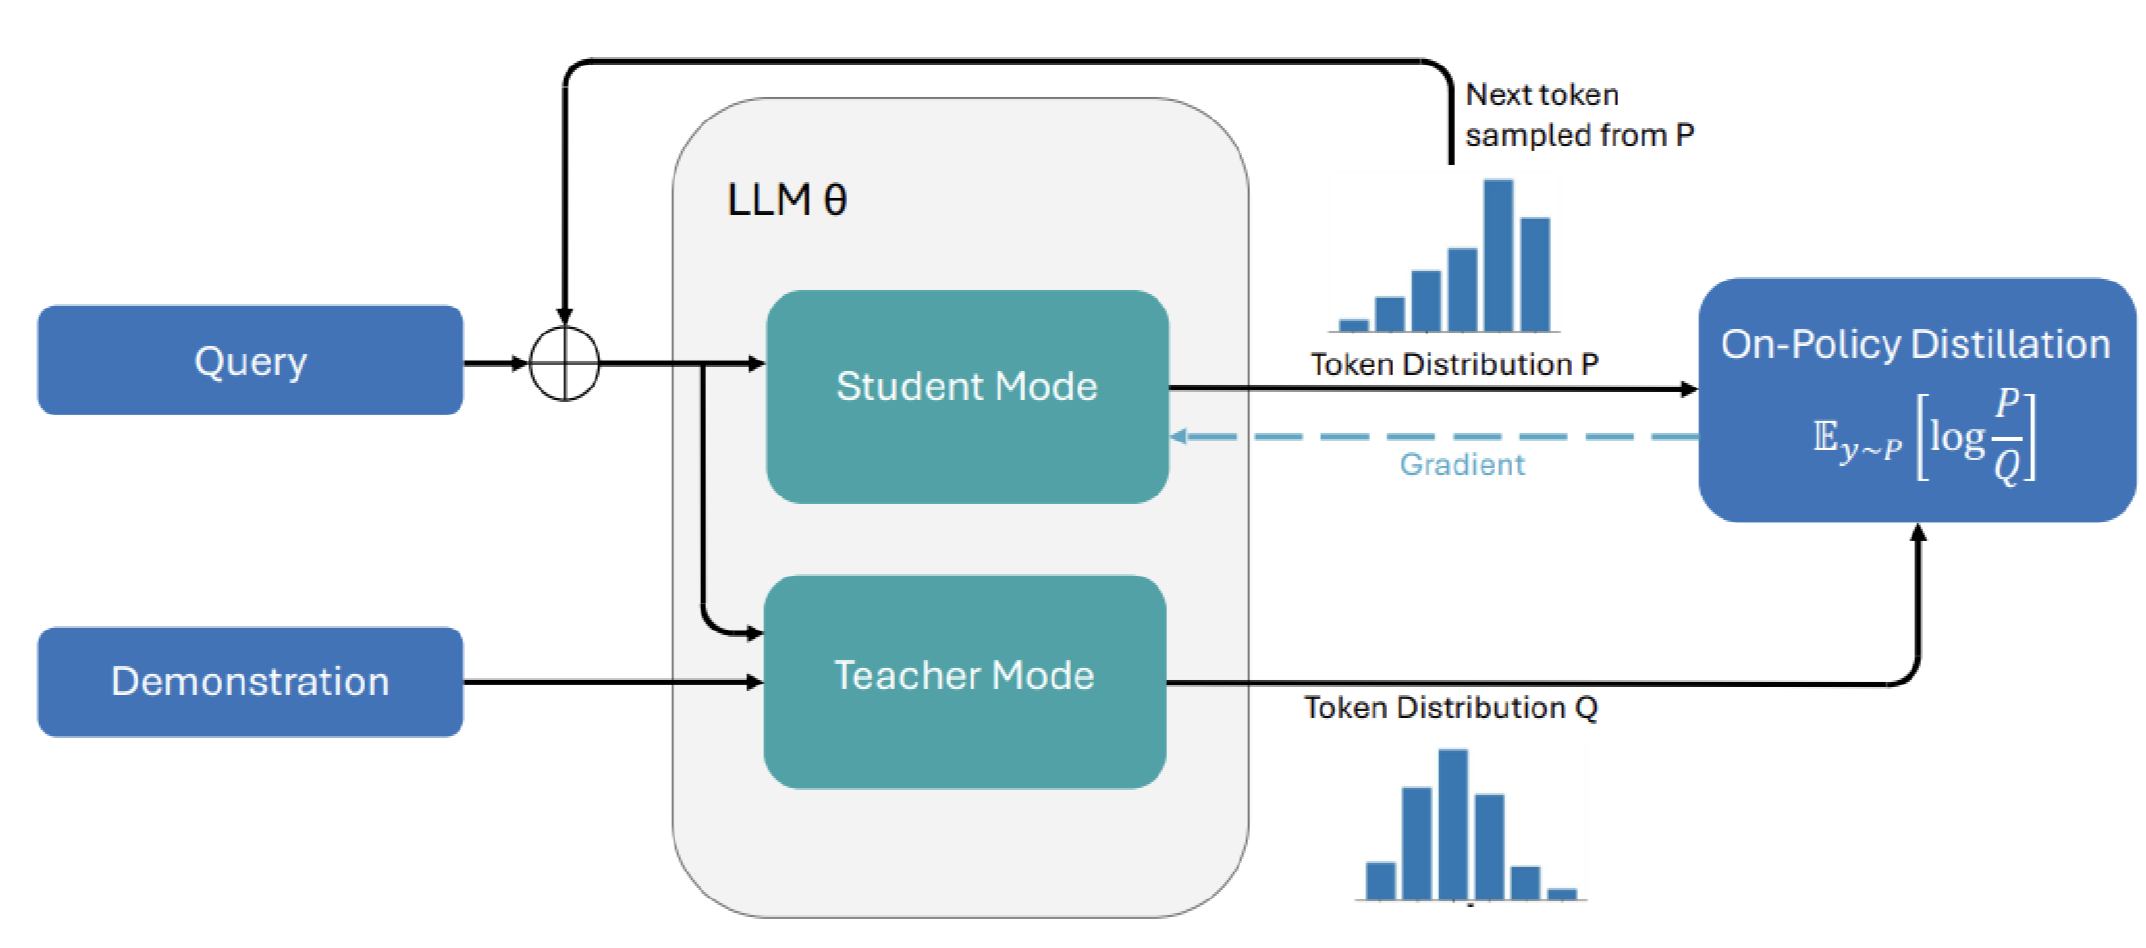
A autodestilação on-policy (OPSD) tornou-se rapidamente um tema central na pesquisa em aprendizado de máquina. Embora suas estruturas se apoiem em abordagens mais antigas e consolidadas, os primeiros artigos sobre o tema surgiram somente no final de janeiro de 2026, e várias dezenas se seguiram em um curto período. Este artigo explora a literatura sobre OPSD, principalmente pela ótica da estrutura de Autodestilação para Ajuste Fino (SDFT), apresentada por Shenfeld et al. em "Self-distillation enables continual learning".
O termo "aprendizado contínuo" no título desse artigo refere-se à capacidade de um modelo aprender de forma eficaz e dinâmica a partir de um fluxo de dados. O texto começa examinando o problema que as estruturas OPSD buscam resolver: o esquecimento catastrófico, em que modelos perdem a capacidade de lidar com tarefas antigas à medida que aprendem novas. Conforme os modelos fundacionais se tornam mais poderosos, o pós-treinamento para tarefas complexas ou personalizadas torna-se essencial, pois o pré-treinamento do zero é proibitivamente caro.
Em seguida, o artigo analisa como o SDFT funciona e as explicações teóricas para seu sucesso. Os experimentos relatados no artigo mostram resultados promissores, reforçando a perspectiva de ampla aplicabilidade do OPSD. Por fim, aborda duas preocupações centrais que surgiram em relação ao método.
Fonte: Towards Data Science · Resumido por HeadlinesBriefing