
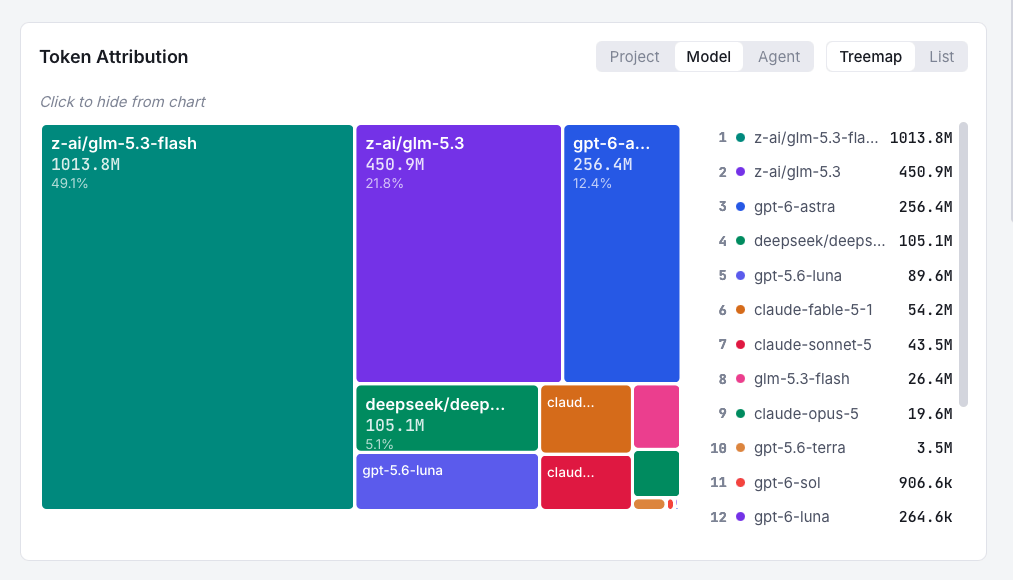
मॉडल विभाजन पर विशेष रूप से ध्यान केंद्रित करते हुए: लक्ष्य पूरे महीने GLM 5.3 Flash (टील रंग में) पर बिताना था। यहाँ अच्छा रहा: सफलतापूर्वक महीने का पहला भाग केवल उस मॉडल पर बिताया। उस मॉडल का उपयोग हमारे बजट ($68, लगभग 4 kWh ऊर्जा उपयोग / 365 ग्राम कार्बन उत्सर्जन) के भीतर था। महीने का दूसरा भाग उतना अच्छा नहीं रहा, 1B टोकन अन्य मॉडलों में गए।
हमने प्रोटोटाइप के लिए 'गलत' मॉडल चुना, और लगभग रातोंरात 450M टोकन / $150 / 5 kWh ऊर्जा उपयोग खर्च किया। हम संभवतः 5 गुना कम लागत पर समान परिणाम प्राप्त कर सकते थे। एक और अप्रत्याशित बाधा बुनियादी ढांचे की उपलब्धता थी। हमने GLM 5.3 Flash के प्रदर्शन में गिरावट देखी, जिससे Deep Seek V4.1 Flash और Qwen 3.8 Flash जैसे अन्य मॉडलों पर स्विच करना पड़ा।
तो तकनीकी रूप से यह चुनौती विफल रही। लक्ष्य मॉडल पर केवल 50% उपयोग, 2B में से 1B टोकन। लगभग 35 kWh ऊर्जा उपयोग 10 के बजाय। लेकिन हमने बहुत कुछ सीखा। अक्टूबर के लिए इस पर विचार करते हुए, यहाँ वह है जो इसे काम करेगा: निरंतर, स्थानीय उपयोग माप और रिपोर्टिंग। प्रयोग के लिए बजट। इस बारे में अधिक ठोस निर्णय कि कौन से प्रोटोटाइप बनाने लायक हैं।
दैनिक डेवलपर कार्य के लिए, एक या दो फ्लैश-स्तरीय सस्ते मॉडल पर ध्यान केंद्रित करना पूरी तरह से व्यवहार्य है। एक व्यवहार्य लक्ष्य यह है कि अधिकांश AI अनुमान कार्य ऐसे कुशल मॉडलों के साथ किया जाना चाहिए, जिसे लागत या ऊर्जा उपयोग में मापा जाए, न कि अर्थहीन टोकन में। अक्टूबर के लिए यही लक्ष्य है!
स्रोत: Hacker News · HeadlinesBriefing द्वारा सारांशित