
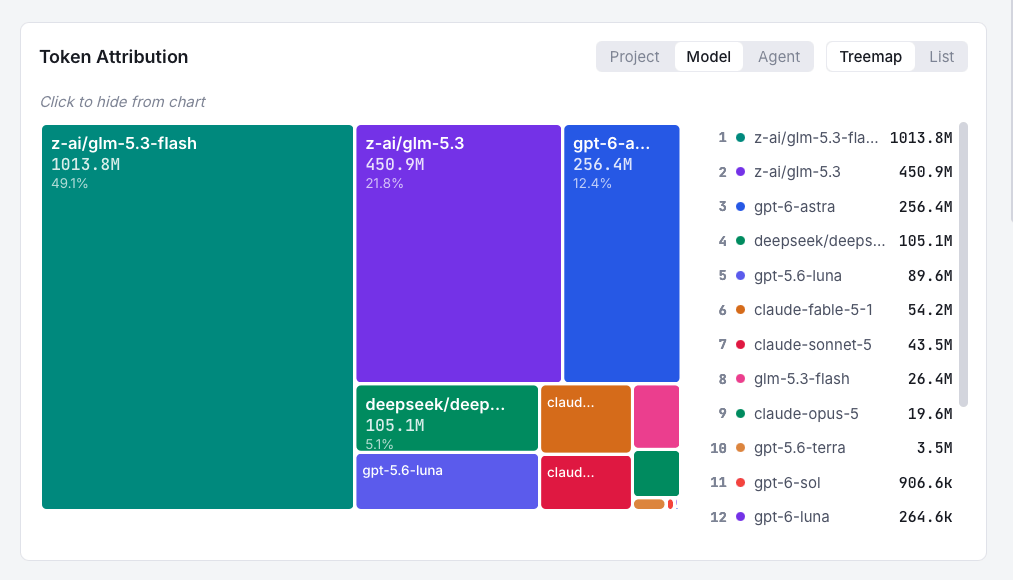
En se concentrant spécifiquement sur la répartition des modèles : L'objectif était de passer tout le mois sur GLM 5.3 Flash (en teal). Voici ce qui a bien fonctionné : Nous avons passé avec succès la première moitié du mois uniquement sur ce modèle. L'utilisation de ce modèle était bien dans notre budget (68 $, environ 4 kWh d'utilisation d'énergie / 365 grammes d'émissions de carbone). La deuxième moitié du mois ne s'est pas aussi bien passée, avec 1B jetons allant à d'autres modèles.
Nous avons choisi le 'mauvais' modèle pour le prototype, et avons dépensé 450M jetons / 150 $ / 5 kWh d'utilisation d'énergie presque du jour au lendemain. Nous aurions pu obtenir des résultats similaires probablement avec 5 fois moins de coût. Un autre obstacle inattendu était les problèmes de disponibilité de l'infrastructure. Nous avons noté une dégradation des performances de GLM 5.3 Flash, devant passer à d'autres modèles comme Deep Seek V4.1 Flash et Qwen 3.8 Flash.
Donc techniquement, ce défi était un échec. Seulement 50% d'utilisation sur le modèle cible, 1B sur 2B jetons. Environ 35 kWh d'utilisation d'énergie au lieu de 10. Mais nous avons beaucoup appris. En réfléchissant à cela pour octobre, voici ce qui le fera fonctionner : Mesure et rapport d'utilisation locale constants. Budget pour l'expérimentation. Décisions plus concertées sur les prototypes qui valent la peine d'être construits.
Pour le travail quotidien des développeurs, il est tout à fait viable de se concentrer sur un ou deux modèles bon marché de niveau flash. Un objectif viable est que la majorité du travail d'inférence IA soit effectuée avec de tels modèles efficaces, mesurés en coût ou en utilisation d'énergie plutôt qu'en jetons sans signification. C'est l'objectif pour octobre !
Source: Hacker News · Résumé par HeadlinesBriefing