
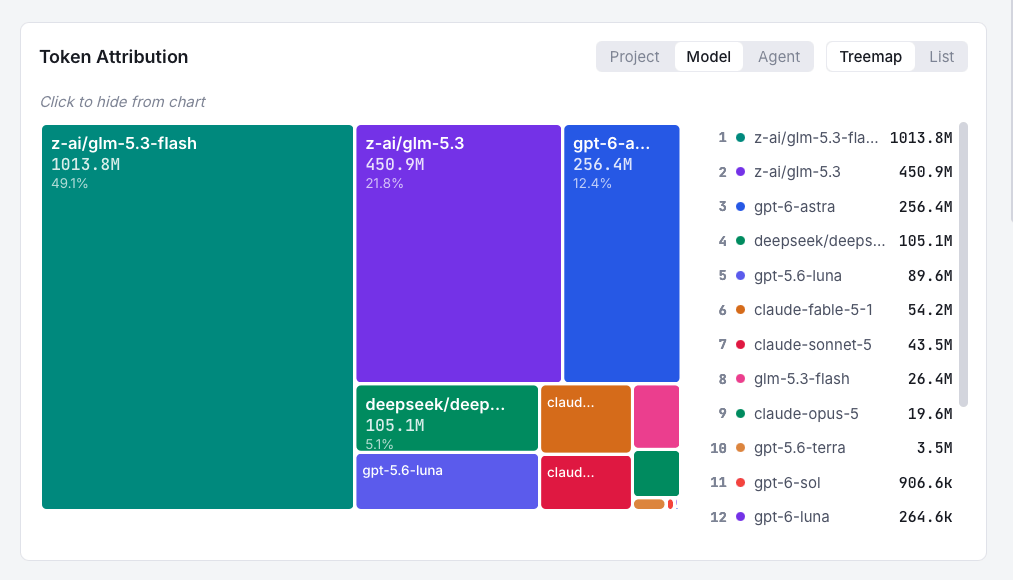
モデルの分割に特に焦点を当てると、目標は月全体を GLM 5.3 Flash(ティール色)に費やすことでした。うまくいった点は、月の前半をそのモデルだけで過ごせたことです。そのモデルの使用量は予算内(68ドル、約4 kWhのエネルギー使用 / 365グラムの炭素排出)でした。月の後半はあまりうまくいかず、10億トークンが他のモデルに流れました。
プロトタイプに「間違った」モデルを選び、ほぼ一晩で4億5,000万トークン / 150ドル / 5 kWhのエネルギー使用を費やしました。おそらく5分の1のコストで同様の結果を得られたでしょう。もう一つの予期せぬ障害は、インフラストラクチャの可用性問題でした。GLM 5.3 Flashのパフォーマンス低下に気づき、Deep Seek V4.1 FlashやQwen 3.8 Flashなどの他のモデルに切り替える必要がありました。
技術的には、このチャレンジは失敗でした。ターゲットモデルの使用率はわずか50%、20億トークンのうち10億トークン。エネルギー使用は10ではなく約35 kWhでした。しかし、多くを学びました。10月に向けて振り返ると、成功させるためのポイントは次のとおりです:継続的なローカル使用量の測定とレポート。実験のための予算。どのプロトタイプを構築する価値があるかについて、より協調的な決定。
日常の開発作業では、1つか2つのフラッシュ層の安価なモデルに焦点を当てることは完全に実行可能です。実行可能な目標は、AI推論作業の大部分をこのような効率的なモデルで行い、無意味なトークンではなくコストやエネルギー使用量で測定することです。それが10月の目標です!
出典: Hacker News · 要約:HeadlinesBriefing