
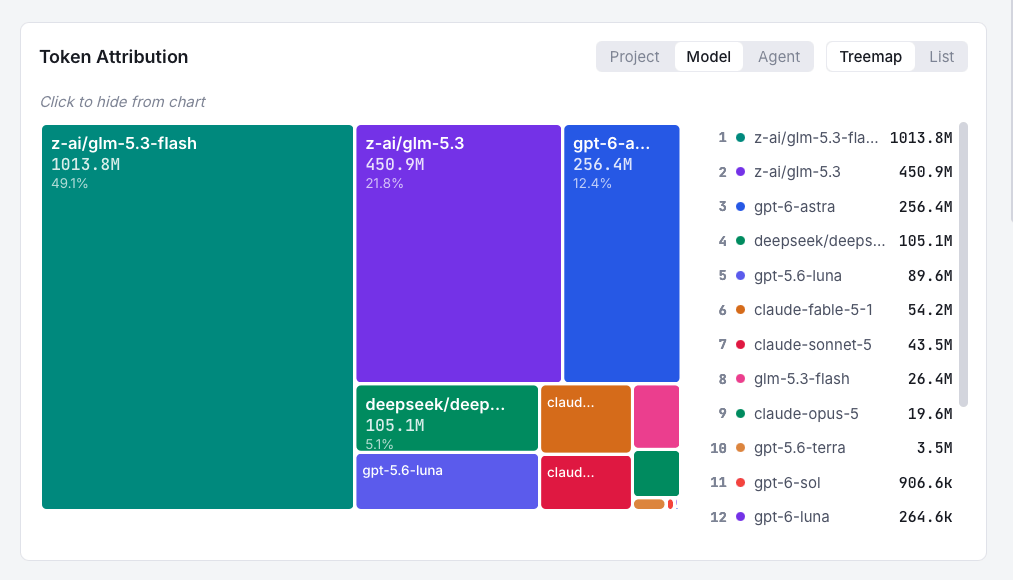
মডেল বিভাজনে বিশেষভাবে মনোযোগ দিয়ে: লক্ষ্য ছিল পুরো মাস GLM 5.3 Flash (টিল রঙে) ব্যবহার করা। এখানে যা ভালো হয়েছে: সফলভাবে মাসের প্রথমার্ধ শুধুমাত্র সেই মডেলে কাটিয়েছি। সেই মডেলের ব্যবহার আমাদের বাজেটের ($68, প্রায় 4 kWh শক্তি ব্যবহার / 365 গ্রাম কার্বন নির্গমন) মধ্যে ছিল। মাসের দ্বিতীয়ার্ধ তেমন ভালো যায়নি, 1B টোকেন অন্যান্য মডেলে গেছে।
আমরা প্রোটোটাইপের জন্য 'ভুল' মডেল বেছে নিয়েছিলাম, এবং প্রায় রাতারাতি 450M টোকেন / $150 / 5 kWh শক্তি ব্যবহার খরচ করেছি। আমরা সম্ভবত 5 গুণ কম খরচে অনুরূপ ফলাফল অর্জন করতে পারতাম। আরেকটি অপ্রত্যাশিত বাধা ছিল অবকাঠামো প্রাপ্যতা সমস্যা। আমরা GLM 5.3 Flash এর কর্মক্ষমতা হ্রাস লক্ষ্য করেছি, Deep Seek V4.1 Flash এবং Qwen 3.8 Flash এর মতো অন্যান্য মডেলে স্যুইচ করতে হয়েছে।
তাই প্রযুক্তিগতভাবে এই চ্যালেঞ্জটি ব্যর্থ ছিল। লক্ষ্য মডেলে মাত্র 50% ব্যবহার, 2B এর মধ্যে 1B টোকেন। প্রায় 35 kWh শক্তি ব্যবহার 10 এর পরিবর্তে। কিন্তু আমরা অনেক কিছু শিখেছি। অক্টোবরের জন্য এটি প্রতিফলিত করে, এখানে যা এটিকে কাজ করবে: ধ্রুবক, স্থানীয় ব্যবহার পরিমাপ এবং রিপোর্টিং। পরীক্ষা-নিরীক্ষার জন্য বাজেট। কোন প্রোটোটাইপ তৈরি করার যোগ্য তা নিয়ে আরও সমন্বিত সিদ্ধান্ত।
দৈনন্দিন ডেভেলপার কাজের জন্য, এক বা দুটি ফ্ল্যাশ-স্তরের সস্তা মডেলে ফোকাস করা সম্পূর্ণ সম্ভব। একটি সম্ভাব্য লক্ষ্য হল যে বেশিরভাগ AI ইনফারেন্স কাজ এই ধরনের দক্ষ মডেল দিয়ে করা উচিত, খরচ বা শক্তি ব্যবহারে পরিমাপ করা, অর্থহীন টোকেনের পরিবর্তে। অক্টোবরের জন্য এটাই লক্ষ্য!
উৎস: Hacker News · সারাংশ: HeadlinesBriefing