
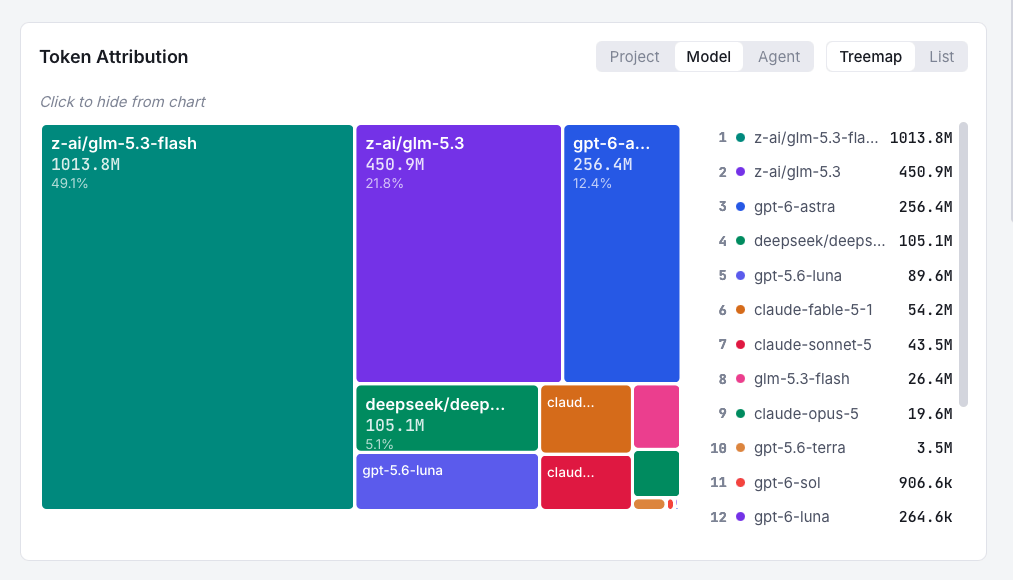
Centrándonos en la división de modelos específicamente: El objetivo era pasar todo el mes en GLM 5.3 Flash (en teal). Lo que salió bien: Pasamos con éxito la primera mitad del mes solo en ese modelo. El uso de ese modelo estuvo dentro de nuestro presupuesto ($68, aproximadamente 4 kWh de uso de energía / 365 gramos de emisiones de carbono). La segunda mitad del mes no fue tan bien, con 1B tokens yendo a otros modelos.
Elegimos el modelo 'incorrecto' para el prototipo, y gastamos 450M tokens / $150 / 5 kWh de uso de energía casi de la noche a la mañana. Podríamos haber logrado resultados similares probablemente con 5 veces menos costo. Otro obstáculo inesperado fue la disponibilidad de infraestructura. Notamos degradación en el rendimiento de GLM 5.3 Flash, teniendo que cambiar a otros modelos como Deep Seek V4.1 Flash y Qwen 3.8 Flash.
Así que técnicamente este desafío fue un fracaso. Solo 50% de uso en el modelo objetivo, 1B de 2B tokens. Alrededor de 35 kWh de uso de energía en lugar de 10. Pero aprendimos mucho. Reflexionando sobre esto para octubre, esto es lo que lo hará funcionar: Medición y reporte de uso local constante. Presupuesto para experimentación. Decisiones más concertadas sobre qué prototipos vale la pena construir.
Para el trabajo diario de desarrollo, es totalmente viable centrarse en uno o dos modelos baratos de nivel flash. Un objetivo viable es que la mayoría del trabajo de inferencia de IA se haga con tales modelos eficientes, medidos en costo o uso de energía en lugar de tokens sin sentido. ¡Ese es el objetivo para octubre!
Fuente: Hacker News · Resumido por HeadlinesBriefing