
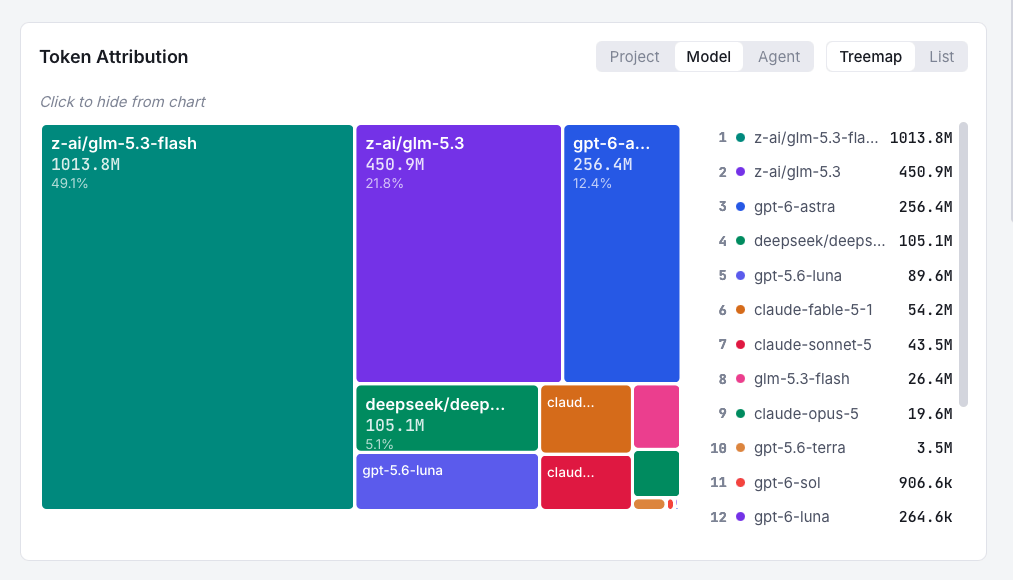
Konkret auf die Modellaufteilung fokussiert: Das Ziel war, den ganzen Monat mit GLM 5.3 Flash (in Türkis) zu verbringen. Hier ist, was gut lief: Wir verbrachten erfolgreich die erste Hälfte des Monats nur mit diesem Modell. Die Nutzung dieses Modells lag gut innerhalb unseres Budgets (68 $, etwa 4 kWh Energieverbrauch / 365 Gramm Kohlenstoffemissionen). Die zweite Hälfte des Monats lief nicht so gut, mit 1B Token, die an andere Modelle gingen.
Wir wählten das 'falsche' Modell für den Prototyp und gaben fast über Nacht 450M Token / 150 $ / 5 kWh Energieverbrauch aus. Wir hätten ähnliche Ergebnisse wahrscheinlich mit 5-mal weniger Kosten erzielen können. Ein weiteres unerwartetes Hindernis waren Infrastrukturverfügbarkeitsprobleme. Wir stellten eine Verschlechterung der Leistung von GLM 5.3 Flash fest und mussten auf andere Modelle wie Deep Seek V4.1 Flash und Qwen 3.8 Flash umsteigen.
Technisch gesehen war diese Herausforderung also ein Fehlschlag. Nur 50% Nutzung des Zielmodells, 1B von 2B Token. Etwa 35 kWh Energieverbrauch statt 10. Aber wir haben viel gelernt. Wenn wir für Oktober darüber nachdenken, hier ist, was es zum Funktionieren bringen wird: Ständige lokale Nutzungsmessung und Berichterstattung. Budget für Experimente. Abgestimmtere Entscheidungen darüber, welche Prototypen es wert sind, gebaut zu werden.
Für die tägliche Entwicklerarbeit ist es völlig machbar, sich auf ein oder zwei günstige Flash-Level-Modelle zu konzentrieren. Ein realistisches Ziel ist, dass der Großteil der KI-Inferenzarbeit mit solchen effizienten Modellen durchgeführt wird, gemessen an Kosten oder Energieverbrauch statt an bedeutungslosen Token. Das ist das Ziel für Oktober!
Quelle: Hacker News · Zusammengefasst von HeadlinesBriefing