
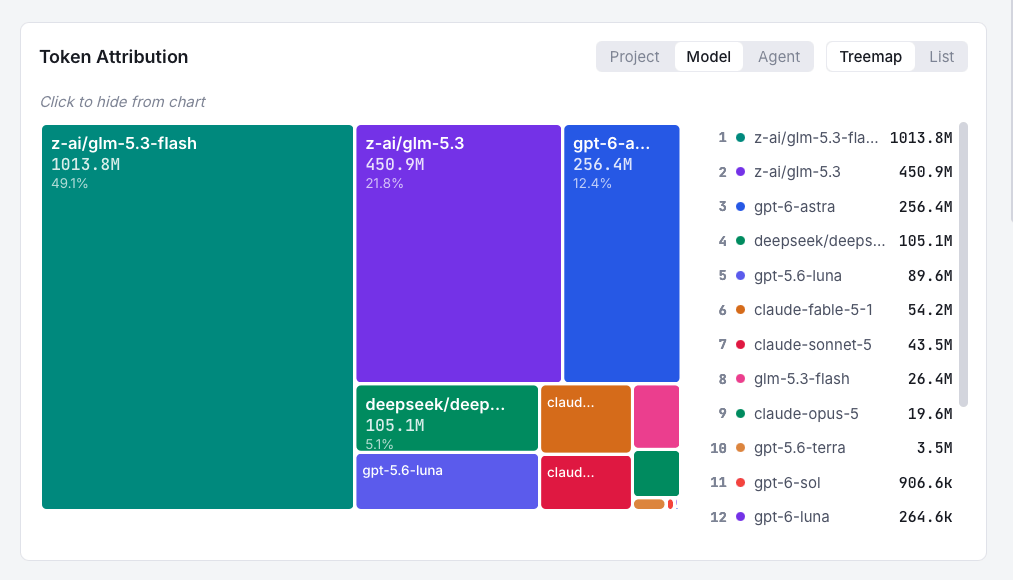
Focando especificamente na divisão de modelos: O objetivo era passar o mês inteiro no GLM 5.3 Flash (em teal). Aqui está o que deu certo: Passamos com sucesso a primeira metade do mês apenas nesse modelo. O uso desse modelo estava bem dentro do nosso orçamento ($68, cerca de 4 kWh de uso de energia / 365 gramas de emissões de carbono). A segunda metade do mês não foi tão bem, com 1B tokens indo para outros modelos.
Escolhemos o modelo 'errado' para o protótipo e gastamos 450M tokens / $150 / 5 kWh de uso de energia quase da noite para o dia. Poderíamos ter alcançado resultados semelhantes provavelmente com 5 vezes menos custo. Outro obstáculo inesperado foi a disponibilidade de infraestrutura. Notamos degradação no desempenho do GLM 5.3 Flash, tendo que mudar para outros modelos como Deep Seek V4.1 Flash e Qwen 3.8 Flash.
Então, tecnicamente, esse desafio foi um fracasso. Apenas 50% de uso no modelo alvo, 1B de 2B tokens. Cerca de 35 kWh de uso de energia em vez de 10. Mas aprendemos muito. Refletindo sobre isso para outubro, aqui está o que fará funcionar: Medição e relatório de uso local constantes. Orçamento para experimentação. Decisões mais concertadas sobre quais protótipos valem a pena construir.
Para o trabalho diário de desenvolvimento, é totalmente viável focar em um ou dois modelos baratos de nível flash. Um alvo viável é que a maioria do trabalho de inferência de IA seja feita com esses modelos eficientes, medidos em custo ou uso de energia em vez de tokens sem sentido. Esse é o objetivo para outubro!
Fonte: Hacker News · Resumido por HeadlinesBriefing