
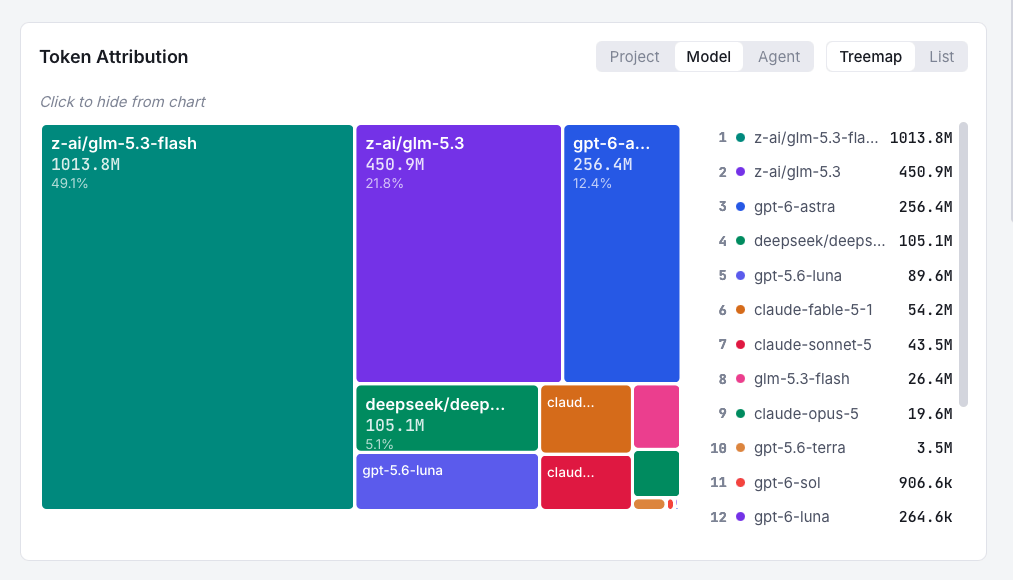
Berfokus secara khusus pada pembagian model: Tujuannya adalah menghabiskan seluruh bulan dengan GLM 5.3 Flash (berwarna teal). Inilah yang berjalan baik: Berhasil menghabiskan paruh pertama bulan hanya dengan model itu. Penggunaan model tersebut berada dalam anggaran kami ($68, sekitar 4 kWh penggunaan energi / 365 gram emisi karbon). Paruh kedua bulan tidak berjalan baik, dengan 1B token digunakan untuk model lain.
Kami memilih model yang 'salah' untuk prototipe, dan menghabiskan 450M token / $150 / 5 kWh penggunaan energi hampir dalam semalam. Kami mungkin bisa mencapai hasil serupa dengan biaya 5 kali lebih murah. Hambatan tak terduga lainnya adalah masalah ketersediaan infrastruktur. Kami melihat penurunan kinerja GLM 5.3 Flash, sehingga harus beralih ke model lain seperti Deep Seek V4.1 Flash dan Qwen 3.8 Flash.
Jadi secara teknis tantangan ini gagal. Hanya 50% penggunaan pada model target, 1B dari 2B token. Sekitar 35 kWh penggunaan energi, bukan 10. Tapi kami banyak belajar. Merefleksikan ini untuk Oktober, inilah yang akan membuatnya berhasil: Pengukuran dan pelaporan penggunaan lokal yang konstan. Anggaran untuk eksperimen. Keputusan yang lebih terkoordinasi tentang prototipe mana yang layak dibangun.
Untuk pekerjaan pengembang sehari-hari, sangat layak untuk fokus pada satu atau dua model murah tingkat flash. Target yang layak adalah mayoritas pekerjaan inferensi AI dilakukan dengan model efisien seperti itu, diukur dengan biaya atau penggunaan energi, bukan token yang tidak berarti. Itulah tujuan untuk Oktober!
Sumber: Hacker News · Diringkas oleh HeadlinesBriefing