
कैशिंग बड़े पैमाने के सिस्टम डिज़ाइन की एक मूल तकनीक है। यह उन डेटा को संग्रहीत करती है जिनकी गणना महंगी होती है, ताकि उन्हें बाद में बिना दोबारा वही लागत चुकाए इस्तेमाल किया जा सके। उदाहरण के लिए, कोई वेबसाइट हर पेज लोड पर डेटाबेस क्वेरी चलाने के बजाय उसका परिणाम कैश कर सकती है।
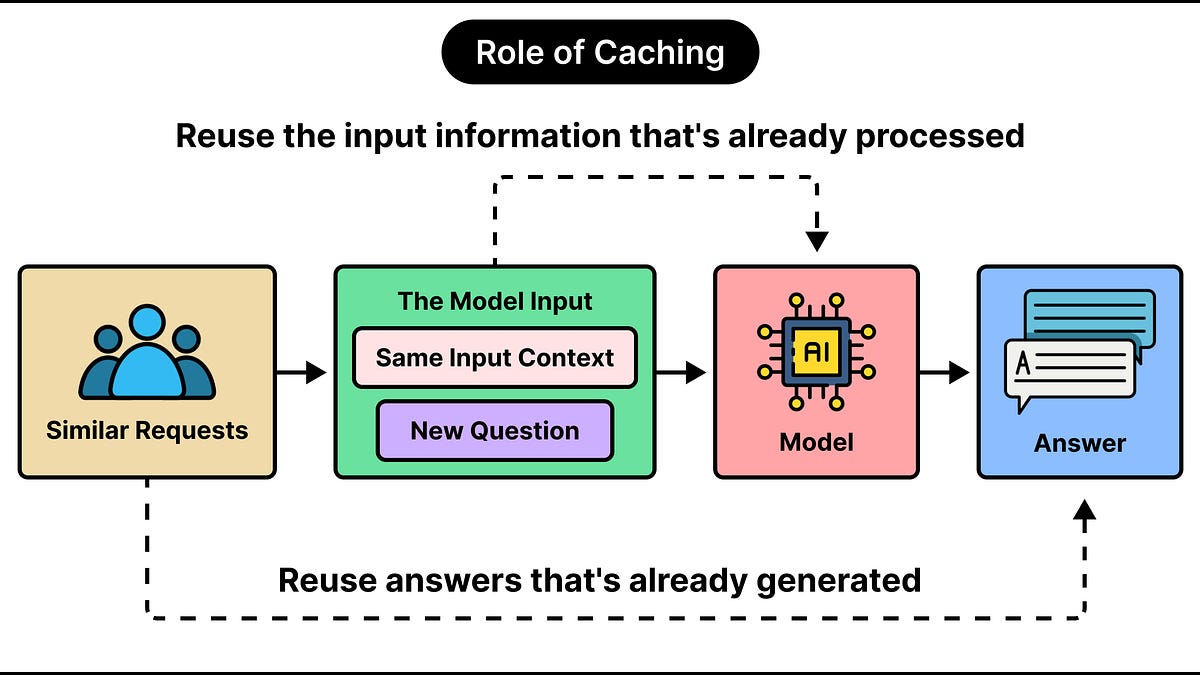
यही सिद्धांत बड़े भाषा मॉडलों (LLM) पर भी लागू होता है। LLM एप्लिकेशन में कैशिंग का मतलब है पिछले अनुरोधों में किए गए काम को संग्रहीत करना ताकि उसे दोबारा इस्तेमाल किया जा सके। इससे प्रोसेसिंग लागत और प्रतिक्रिया समय घटते हैं, खासकर तब जब अनुरोध एक ही निर्देश, दस्तावेज़ या सवाल साझा करते हों। इसके दो मुख्य तरीके हैं: प्रॉम्प्ट कैशिंग और सिमेंटिक कैशिंग। दोनों दोहराए गए काम को कम करने का लक्ष्य रखते हैं, लेकिन वे अनुरोध के अलग-अलग चरणों पर काम करते हैं और उनके नियम भी अलग हैं।
LLM की लागत मुख्यतः दो स्रोतों से आती है: इनपुट टोकन और आउटपुट टोकन। आउटपुट टोकन अक्सर अधिक महंगे होते हैं, लेकिन इनपुट टोकन भी महंगे हो सकते हैं, क्योंकि अनुरोधों में अक्सर उपयोगकर्ता के सवाल से कहीं ज़्यादा सामग्री होती है। उदाहरण के लिए, कस्टमर-सपोर्ट एप्लिकेशन 10 शब्दों के सवाल के साथ व्यवहार निर्देश, उदाहरण उत्तर, उत्पाद दस्तावेज़ और पिछले बातचीत संदेश भी भेज सकता है, जिससे हज़ारों इनपुट टोकन बन जाते हैं। जो एप्लिकेशन हर अनुरोध में लंबा उत्पाद मैनुअल भेजते हैं, वे वही सामग्री बार-बार दोहराते हैं, भले ही अलग-अलग उपयोगकर्ता उसके बारे में अलग सवाल पूछें।
दोहराव सवालों में भी दिखता है। सैकड़ों उपयोगकर्ता पूछ सकते हैं कि प्रोफ़ाइल फ़ोटो कैसे बदलें, हर कोई अलग शब्दों में, इसलिए मॉडल अक्सर लगभग एक ही उत्तर बार-बार बनाता है। इससे लागत घटाने के दो अवसर बनते हैं: पहले से संसाधित इनपुट सामग्री, जैसे उत्पाद मैनुअल, का पुनः उपयोग करना, और मूलतः एक जैसे सवालों के उत्तरों का पुनः उपयोग करना।
स्रोत: ByteByteGo · HeadlinesBriefing द्वारा सारांशित