
La mise en cache est une technique centrale de conception des systèmes à grande échelle. Elle stocke des données coûteuses à calculer afin de pouvoir les réutiliser plus tard sans payer à nouveau le même coût. Un site web, par exemple, peut mettre en cache le résultat d'une requête de base de données plutôt que de l'exécuter à chaque chargement de page.
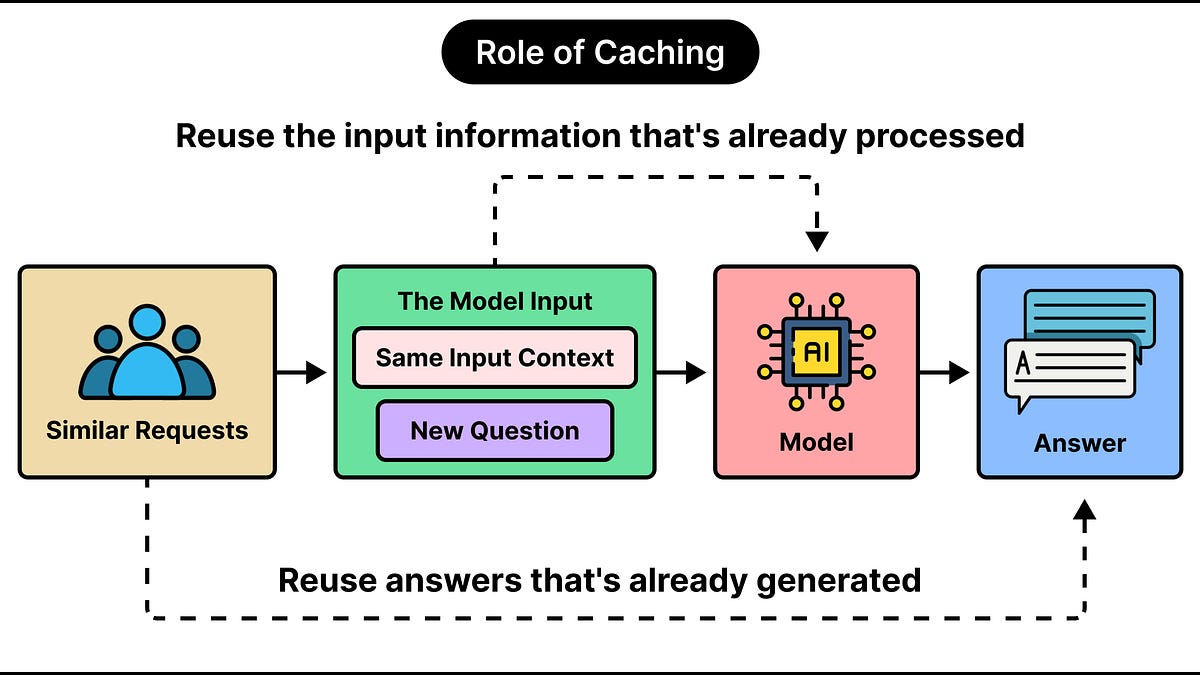
Le même principe s'applique aux grands modèles de langage. Dans les applications LLM, la mise en cache consiste à conserver le travail effectué lors des requêtes précédentes afin de le réutiliser, ce qui réduit les coûts de traitement et les temps de réponse, surtout lorsque les requêtes partagent les mêmes instructions, documents ou questions. Il existe deux approches principales : le cache de prompts et le cache sémantique. Les deux visent à réduire le travail répété, mais ils interviennent à des étapes différentes d'une requête et suivent des règles différentes.
Les coûts des LLM proviennent principalement de deux sources : les jetons d'entrée et les jetons de sortie. Les jetons de sortie coûtent souvent plus cher, mais les jetons d'entrée peuvent aussi être onéreux, car les requêtes contiennent fréquemment bien plus que la question de l'utilisateur. Une application de support client, par exemple, peut envoyer des instructions de comportement, des exemples de réponses, de la documentation produit et les messages précédents de la conversation avec une question de 10 mots, ce qui produit des milliers de jetons d'entrée. Les applications qui envoient un long manuel produit à chaque requête répètent ce même contenu à chaque fois, alors que des utilisateurs différents posent des questions différentes à son sujet.
La répétition apparaît aussi dans les questions elles-mêmes. Des centaines d'utilisateurs peuvent demander comment changer leur photo de profil, chacun en des termes différents, si bien que le modèle génère souvent à plusieurs reprises à peu près la même réponse. Cela ouvre deux possibilités de réduction des coûts : réutiliser le contenu d'entrée déjà traité, comme le manuel produit, et réutiliser les réponses à des questions essentiellement identiques.
Source: ByteByteGo · Résumé par HeadlinesBriefing