
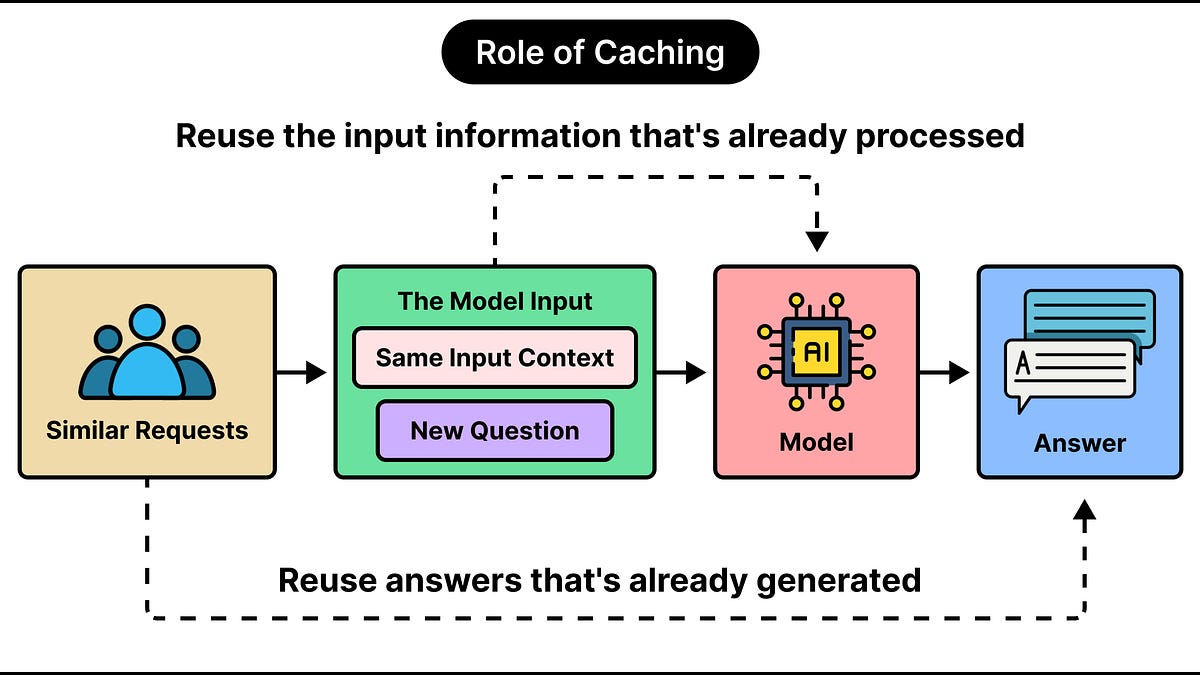
Caching adalah teknik desain sistem inti untuk sistem berskala besar. Teknik ini menyimpan data yang mahal untuk dihitung agar dapat digunakan kembali nanti tanpa harus membayar biaya yang sama lagi. Misalnya, sebuah situs web dapat menyimpan hasil kueri basis data alih-alih menjalankannya setiap kali halaman dimuat.
Prinsip yang sama berlaku untuk large language model. Caching dalam aplikasi LLM berarti menyimpan pekerjaan yang dilakukan pada permintaan sebelumnya agar dapat digunakan kembali, yang menurunkan biaya pemrosesan dan waktu respons, terutama ketika permintaan berbagi instruksi, dokumen, atau pertanyaan yang sama. Ada dua pendekatan utama: prompt caching dan semantic caching. Keduanya bertujuan mengurangi pekerjaan yang berulang, tetapi beroperasi pada tahap yang berbeda dalam sebuah permintaan dan mengikuti aturan yang berbeda.
Biaya LLM terutama berasal dari dua sumber: token input dan token output. Token output sering kali lebih mahal, tetapi token input juga bisa mahal karena permintaan sering kali menyertakan jauh lebih banyak hal daripada pertanyaan pengguna. Sebuah aplikasi dukungan pelanggan, misalnya, mungkin mengirim instruksi perilaku, contoh jawaban, dokumentasi produk, dan pesan percakapan sebelumnya bersama pertanyaan 10 kata, sehingga menghasilkan ribuan token input. Aplikasi yang mengirim manual produk yang panjang pada setiap permintaan mengulang konten yang sama setiap kali, meskipun pengguna yang berbeda mengajukan pertanyaan yang berbeda tentangnya.
Pengulangan juga muncul pada pertanyaannya sendiri. Ratusan pengguna mungkin menanyakan cara mengganti foto profil, masing-masing dengan kata-kata yang berbeda, sehingga model sering menghasilkan jawaban yang kurang lebih sama berulang kali. Hal ini membuka dua peluang untuk memangkas biaya: menggunakan kembali konten input yang sudah diproses, seperti manual produk, dan menggunakan kembali jawaban atas pertanyaan yang pada dasarnya sama.
Sumber: ByteByteGo · Diringkas oleh HeadlinesBriefing