
キャッシュは、大規模システムにおける中核的な設計技術です。計算コストの高いデータを保存しておき、同じコストを再び支払うことなく後で再利用できるようにします。例えばウェブサイトは、ページを読み込むたびにデータベースクエリを実行する代わりに、その結果をキャッシュするかもしれません。
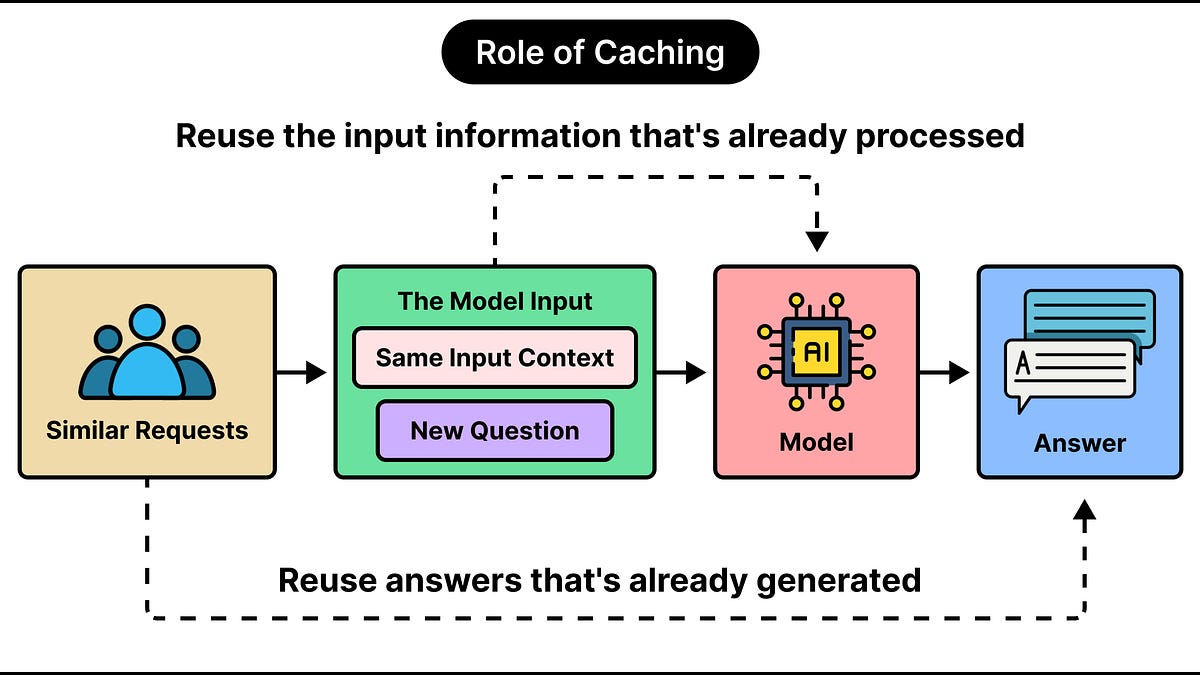
同じ原理は大規模言語モデルにも当てはまります。LLMアプリケーションにおけるキャッシュとは、以前のリクエストで行った処理を保存し、再利用できるようにすることを意味します。これにより処理コストと応答時間が下がります。特にリクエストが同じ指示、文書、質問を共有している場合に効果的です。主なアプローチは二つあります。プロンプトキャッシュとセマンティックキャッシュです。どちらも繰り返される処理を減らすことを目指しますが、リクエストの異なる段階で動作し、異なるルールに従います。
LLMのコストは主に入力トークンと出力トークンという二つの要素から生じます。出力トークンのほうが高いことが多いものの、入力トークンも高額になり得ます。リクエストにはユーザーの質問よりもはるかに多くの内容が含まれることが多いからです。例えばカスタマーサポートのアプリケーションでは、10語の質問とともに、振る舞いの指示、回答例、製品ドキュメント、過去の会話メッセージを送ることがあり、その結果数千の入力トークンが生じます。毎回のリクエストで長い製品マニュアルを送るアプリケーションは、異なるユーザーがそれについて異なる質問をするにもかかわらず、同じ内容を毎回繰り返し送信しています。
質問そのものにも繰り返しが見られます。プロフィール写真の変更方法を、何百人ものユーザーがそれぞれ異なる言い回しで尋ねるかもしれません。その結果、モデルはほぼ同じ回答を何度も生成することになります。これにより、コストを削減する機会が二つ生まれます。製品マニュアルのような、すでに処理済みの入力内容を再利用することと、実質的に同じ質問への回答を再利用することです。
出典: ByteByteGo · 要約:HeadlinesBriefing