
缓存是大规模系统中的一项核心设计技术。它将计算成本高昂的数据存储起来,以便日后重复使用,从而避免再次付出相同的成本。例如,网站可能会缓存数据库查询结果,而不是在每次加载页面时都执行该查询。
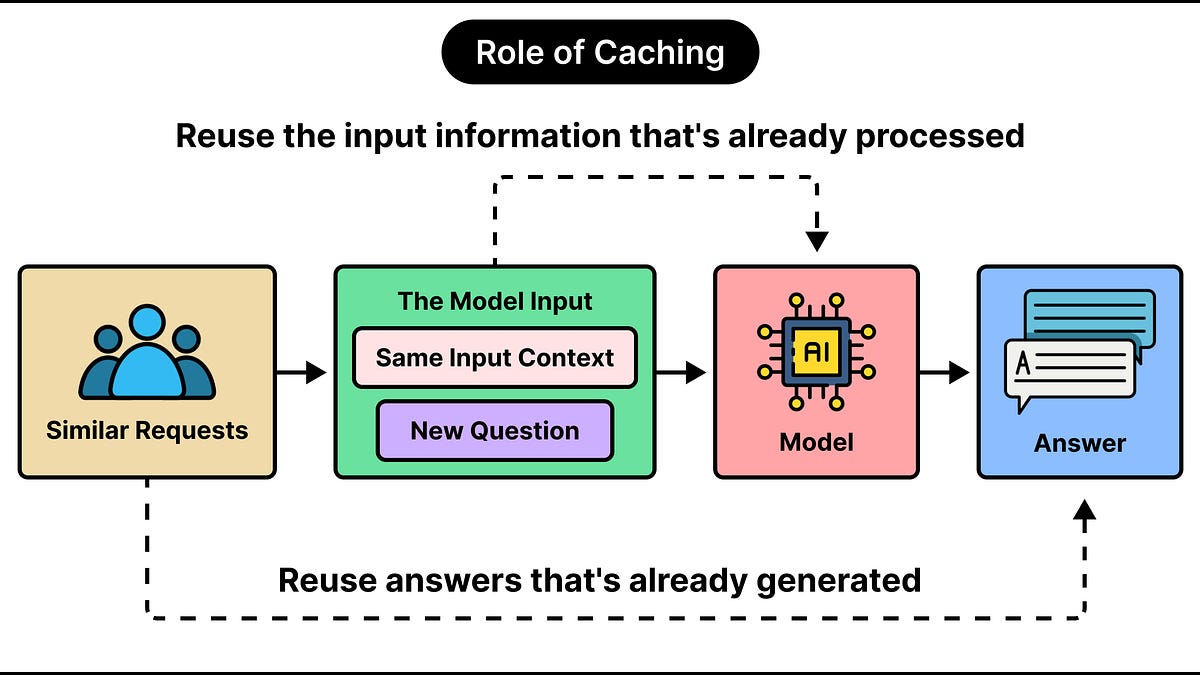
同样的原理也适用于大型语言模型。在LLM应用中,缓存是指存储先前请求中已完成的工作,以便重复使用,从而降低处理成本和响应时间,尤其是在请求共享相同指令、文档或问题的情况下。主要有两种方法:提示缓存和语义缓存。两者都旨在减少重复工作,但它们作用于请求的不同阶段,并遵循不同的规则。
LLM的成本主要来自两个方面:输入令牌和输出令牌。输出令牌通常成本更高,但输入令牌也可能很昂贵,因为请求往往包含的内容远多于用户的问题。例如,客服应用可能会在一个10个词的问题之外,还发送行为指令、示例答案、产品文档和早期的对话消息,从而产生数千个输入令牌。每次请求都发送一份长篇产品手册的应用,会在每次请求中重复相同的内容,尽管不同用户针对它提出的问题各不相同。
问题本身也存在重复。数百名用户可能都在询问如何更换头像,每个人的措辞都不同,因此模型往往一次又一次地生成大致相同的答案。这就创造了两个降低成本的机会:复用已经处理过的输入内容(例如产品手册),以及复用实质上相同问题的答案。
来源: ByteByteGo · 由HeadlinesBriefing整理摘要