
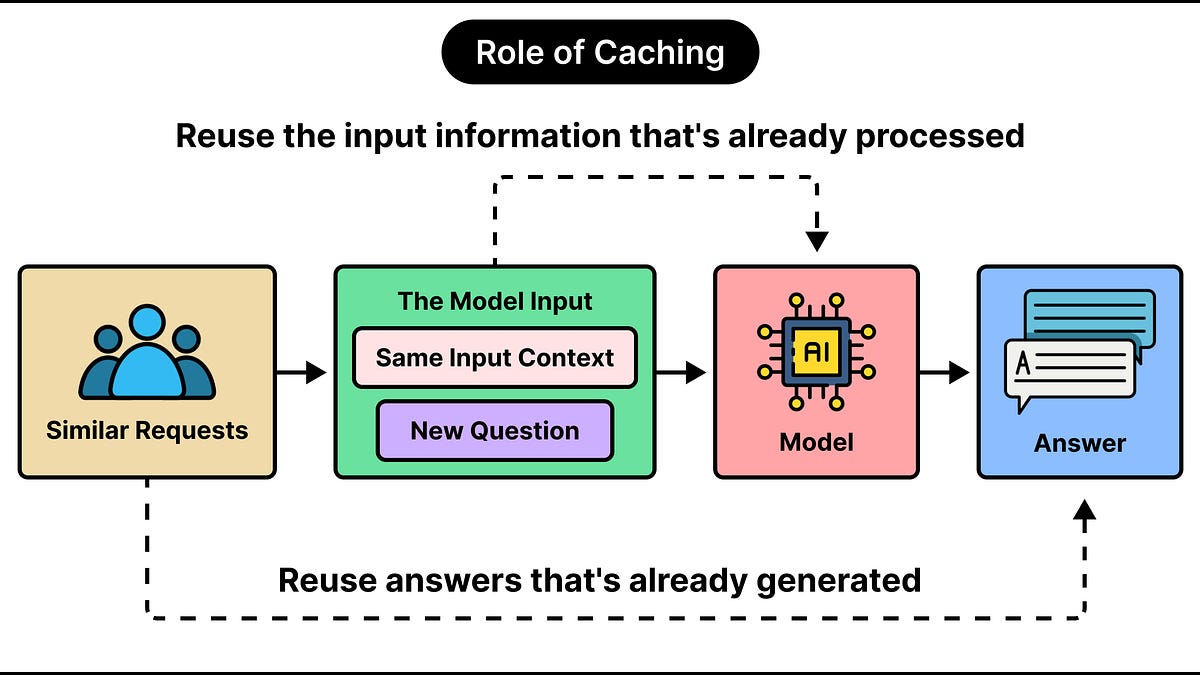
O cache é uma técnica central de design de sistemas em grande escala. Ele armazena dados que são caros de calcular para que possam ser reutilizados depois, sem pagar novamente o mesmo custo. Um site, por exemplo, pode armazenar em cache o resultado de uma consulta ao banco de dados em vez de executá-la a cada carregamento de página.
O mesmo princípio se aplica aos grandes modelos de linguagem. O cache em aplicações de LLM significa armazenar o trabalho realizado em requisições anteriores para reutilizá-lo, o que reduz os custos de processamento e os tempos de resposta, especialmente quando as requisições compartilham as mesmas instruções, documentos ou perguntas. Existem duas abordagens principais: cache de prompts e cache semântico. Ambas visam reduzir o trabalho repetido, mas atuam em estágios diferentes de uma requisição e seguem regras distintas.
Os custos de um LLM vêm principalmente de duas fontes: tokens de entrada e tokens de saída. Os tokens de saída costumam ser mais caros, mas os de entrada também podem ser onerosos, pois as requisições frequentemente incluem muito mais do que a pergunta do usuário. Um aplicativo de suporte ao cliente, por exemplo, pode enviar instruções de comportamento, respostas de exemplo, documentação do produto e mensagens anteriores da conversa junto com uma pergunta de 10 palavras, gerando milhares de tokens de entrada. Aplicações que enviam um manual do produto longo em cada requisição repetem esse mesmo conteúdo a cada vez, mesmo que usuários diferentes façam perguntas diferentes sobre ele.
A repetição também aparece nas próprias perguntas. Centenas de usuários podem perguntar como trocar a foto de perfil, cada um com suas palavras, então o modelo frequentemente gera praticamente a mesma resposta várias vezes. Isso cria duas oportunidades de reduzir custos: reutilizar conteúdo de entrada já processado, como o manual do produto, e reutilizar respostas a perguntas essencialmente iguais.
Fonte: ByteByteGo · Resumido por HeadlinesBriefing