
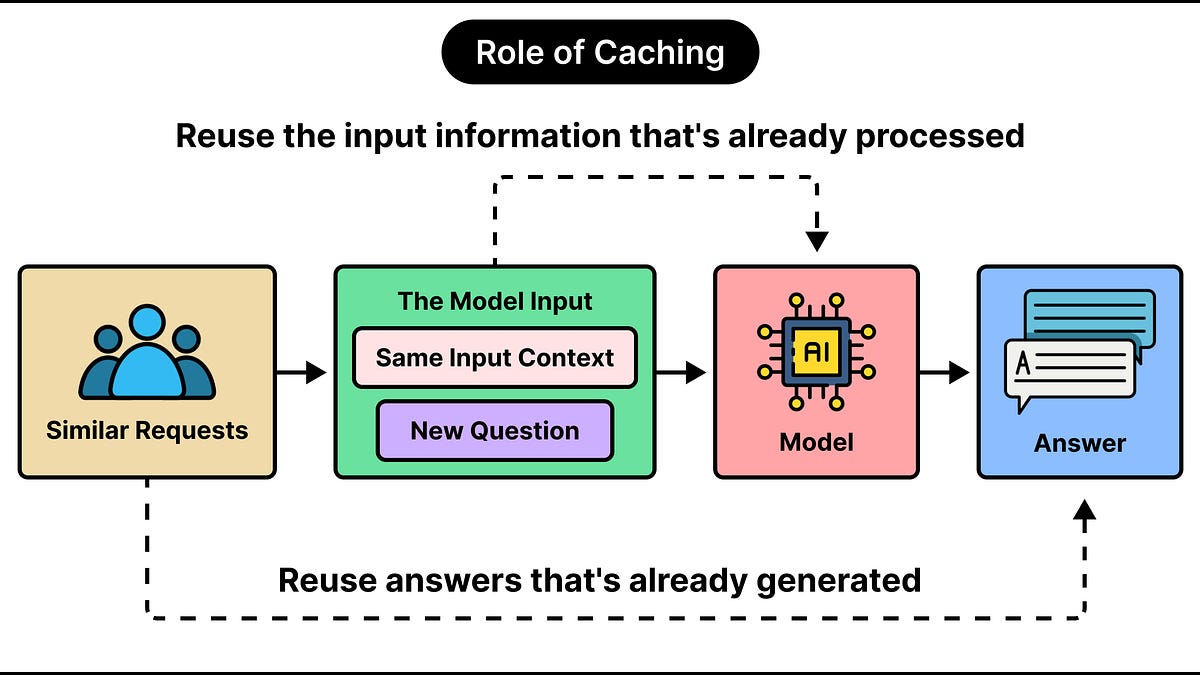
Caching ist eine zentrale Entwurfstechnik für großskalige Systeme. Es speichert Daten, deren Berechnung aufwendig ist, damit sie später wiederverwendet werden können, ohne dieselben Kosten erneut zu verursachen. Eine Website könnte beispielsweise das Ergebnis einer Datenbankabfrage zwischenspeichern, statt sie bei jedem Seitenaufruf auszuführen.
Dasselbe Prinzip gilt für große Sprachmodelle. Caching in LLM-Anwendungen bedeutet, die bei früheren Anfragen geleistete Arbeit zu speichern, um sie wiederzuverwenden. Dies senkt die Verarbeitungskosten und die Antwortzeiten, besonders wenn Anfragen dieselben Anweisungen, Dokumente oder Fragen teilen. Es gibt zwei Hauptansätze: Prompt-Caching und semantisches Caching. Beide zielen darauf ab, wiederholte Arbeit zu reduzieren, arbeiten jedoch in unterschiedlichen Phasen einer Anfrage und folgen unterschiedlichen Regeln.
Die Kosten eines LLM entstehen vor allem aus zwei Quellen: Eingabe-Tokens und Ausgabe-Tokens. Ausgabe-Tokens sind oft teurer, doch auch Eingabe-Tokens können ins Gewicht fallen, da Anfragen häufig weit mehr enthalten als die Frage des Nutzers. Eine Kundensupport-Anwendung sendet beispielsweise Verhaltensanweisungen, Beispielantworten, Produktdokumentation und frühere Gesprächsnachrichten zusammen mit einer Frage von zehn Wörtern, wodurch Tausende Eingabe-Tokens entstehen. Anwendungen, die mit jeder Anfrage ein langes Produkthandbuch senden, wiederholen denselben Inhalt immer wieder, obwohl verschiedene Nutzer unterschiedliche Fragen dazu stellen.
Wiederholungen zeigen sich auch in den Fragen selbst. Hunderte Nutzer fragen womöglich, wie sie ihr Profilbild ändern, jeder mit eigenen Worten, sodass das Modell oft immer wieder ungefähr dieselbe Antwort erzeugt. Daraus ergeben sich zwei Möglichkeiten, Kosten zu sparen: die Wiederverwendung bereits verarbeiteter Eingabeinhalte wie des Produkthandbuchs und die Wiederverwendung von Antworten auf im Wesentlichen gleiche Fragen.
Quelle: ByteByteGo · Zusammengefasst von HeadlinesBriefing