
El caché es una técnica fundamental de diseño de sistemas a gran escala. Almacena datos que son costosos de calcular para poder reutilizarlos más adelante sin volver a pagar el mismo coste. Un sitio web, por ejemplo, podría almacenar en caché el resultado de una consulta a la base de datos en lugar de ejecutarla en cada carga de página.
El mismo principio se aplica a los modelos de lenguaje de gran tamaño. El caché en las aplicaciones de LLM consiste en guardar el trabajo realizado en solicitudes anteriores para reutilizarlo, lo que reduce los costes de procesamiento y los tiempos de respuesta, especialmente cuando las solicitudes comparten las mismas instrucciones, documentos o preguntas. Existen dos enfoques principales: caché de prompts y caché semántica. Ambos buscan reducir el trabajo repetido, pero actúan en distintas etapas de una solicitud y siguen reglas diferentes.
Los costes de un LLM provienen principalmente de dos fuentes: los tokens de entrada y los tokens de salida. Los tokens de salida suelen costar más, pero los de entrada también pueden ser caros, porque las solicitudes a menudo incluyen mucho más que la pregunta del usuario. Una aplicación de atención al cliente, por ejemplo, puede enviar instrucciones de comportamiento, respuestas de ejemplo, documentación del producto y mensajes previos de la conversación junto con una pregunta de 10 palabras, lo que genera miles de tokens de entrada. Las aplicaciones que envían un manual del producto extenso con cada solicitud repiten ese mismo contenido una y otra vez, aunque distintos usuarios hagan preguntas diferentes sobre él.
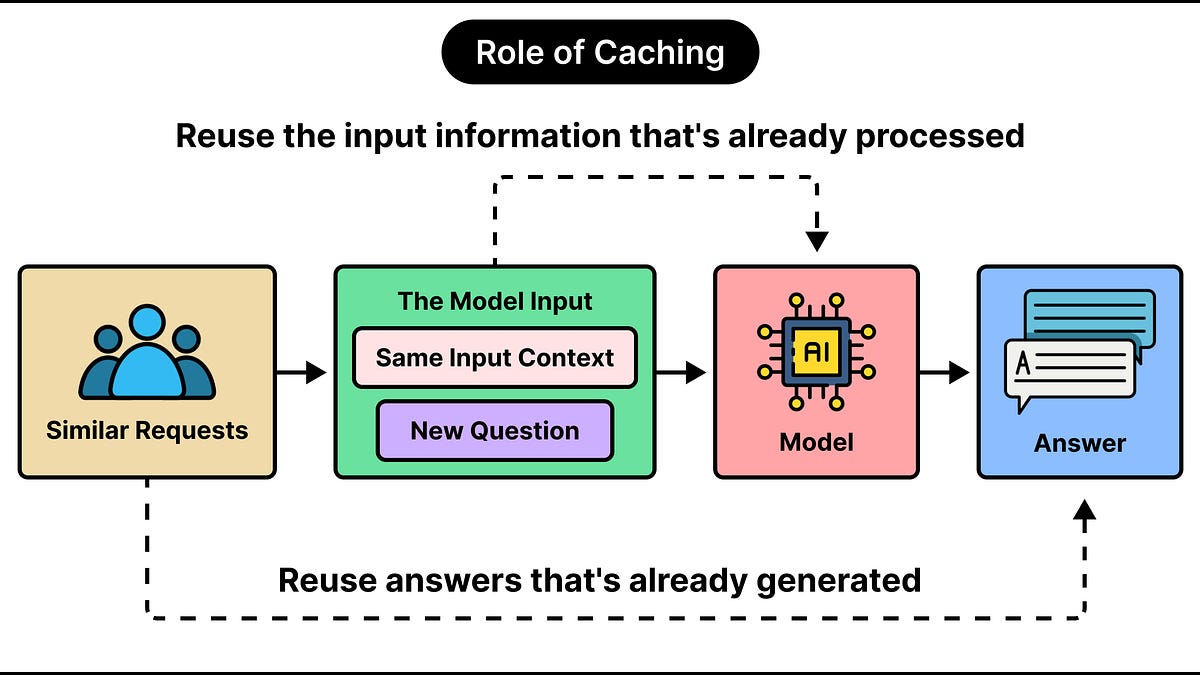
La repetición también aparece en las propias preguntas. Cientos de usuarios pueden preguntar cómo cambiar la foto de perfil, cada uno con una redacción distinta, de modo que el modelo suele generar casi la misma respuesta una y otra vez. Esto abre dos oportunidades para reducir costes: reutilizar contenido de entrada ya procesado, como el manual del producto, y reutilizar respuestas a preguntas esencialmente equivalentes.
Fuente: ByteByteGo · Resumido por HeadlinesBriefing