
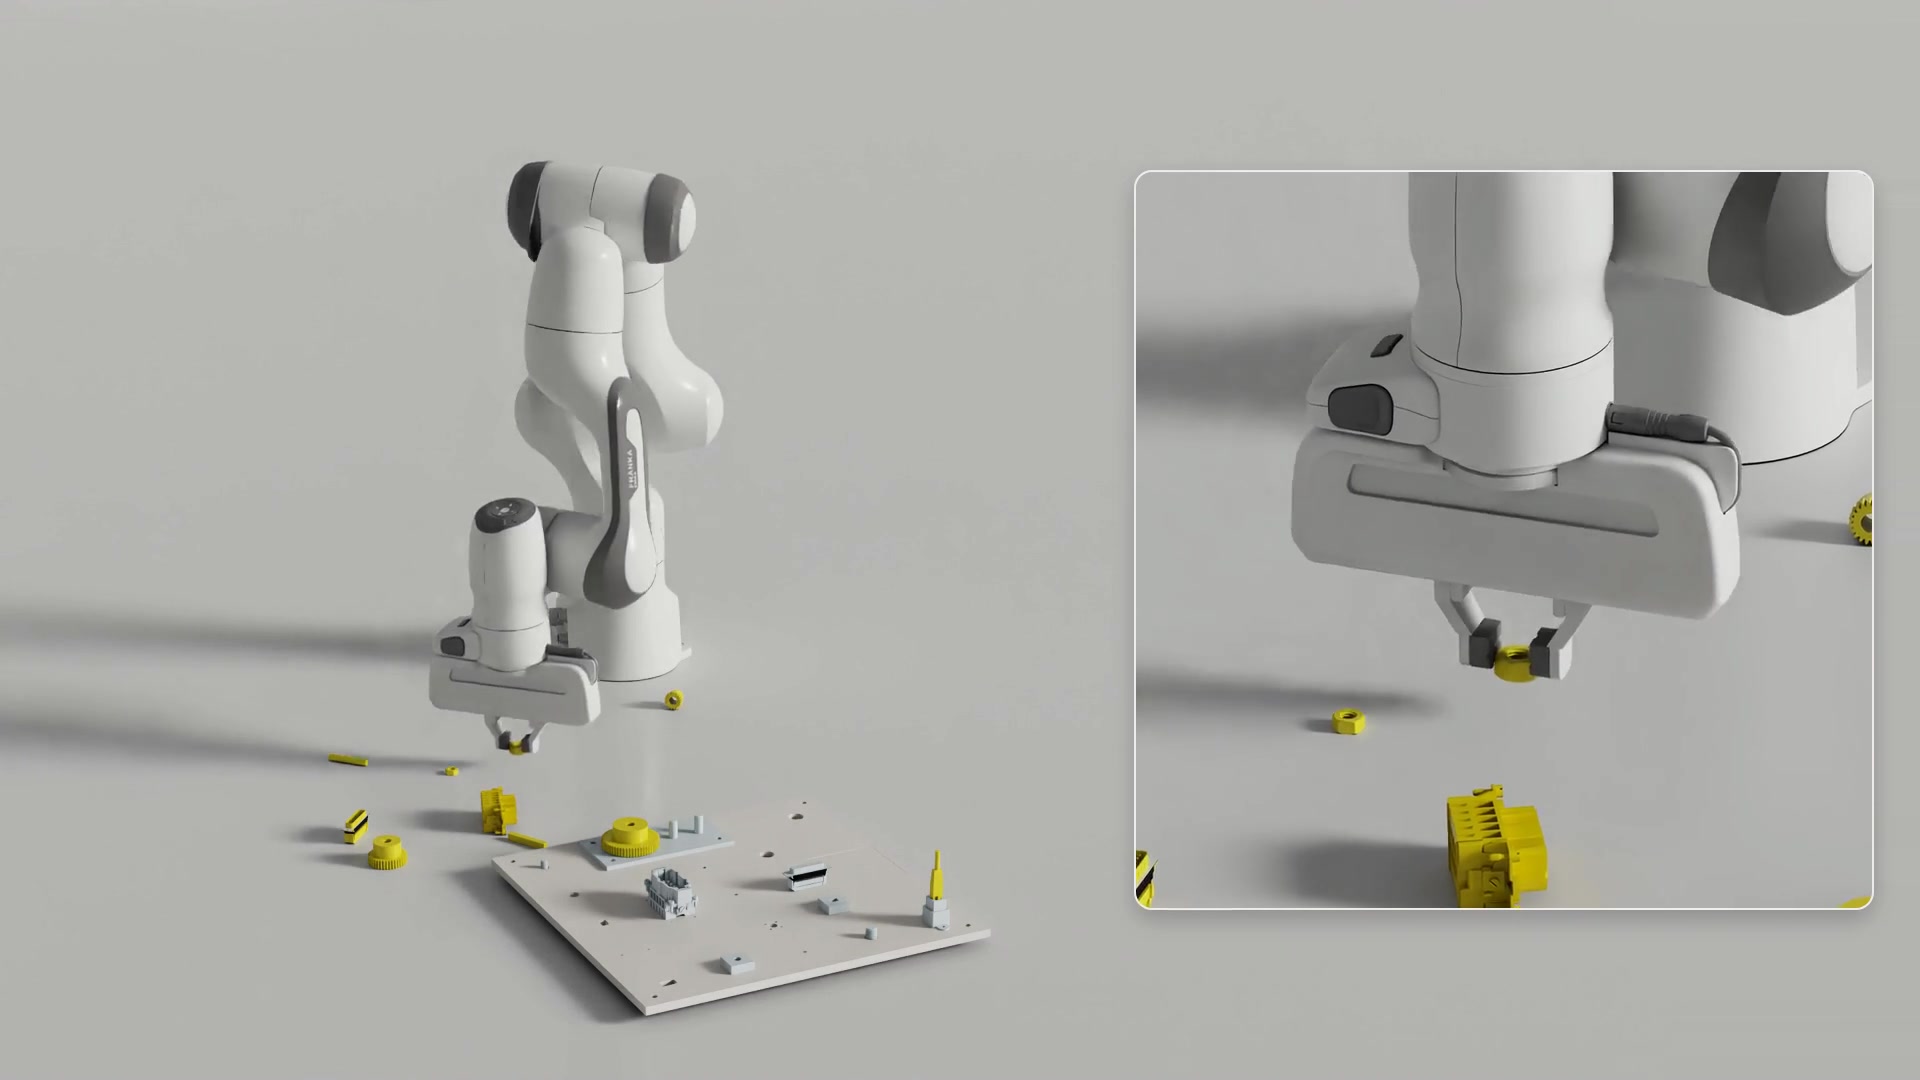
Сборка мелких деталей — сложная задача для роботов. На тестовой плате NIST Assembly Task Board #1 есть двадцать заданий с компонентами размером всего 4 мм, а установка одной детали может потребовать нескольких смен захвата и ориентации. Жёсткие зазоры оставляют мало места для ошибки: перекошенная гайка может заклинить или сорвать резьбу. Когда задействовано несколько деталей, робот также должен решить порядок операций, поскольку уже установленный компонент может мешать следующему движению захвата.
Вместо того чтобы программировать каждое движение, исследователи, стоящие за AlphaNIST, выбрали другой подход. Инструкции, написанные вручную, требуют предвидеть, как робот должен реагировать при изменении контактов и препятствий, а двухпальцевому захвату могут понадобиться решения, сильно отличающиеся от тех, которые использовала бы человеческая рука. Вместо этого робот получает бинарную награду за успешное выполнение задачи и обучается на огромном количестве разнообразного опыта. Это даёт ему возможность находить решения, которые его разработчики не рассматривали.
Обучение опирается на разнородные ресурсы и различные начальные состояния. Одна политика обучается на двадцати сборках, начиная с россыпи деталей, захватов в руке и частично собранных узлов, сохранённых в симуляции. Почти готовые стартовые состояния позволяют роботу отрабатывать завершение сборки до того, как ему придётся решать всю задачу целиком. Выборка с учётом успеха отдаёт предпочтение тем начальным состояниям, которые политика решает примерно в половине случаев, но при этом каждому состоянию даётся шанс, поэтому практика меняется по мере улучшения политики.
В экспериментах одна политика выполняет все двадцать задач сборки, причём в каждом запуске собирается один компонент. Работа, описанная в препринте на arXiv Октаем Чжаном и его коллегами, представлена как пример возникающих навыков сборки, которые появляются только благодаря бинарным наградам за задачи.
Источник: Hacker News · Сводку подготовил HeadlinesBriefing