
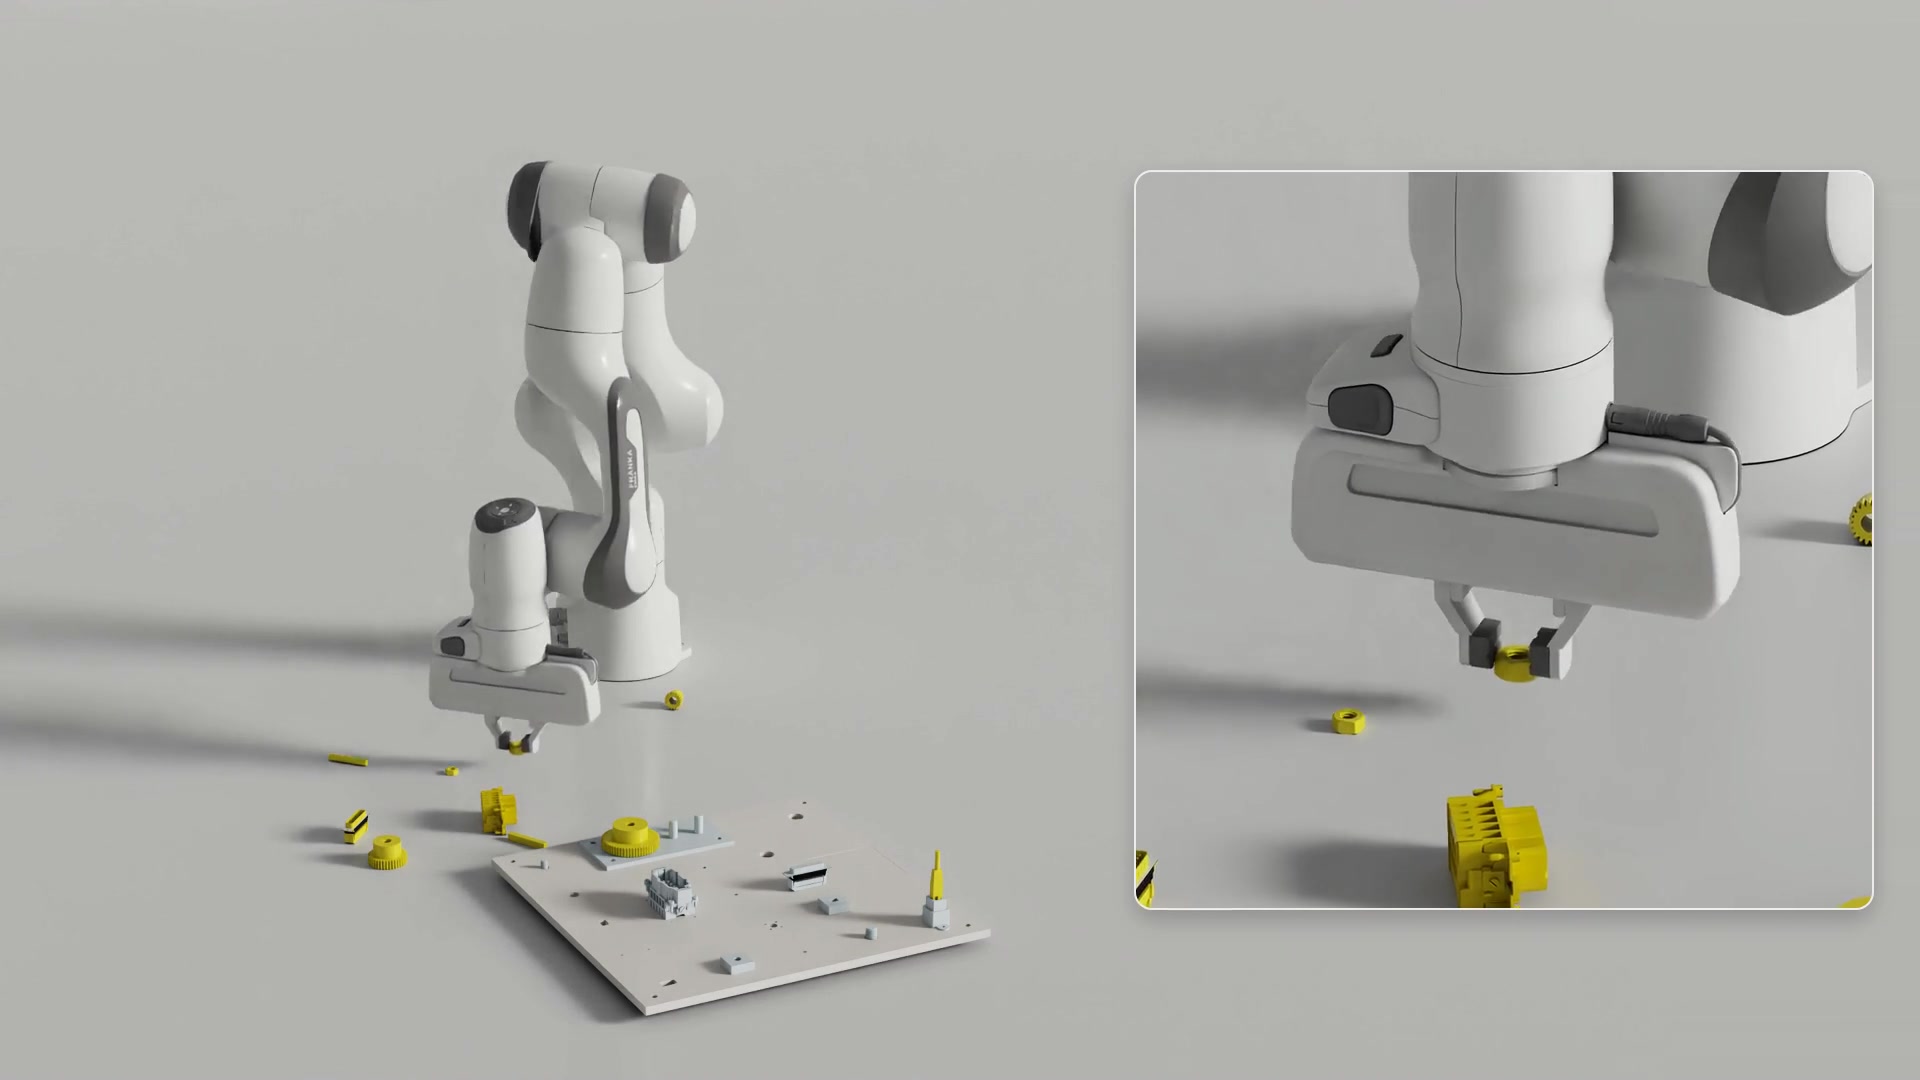
يُعدّ تجميع الأجزاء الصغيرة تحديًا صعبًا للروبوتات. تتضمن لوحة مهام التجميع NIST رقم 1 عشرين مهمة بمكونات يصل صغرها إلى 4 ملم، وقد يتطلب تركيب جزء واحد عدة تغييرات في القبضة والاتجاه. وتترك الخلوصات الضيقة هامشًا ضئيلًا للخطأ، إذ قد تعلق صامولة مائلة أو تتداخل خيوطها بشكل خاطئ. وعندما تشارك أجزاء متعددة، يجب على الروبوت أيضًا أن يحدد ترتيب العمليات، لأن مكونًا مركبًا قد يعيق حركة الذراع التالية.
وبدلًا من برمجة كل مناورة، يتبع الباحثون وراء AlphaNIST نهجًا مختلفًا. فالتعليمات المكتوبة يدويًا تتطلب توقع كيفية استجابة الروبوت مع تغير التلامس والعوائق، وقد تحتاج قبضة ذات إصبعين إلى حلول تختلف كثيرًا عن تلك التي تستخدمها اليد البشرية. وبدلًا من ذلك، يتلقى الروبوت مكافأة ثنائية عند النجاح في المهمة، ويتدرب عبر كمّ هائل من التجارب المتنوعة. وهذا يمنحه مساحة لاكتشاف حلول لم يفكر فيها مصمموه.
يعتمد التدريب على أصول متنوعة وحالات بداية مختلفة. تتدرب سياسة واحدة على عشرين عملية تجميع، تبدأ من أجزاء منفصلة، ومن قبضات ممسوكة في اليد، ومن تجميعات جزئية محفوظة في المحاكاة. وتتيح حالات البداية شبه المكتملة للروبوت التدرب على إنهاء التجميع قبل أن يضطر إلى حل المهمة كاملة. ويُفضّل أخذ العينات الموجه بالنجاح الحالات التي تحلها السياسة نحو نصف المرات، مع منح كل حالة فرصة، فيتغير التدريب مع تحسن السياسة.
في التجارب، تنفذ سياسة واحدة جميع مهام التجميع العشرين، مع تجميع مكون واحد في كل تشغيل. ويقدم العمل، الموصوف في نسخة أولية على arXiv من قبل Octi Zhang وزملائه، كمثال على مهارات تجميع ناشئة تنشأ من المكافآت الثنائية للمهام وحدها.
المصدر: Hacker News · لخّصه HeadlinesBriefing