
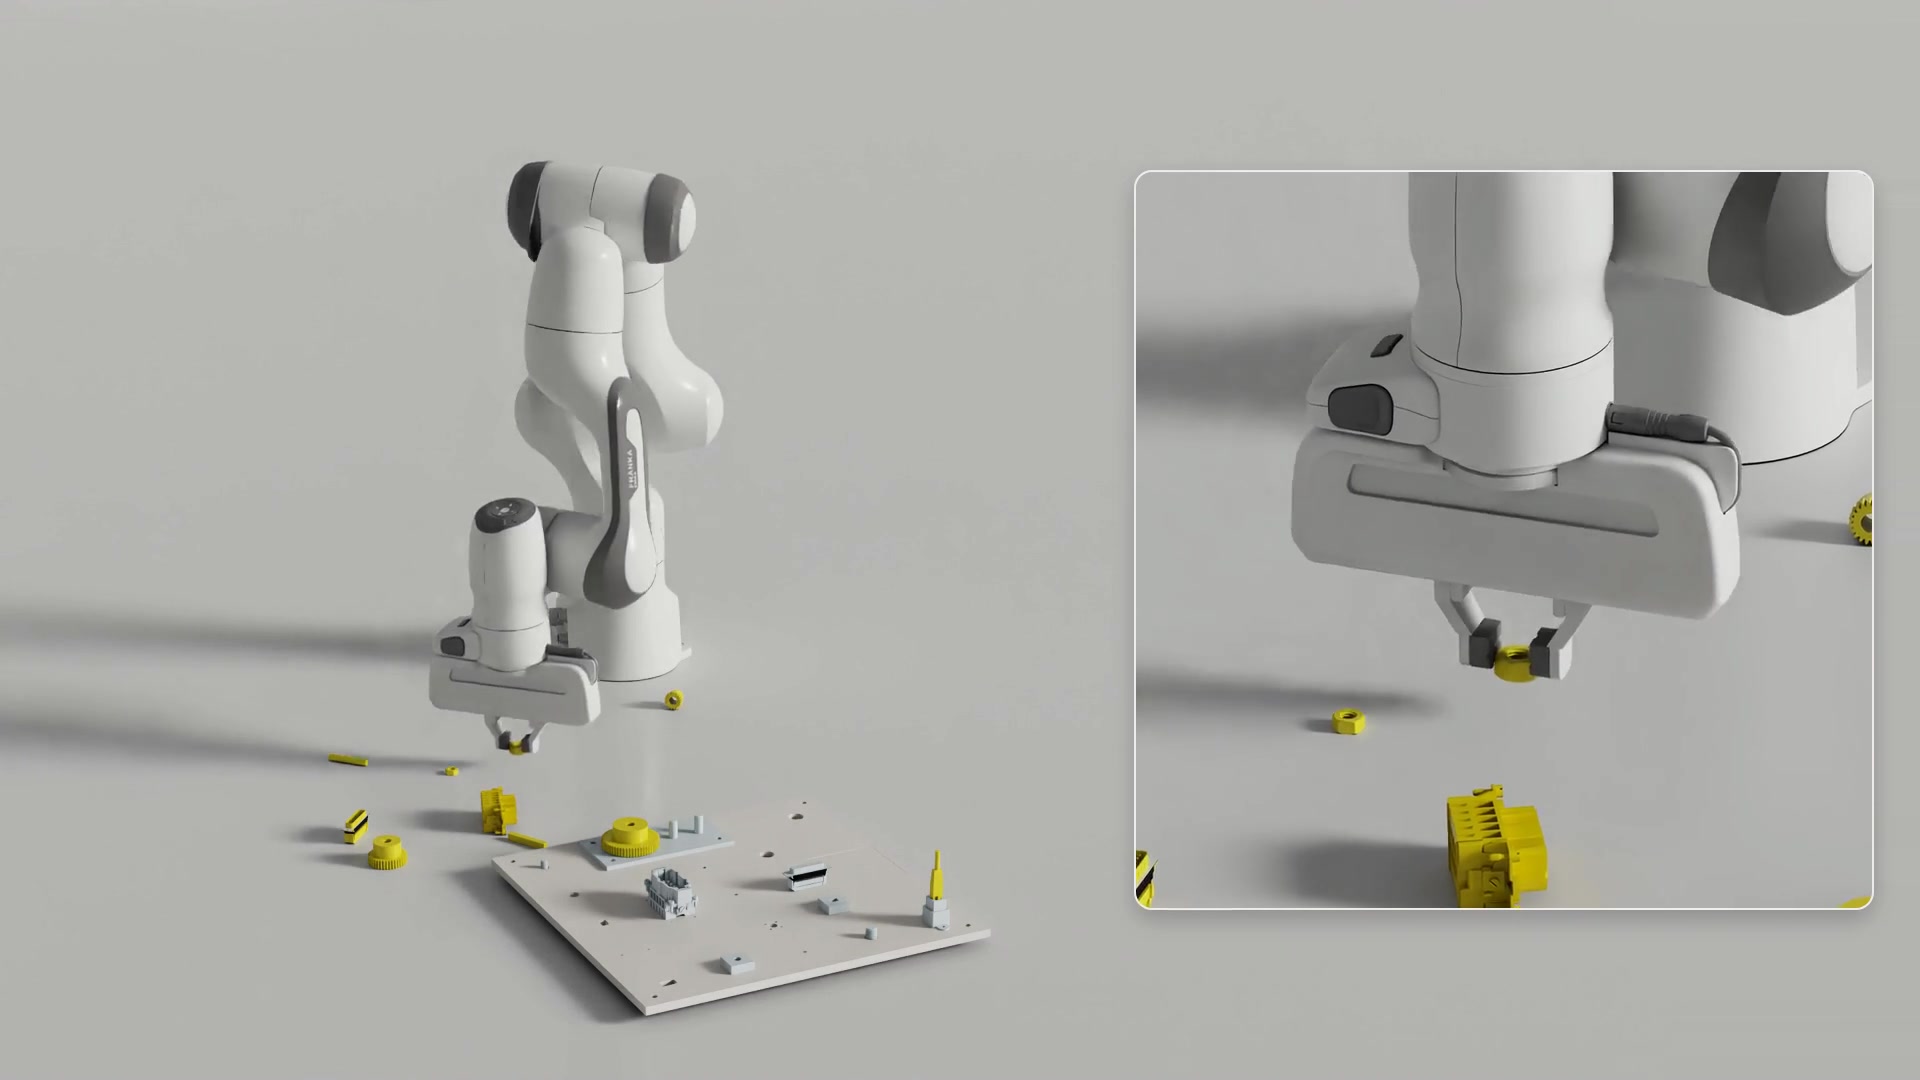
小さな部品の組み立ては、ロボットにとって難度の高い課題です。NIST組み立てタスクボード#1には、最小4mmの部品を用いる20の課題が含まれており、1つの部品を取り付けるにも何度かの持ち替えや向きの変更が必要になることがあります。すき間がわずかなため許容誤差はほとんどなく、ナットが傾くと引っかかったり、ねじ山がずれて噛み合ったりすることがあります。複数の部品が関わる場合、ロボットは作業の順序も判断しなければなりません。取り付け済みの部品がグリッパーの次の動きを妨げることがあるからです。
AlphaNISTの研究者たちは、すべての動作を事前にプログラムするのではなく、別のアプローチを採りました。手作業で書いた指示では、接触や障害物が変化するたびにロボットがどう反応すべきかを予測しておく必要があります。また、二本指のグリッパーでは、人間の手が使うものとは大きく異なる解決策が必要になることもあります。そこで、ロボットには課題の成功に対する二値報酬だけを与え、多様な経験を大量に積ませて学習させます。これにより、設計者が想定しなかった解決策を発見する余地が生まれます。
学習には、異なる部品や多様な初期状態が用いられます。1つのポリシーが20種類の組み立てを学習し、その開始点は、ばらばらの部品、手に持った状態、シミュレーション上に保存された部分組み立て品などです。ほぼ完成した状態から始めることで、ロボットは課題全体を解く前に、組み立ての仕上げを練習できます。成功を重視したサンプリングは、ポリシーがおよそ半分の確率で解ける初期状態を優先しつつ、すべての状態にも機会を与えるため、ポリシーの改善に伴って練習内容も変化していきます。
実験では、1つのポリシーで20種類すべての組み立て課題を実行し、各試行では1つの部品を組み立てました。Octi Zhangらによるarxivプレプリントで説明されているこの研究は、二値のタスク報酬だけから組み立ての技能が自然に現れる例として紹介されています。
出典: Hacker News · 要約:HeadlinesBriefing