
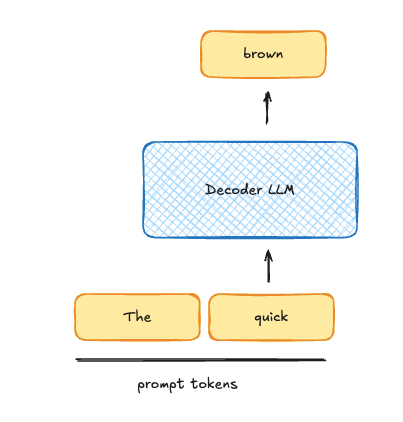
A menudo se supone que la decodificación especulativa es rápida porque realiza menos trabajo por token. Eso no es cierto. El número total de operaciones de punto flotante (FLOPs) para la misma secuencia en realidad aumenta. La aceleración proviene de cambiar el tipo de trabajo que realiza la GPU.
La decodificación de un token a la vez suele estar limitada por la memoria. Por cada token, la GPU debe transmitir todos los parámetros activos del modelo, como los 27B parámetros de Qwen3.5-27B, desde la memoria global. Mientras tanto, gran parte de la capacidad de cómputo permanece inactiva. La decodificación por lotes grandes de miles de tokens es lo contrario: está limitada por el cómputo, con la GPU ocupada en operaciones tensoriales.
La decodificación especulativa usa un modelo borrador pequeño para proponer una secuencia de tokens probables, que el modelo grande luego verifica en un único pase hacia adelante. Con tamaños de lote bajos, esto convierte un cómputo que de otro modo se desperdiciaría en progreso. En lugar de ejecutar cinco secuencias que avanzan un token cada una, una sola secuencia puede avanzar cinco tokens a la vez, con el mismo trabajo total.
La técnica tiene límites. Si la tasa de aceptación es inferior al 100%, cada token rechazado es trabajo desperdiciado. Con un rendimiento alto, cuando la GPU ya está limitada por el cómputo, la especulación añade costo sin beneficio, por eso vLLM ofrece el ajuste --speculative-disable-by-batch-size para desactivarla.
Fuente: Hacker News · Resumido por HeadlinesBriefing