
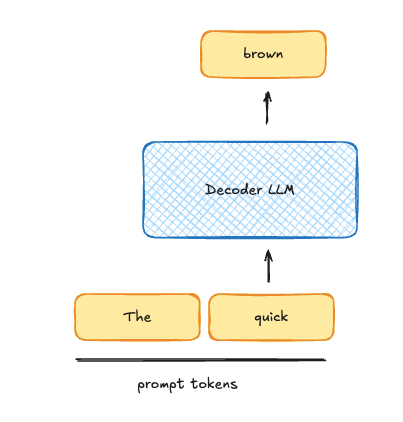
Часто считается, что спекулятивное декодирование быстрое, потому что выполняет меньше работы на каждый токен. Это неверно. Общее число операций с плавающей запятой (FLOPs) для той же последовательности на самом деле возрастает. Ускорение достигается за счёт изменения типа работы, которую выполняет GPU.
Декодирование по одному токену обычно ограничено памятью. Для каждого токена GPU должен передать из глобальной памяти все активные параметры модели, например 27 млрд параметров Qwen3.5-27B. В это время значительная часть вычислительных ресурсов простаивает. Крупное пакетное декодирование тысяч токенов, напротив, ограничено вычислениями: GPU занят тензорными операциями.
Спекулятивное декодирование использует небольшую черновую модель, которая предлагает последовательность вероятных токенов, а большая модель затем проверяет их за один прямой проход. При малых размерах пакета это превращает вычисления, которые иначе пропали бы впустую, в продвижение вперёд. Вместо того чтобы запускать пять последовательностей, каждая из которых продвигается на один токен, одна последовательность может сразу продвинуться на пять токенов при том же общем объёме работы.
У метода есть ограничения. Если доля принятых токенов ниже 100%, каждый отклонённый токен становится потраченной впустую работой. При высокой пропускной способности, когда GPU уже ограничен вычислениями, спекуляция добавляет издержки без выгоды, поэтому vLLM предлагает параметр --speculative-disable-by-batch-size для её отключения.
Источник: Hacker News · Сводку подготовил HeadlinesBriefing