
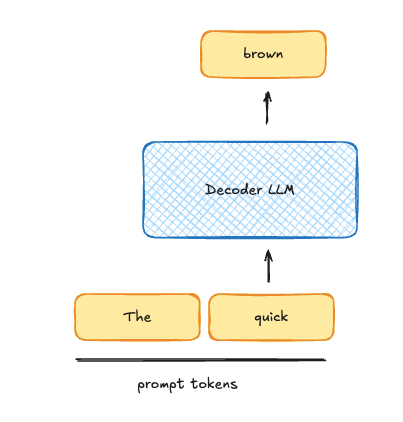
يُفترض غالبًا أن فك الترميز التخميني سريع لأنه ينجز عملًا أقل لكل رمز. وهذا ليس صحيحًا. فإجمالي عمليات الفاصلة العائمة (FLOPs) للتسلسل نفسه يرتفع فعليًا. وتأتي السرعة من تغيير نوع العمل الذي تنفذه وحدة معالجة الرسومات.
فك الترميز رمزًا واحدًا في كل مرة يكون عادةً مقيّدًا بالذاكرة. فلكل رمز، يجب على وحدة معالجة الرسومات أن تنقل جميع معلمات النموذج النشطة، مثل المعلمات البالغ عددها 27 مليارًا في Qwen3.5-27B، من الذاكرة العامة. وفي الأثناء، يبقى جزء كبير من قدرة الحوسبة خاملًا. أما فك الترميز الدفعي الكبير لآلاف الرموز فهو على النقيض: إذ يكون مقيّدًا بالحوسبة، وتكون وحدة معالجة الرسومات مشغولة بعمليات الموتورات.
يستخدم فك الترميز التخميني نموذج مسودة صغيرًا لاقتراح سلسلة من الرموز المرجحة، ثم يتحقق منها النموذج الكبير في تمريرة أمامية واحدة. وعند أحجام الدفعات المنخفضة، يحوّل ذلك الحوسبة التي كانت ستضيع إلى تقدم. فبدلًا من تشغيل خمسة تسلسلات تتقدم كل منها برمز واحد، يمكن لتسلسل واحد أن يتقدم بخمسة رموز دفعة واحدة، مع بقاء إجمالي العمل نفسه.
ولهذه التقنية حدود. فإذا كان معدل القبول أقل من 100%، فإن كل رمز مرفوض يمثل عملًا ضائعًا. وعند الإنتاجية العالية، حين تكون وحدة معالجة الرسومات مقيّدة بالحوسبة أصلًا، تضيف التخمين تكلفة دون فائدة، ولهذا يوفر vLLM الإعداد --speculative-disable-by-batch-size لإيقافه.
المصدر: Hacker News · لخّصه HeadlinesBriefing