
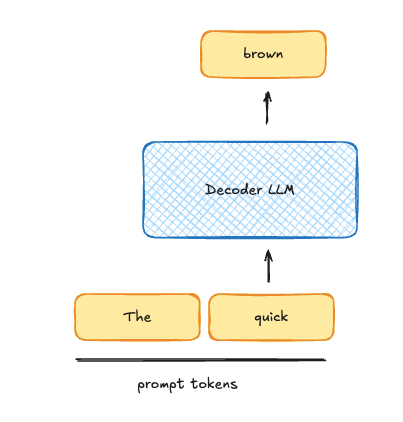
投機的デコーディングは、トークンあたりの作業量が少ないため高速だと考えられがちです。しかしそれは正しくありません。同じシーケンスに対する浮動小数点演算(FLOPs)の総数は、実際には増加します。高速化は、GPUが行う作業の種類を変えることから生まれます。
一度に1トークンずつデコードする処理は通常、メモリ律速です。各トークンごとに、GPUはグローバルメモリからアクティブなモデルパラメータすべてをストリーミングで読み込む必要があり、そのあいだ計算資源の多くは遊休状態にあります。一方、数千トークンをまとめて大きなバッチでデコードする処理はその逆で、計算律速となり、GPUはテンソル演算で忙しく動いています。
投機的デコーディングでは、小さなドラフトモデルが起こりやすいトークン列を提案し、大きなモデルがそれを1回のフォワードパスでまとめて検証します。バッチサイズが小さい場合、これは本来無駄になっていた計算を前進へと変えます。5つのシーケンスがそれぞれ1トークンずつ進む代わりに、1つのシーケンスが一度に5トークン進めるため、総作業量は同じです。
この手法には限界もあります。受理率が100%未満の場合、拒否されたトークンはすべて無駄な作業になります。GPUがすでに計算律速にあるような高スループット時には、投機は利益なくコストを加えるだけになるため、vLLMでは--speculative-disable-by-batch-size設定で無効化できるようになっています。
出典: Hacker News · 要約:HeadlinesBriefing