
ملاحظة: كالعادة، كل ما أكتبه علنًا يكتبه يدي بيد. ملخص
فلتر بلووم هو هيكل بيانات احتمالي يتيح لك الإجابة بسرعة وباستثناء منخفض على السؤال "هل المفتاح X في هذه المجموعة؟" إما "بالتأكيد لا" أو "ربما نعم". تختار معدل إيجابي خطأ مقبول لحمل العمل والأجهزة، وتضيف المفاتيح إلى المجموعة، وتتحقق من وجودها لاحقًا. فلاتر بلووم تستخدم كمية صغيرة من الذاكرة مقارنة ببطاقة المجموعة، وهي اقتصادية حسابيًا للغاية. لهذه الأسباب، فهي تُستخدم بانتظام في أنظمة بيانات عالية الأداء. على سبيل المثال، قد تحتفظ قاعدة بيانات بفلتر بلووم في الذاكرة وتتحقق منه قبل الذهاب إلى القرص فعليًا عند البحث عن صفوف. هذا يوفر كميات كبيرة من إدخال/إخراج القرص البطيء جدًا. نستخدمها أيضًا في كل مكان في خلفية بلوزكي. تسمح لنا بتوفير ملايين الاستعلامات في الثانية ضد قاعدة بيانات سيلا عند البحث عن حظر، كتم، وضع علامات، وأكثر من ذلك. على سبيل المثال، يمكننا غالبًا الإجابة على السؤال "هل يحظر المستخدم X المستخدم Y؟" دون حتى لمس قاعدة البيانات.
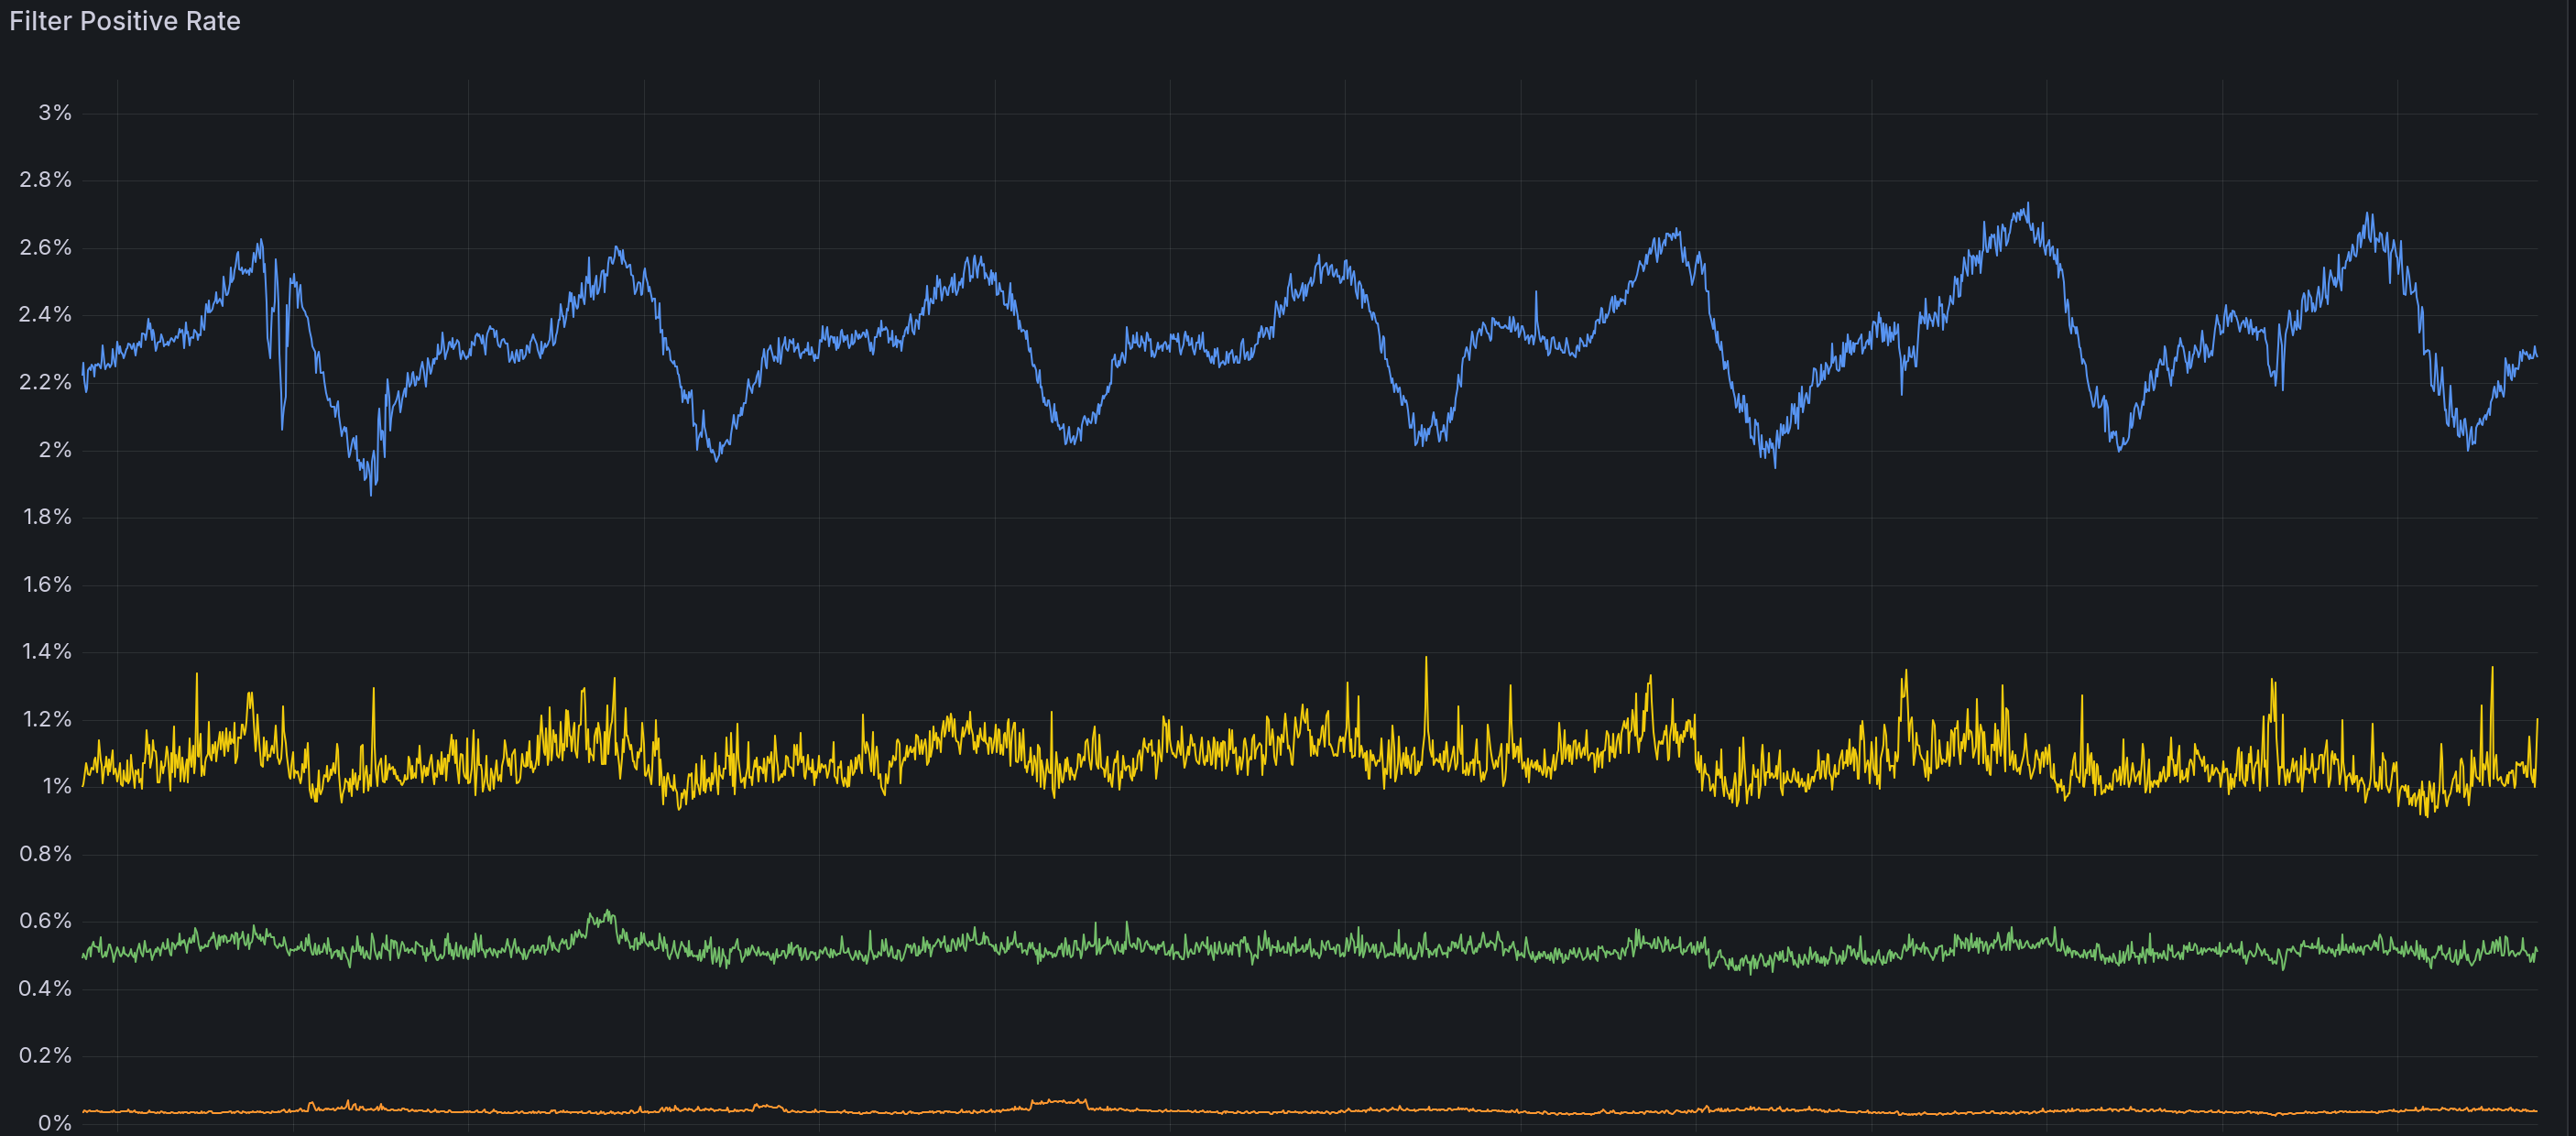
إليك آخر عدة أيام من معدلات النجاح الإيجابية لبعض فلاتر بلووم لدينا:
الخط الأصفر أعلاه يظهر معدل إيجابي حوالي 1%، مما يعني أن 99% من الوقت، يمكننا تخطي الاستعلام عن قاعدة البيانات تمامًا. كان هذا بالضرورة لقدرتنا على توسيع الموقع وتشغيله بتكلفة منخفضة.
فلاتر بلووم التقليدية
فلتر بلووم هو مصفوفة من البتات وk دوال تجزئة. تختار حجم المصفوفة وk مسبقًا، وتريد توجيهه بشكل صحيح لحمل العمل لتحقيق معدل خطأ إيجابي محدد. لإضافة مفتاح إلى المجموعة، قم بتشغيله من خلال k دوال تجزئة وتعيين البتات في كل موقع. للتحقق مما إذا كان مفتاح في المجموعة، قم بتجزئته k مرات وتحقق من كل موقع ناتج في مصفوفة البتات. إذا كان أي بت صفرًا، فلم يتم إضافة المفتاح أبدًا. إذا كانت جميع البتات مُعينة إلى 1، فقد يكون في المجموعة.
التجزئة المزدوجة
على الرغم من أنها أرخص بكثير من الذهاب إلى القرص، فإن حساب k تجزئات مستقلة لكل مفتاح لا يزال قليلًا مكلفًا لأنظمة الأداء العالي جدًا. في عام 2008، كتب Kirsch وMitzenmacher ورقة أثبتت أن هاشين يمكن أن يعطيا نفس الناتج. الرياضيات فوق رأسي بكثير، لكن إذا اشتقت الموقع الـ i كـ (hash_1 + i*hash_2) % n، فإن معدل الأخطاء الإيجابية هو فعليًا نفسه باستخدام k تجزئات مستقلة. نجم!
bits-and-blooms/bloom الذي يُدار بواسطة Daniel Lemire (مصدر إلهام كبير بالنسبة لي، يجب أن تشتري كتابه) هو تنفيذ رائع لفلتر بلووم بتجزئة مزدوجة مكتوب بلغة Go. يقوم بتشغيل murmur3 بتدفق 128 بت مرتين للحصول على أربعة قيم بتدفق 64 بت، ثم دمجها لإنتاج جميع مواقع k. استخدمناه في الإنتاج في بلوزكي لفترة طويلة.
بالنسبة لخلفية بلوزكي، نقوم في الأساس بـ SELECT * FROM blocks, mutes, list items, إلخ كلما بدأت إحدى العمليات، ونضيف جميع العناصر إلى فلتر بلووم. هناك أيضًا مستهلك firehose atproto في الوقت الحقيقي يقوم بإدراج العناصر في فلاتر بلووم (حتى أثناء بدء التشغيل)، لذا هناك حالة تنافس إذا لم تكن حذرًا. المشكلة مع مكتبة bits-and-blooms هي أنها غير آمنة بشكل داخلي للخيوط، لذا كنا بحاجة إلى لف جميع الوصول إلى فلتر بلووم في ميوتكس لتجنب حالة تنافس بيانات. أظهر pprof أن ميوتكس كانت في الواقع ال bottlene في بدء العملية. استغرق نشر واحد 90 دقيقة للإكمال تمامًا بسبب هذا! لذا قام زميلي Jasmine بعمل fork للمكتبة وخلق atomic-bloom، الذي يستخدم تعليمات CPU الذرية للقيام بنفس المنطق، لكن بشكل آمن وبدون ميوتكس. هذا أدى إلى حدوث أقل بكثير وكان أسرع بشكل كبير من النهج المستند إلى الميوتكس. انخفضت عمليات النشر الخاصة بنا من 90 دقيقة إلى حوالي 15، مما مكننا من شحن الأشياء بشكل أسرع وبمزيد من الثقة. رائع!
هاش واحد
هل يمكننا المضي قدمًا؟ بالنسبة لبلوزكي، الجواب لا. كانت المنافسة هي مشكلتنا الأصلية، وليس عدد دوال التجزئة أو عوامل أخرى، لذا بحكم قانون أمدال، لم نحصل على أي فائدة إضافية...
المصدر: Hacker News · لخّصه HeadlinesBriefing