
Примечание: как всегда, все мои публичные тексты пишутся мной вручную.
Обзор
Фильтр Блума — это вероятностная структура данных, которая позволяет быстро и недорого ответить на вопрос «ключ X есть в этом наборе?» — «определенно нет» или «возможно да». Вы выбираете допустимую для вашей нагрузки и оборудования частоту ложных срабатываний, добавляете ключи в набор и позже проверяете их существование. Фильтры Блума используют небольшое количество памяти по сравнению с мощностью набора и вычислительно очень недороги. По этим причинам они часто используются в системах данных высокой производительности. Например, база данных может хранить фильтр Блума в памяти и проверять его перед тем, как идти на диск при поиске строк. Это экономит значительные количествы очень медленного ввода-вывода диска. Мы также используем их повсюду в бэкенде Bluesky. Они позволяют нам экономить миллионы запросов в секунду к нашей базе данных Scylla при поиске блокировок, заглушек, меток и т.д. Например, мы часто можем ответить на вопрос «блокирует ли пользователь X пользователя Y?», не касаясь базы данных.
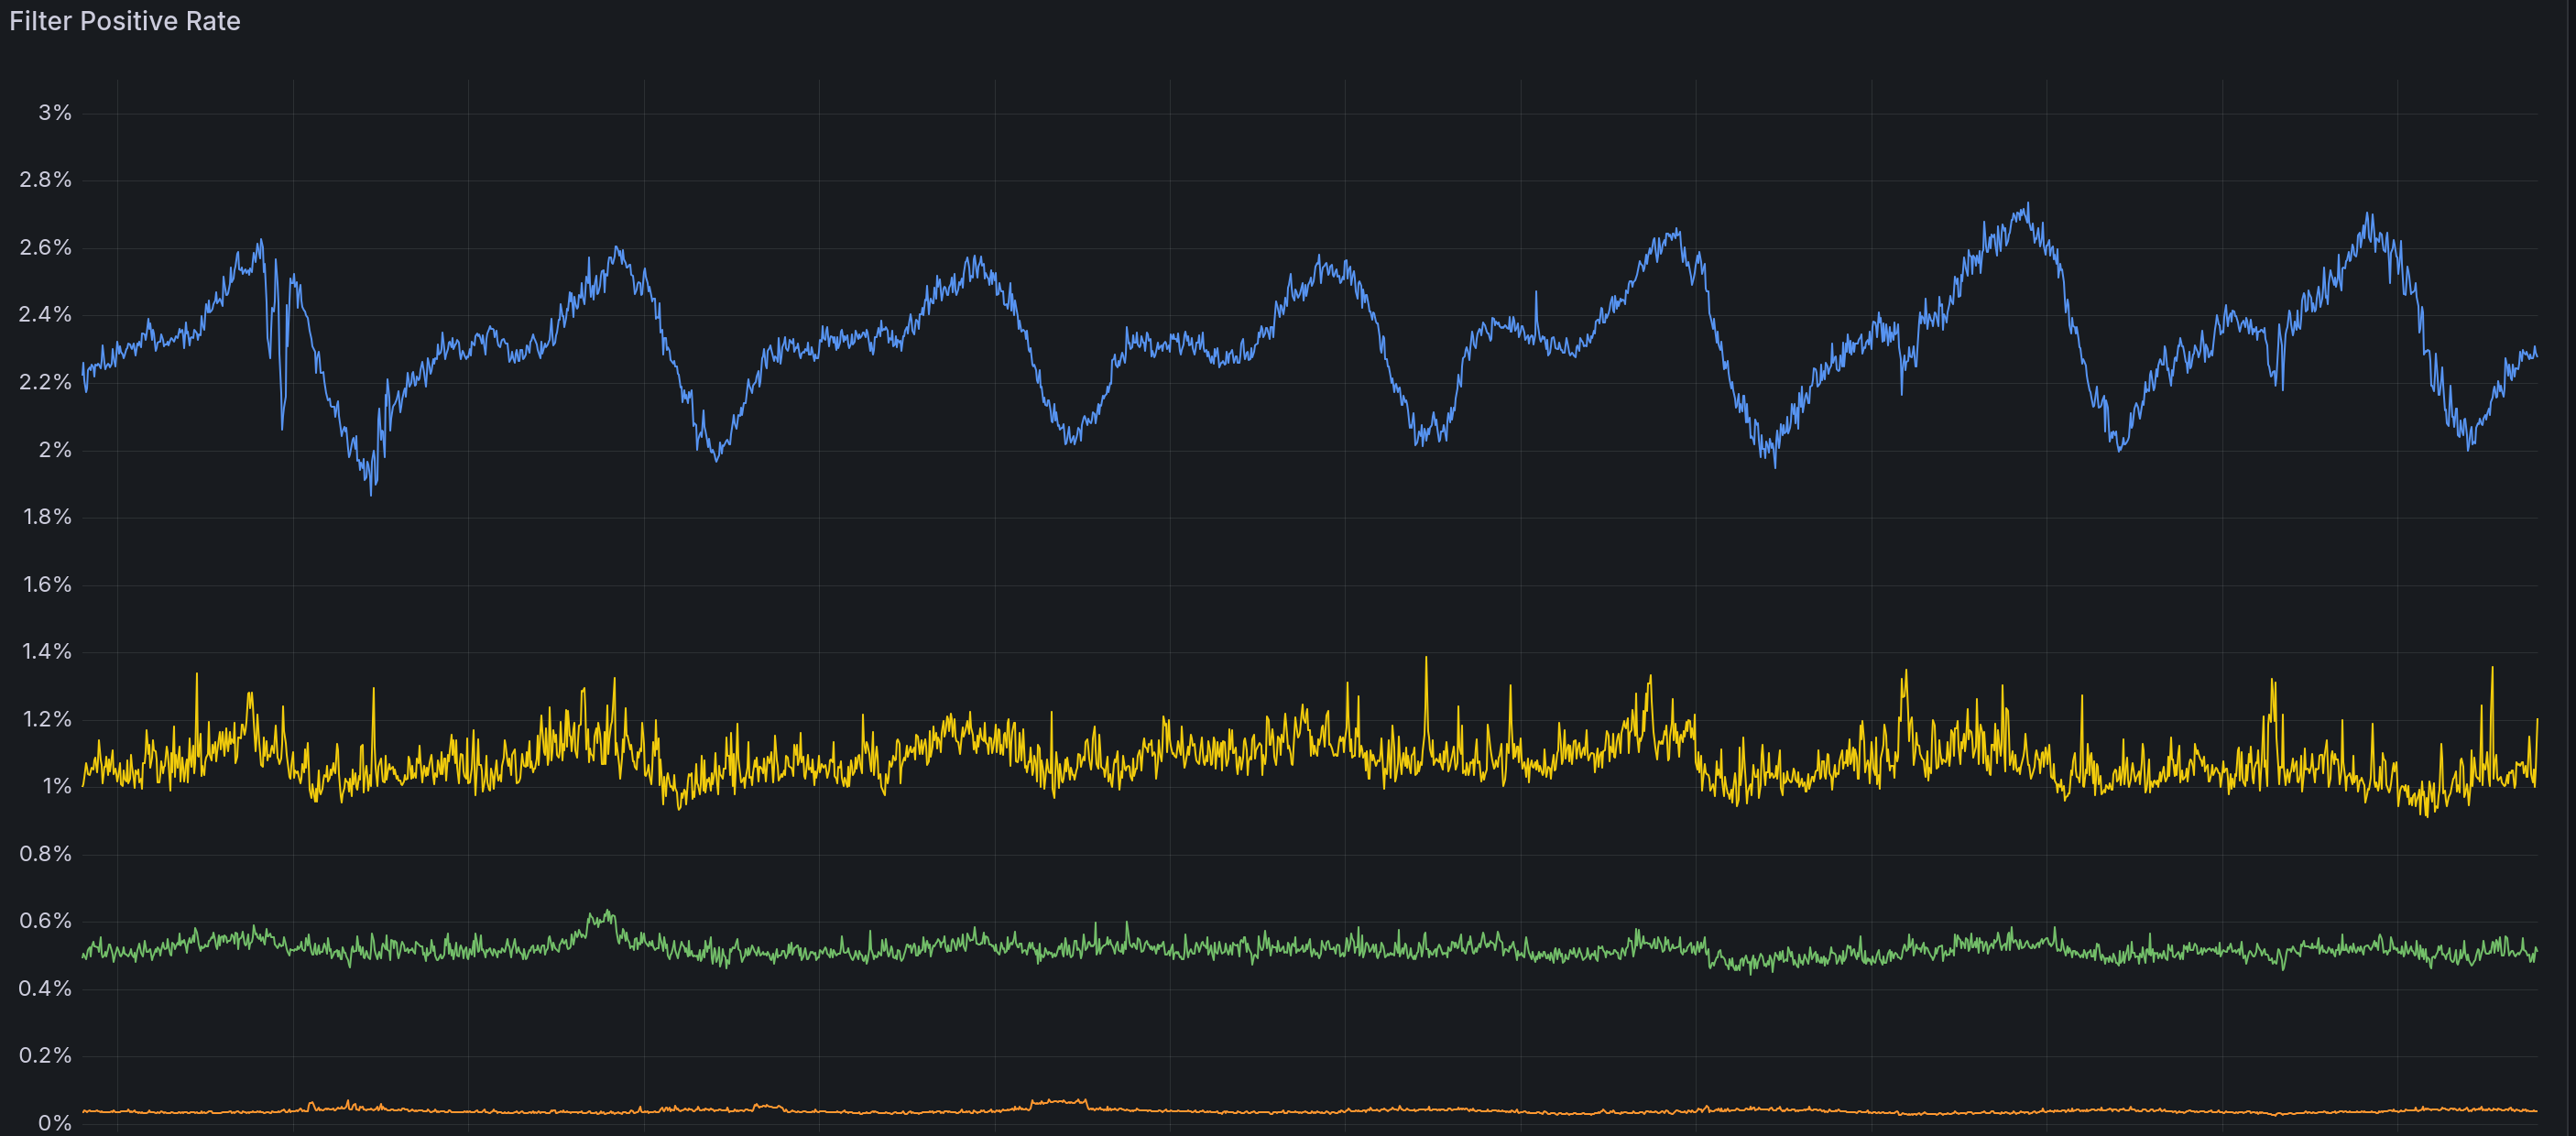
Вот последние несколько дней некоторых наших показателей положительных совпадений фильтров Блума:
Верхняя желтая линия показывает примерно 1% положительную ставку, что означает, что 99% времени мы можем полностью пропустить запрос к нашей базе данных. Это было критически важно для нашей способности масштабировать сайт и эксплуатировать его дешево.
Традиционные фильтры Блума
Фильтр Блума — это массив битов и k хеш-функций. Вы выбираете размер массива и k заранее, и хотите правильно настроить его под свою нагрузку, чтобы достичь определенной частоты ложных срабатываний. Чтобы добавить ключ в набор, пропустите его через k хеш-функций и установите биты в каждом из этих мест. Чтобы проверить, есть ли ключ в наборе, хешируйте его k раз и проверяйте каждое полученное место в массиве битов. Если какой-либо бит равен нулю, ключ никогда не добавлялся. Если все биты установлены в 1, он может быть в наборе.
Двойное хеширование
Хотя это намного дешевле, чем идти на диск, вычисление k независимых хешей для каждого ключа все еще немного дорого для систем очень высокой производительности. В 2008 году Кирш и Митценмакер опубликовали статью, доказывающую, что два хеша могут дать вам тот же результат. Математика стоит гораздо выше моей головы, но если вы выведете i-е место как (hash_1 + i*hash_2) % n, то частота ложных срабатываний будет фактически такой же, как при использовании k независимых хешей. Уф!
bits-and-blooms/bloom, поддерживаемый Daniel Lemire (большое вдохновение для меня, вы должны купить его книгу), — это замечательная реализация фильтра Блума с двойным хешированием, написанная на Go. Он запускает 128-битный murmur3 дважды, чтобы получить четыре 64-битных значения, а затем объединяет их для создания всех k позиций битов. Мы использовали это в производстве в Bluesky длительное время.
Для бэкенда Bluesky мы по существу делаем SELECT * FROM blocks, mutes, list items и т.д. каждый раз, когда один из процессов запускается, и добавляем все элементы в фильтр Блум
Источник: Hacker News · Сводку подготовил HeadlinesBriefing