
Nota: como sempre, toda a minha escrita pública é escrita à mão por mim.
Visão geral
Um filtro Bloom é uma estrutura de dados probabilística que permite responder rapidamente e baratamente à pergunta "a chave X está neste conjunto?" com "definitivamente não" ou "provavelmente sim". Você escolhe uma taxa de falsos positivos aceitável para sua carga de trabalho e hardware, adiciona chaves ao conjunto e verifica sua existência mais tarde. Filtros Bloom usam uma pequena quantidade de memória em comparação com a cardinalidade do conjunto e são computacionalmente muito baratos. Por essas razões, são frequentemente usados em sistemas de dados de alto desempenho. Por exemplo, um banco de dados pode manter um filtro Bloom em memória e verificá-lo antes de realmente ir ao disco ao procurar linhas. Isso economiza grandes quantidades de muito lento I/O de disco. Também os usamos em todo o lugar no backend do Bluesky. Eles nos permitem economizar milhões de consultas por segundo contra nosso banco de dados Scylla ao procurar bloqueios, silenciamentos, rótulos e mais. Por exemplo, frequentemente podemos responder à pergunta "o usuário X bloqueia o usuário Y?" sem nem tocar no banco de dados.
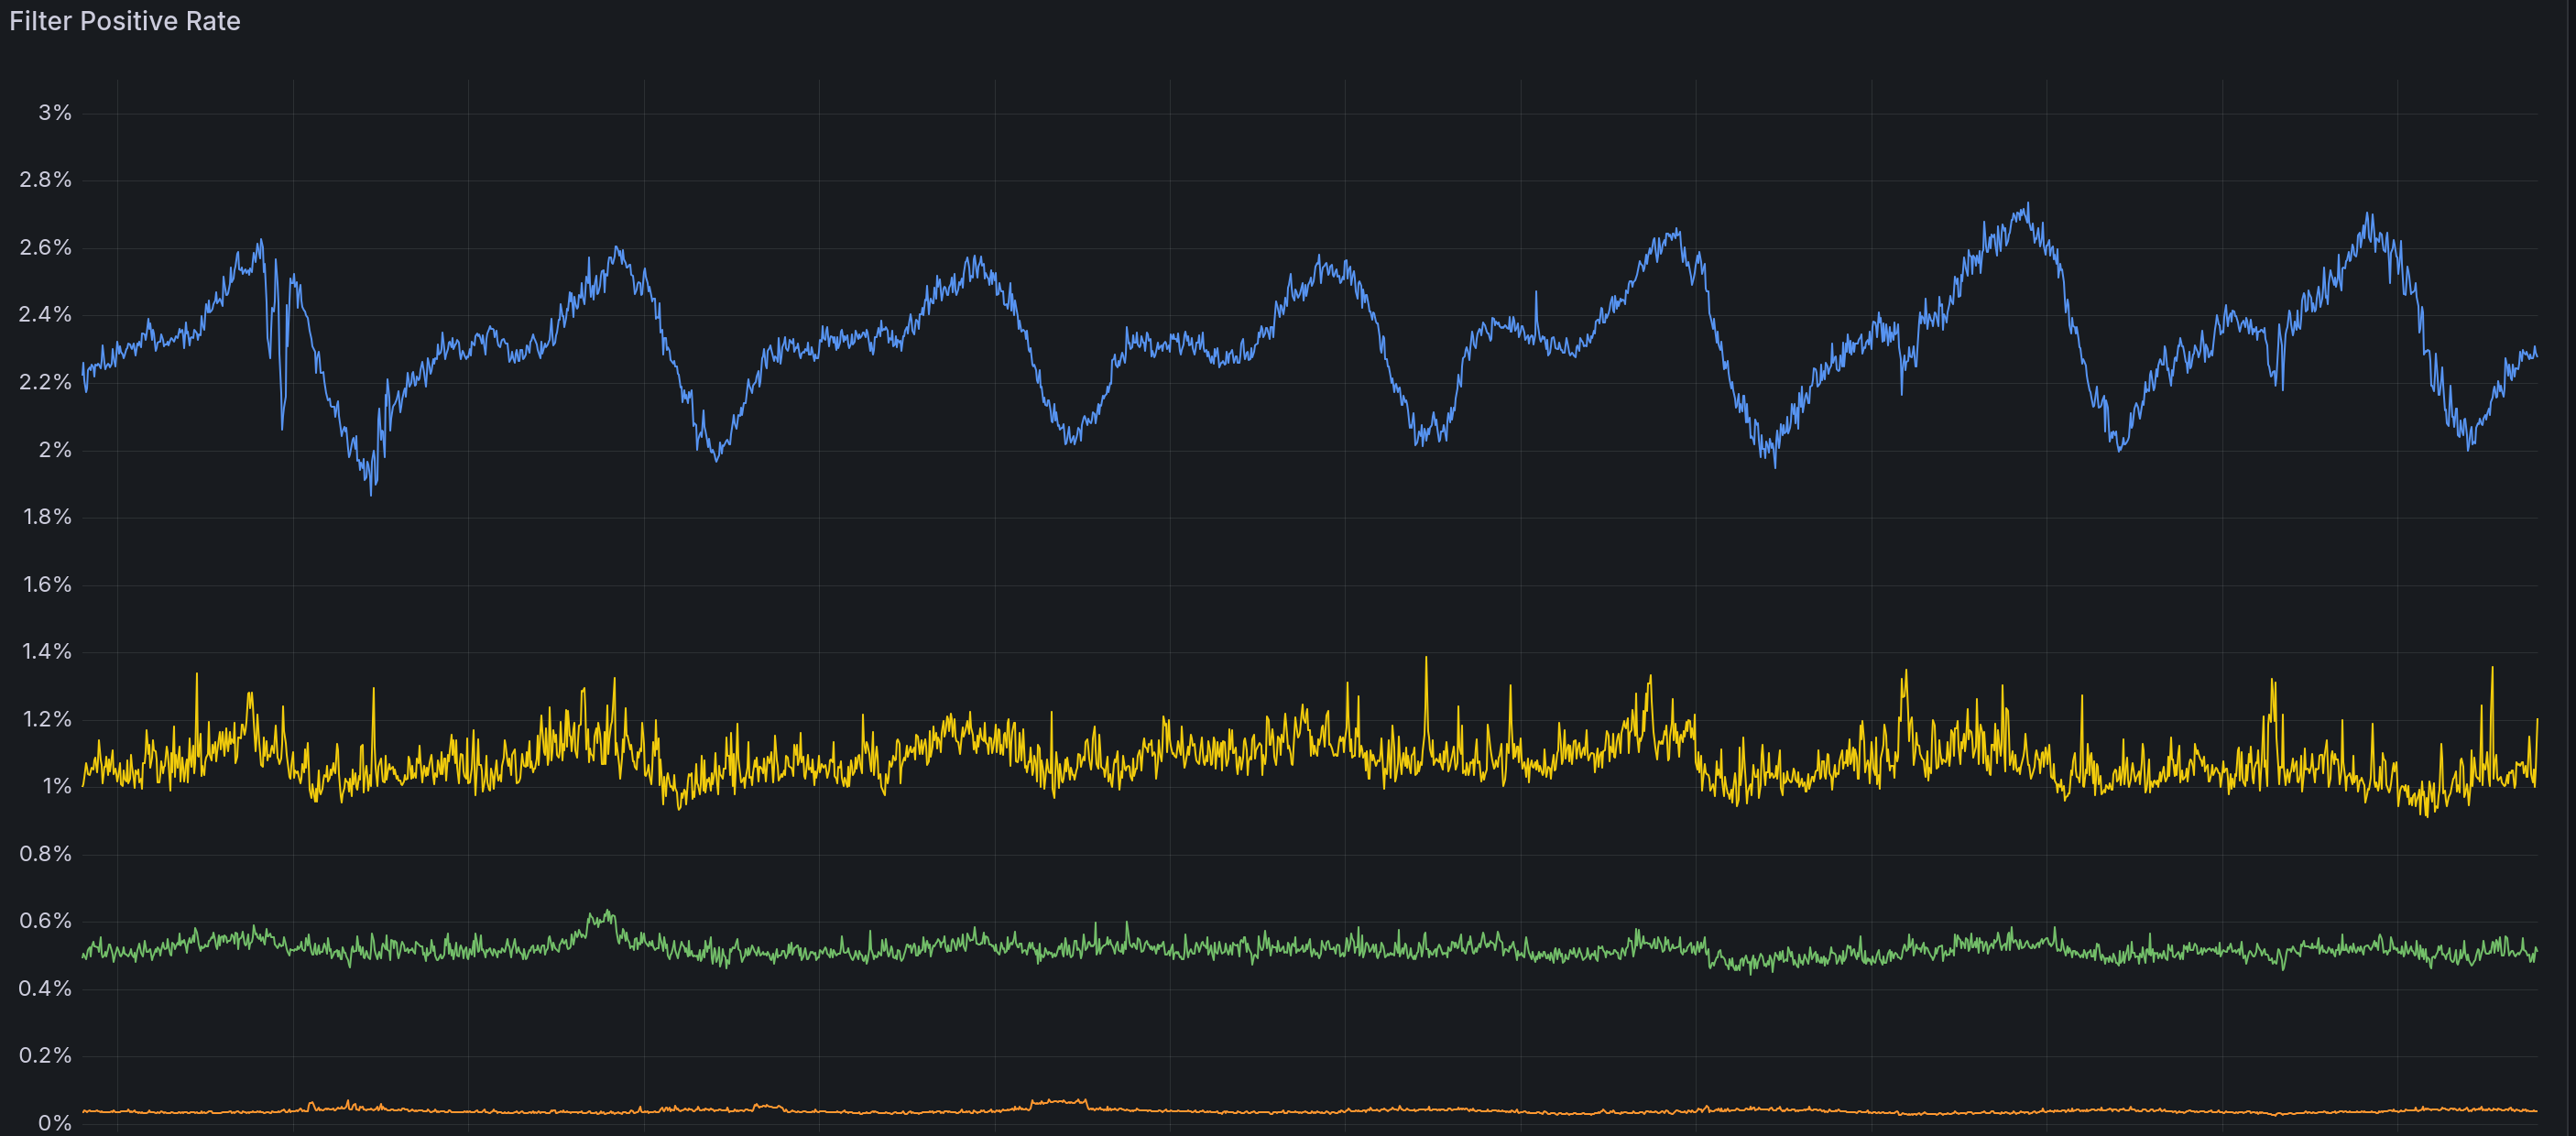
Aqui estão os últimos dias de algumas de nossas taxas de acerto positivo de filtros Bloom:
A linha amarela acima tem uma taxa positiva de cerca de 1%, o que significa que 99% do tempo, podemos completamente ignorar a consulta ao nosso banco de dados. Isso foi crítico para nossa capacidade de escalar o site e operá-lo com baixo custo.
Filtros Bloom Tradicionais
Um filtro Bloom é uma matriz de bits e k funções hash. Você escolhe o tamanho da matriz e k de antemão, e quer dimensioná-lo corretamente para sua carga de trabalho para atingir uma taxa específica de falsos positivos. Para adicionar uma chave ao conjunto, passe-a pelas k funções hash e defina os bits em cada uma dessas localizações. Para verificar se uma chave está no conjunto, hash-a k vezes e verifique cada localização resultante na matriz de bits. Se algum bit for zero, a chave nunca foi adicionada. Se todos os bits estiverem definidos como um, ele pode estar no conjunto.
Hash Duplo
Embora seja muito mais barato do que ir ao disco, calcular k hashes independentes por chave ainda é um pouco caro para sistemas de muito alto desempenho. Em 2008, Kirsch e Mitzenmacher publicaram um artigo demonstrando que dois hashes podem lhe dar a mesma saída. As matemáticas estão muito acima da minha cabeça, mas se você derivar a i-ésima localização como (hash_1 + i*hash_2) % n, então a taxa de falsos positivos é efetivamente a mesma que usar k hashes independentes. Ufa!
bits-and-blooms/bloom mantido por Daniel Lemire (uma enorme inspiração para mim, você deve comprar seu livro) é uma excelente implementação de filtro Bloom de hash duplo escrita em Go. Ele executa murmur3 de 128 bits duas vezes para obter quatro valores de 64 bits, e então os combina para produzir todas as localizações de bits k. Usamos isso em produção no Bluesky por muito tempo.
Para o backend do Bluesky, essencialmente fazemos um SELECT * FROM blocks, mutes, list items, etc. cada vez que um dos processos começa, e adicionamos todos os itens ao filtro Bloom. Também há um consumidor em tempo real do firehose atproto inserindo itens nos filtros Bloom (mesmo durante a inicialização do processo), então há uma condição de corrida se você não tiver cuidado. O problema com a biblioteca bits-and-blooms é que ela não é internamente segura para threads, então precisávamos envolver todos os acessos ao filtro Bloom em um mutex para evitar uma condição de corrida de dados. O pprof mostrou que a contenção do mutex realmente era o gargalo no lançamento do processo. Um único deploy costumava levar 90 minutos para ser totalmente concluído por caus disso! Então meu colega Jasmine fez um fork da biblioteca e criou atomic-bloom, que usa instruções de CPU atômicas para fazer a mesma lógica, mas de forma segura e sem mutexes. Isso resultou em muito menos contenção e foi significativamente mais rápido que a abordagem baseada em mutex. Nossos deploys passaram de 90 minutos para cerca de 15, o que nos permitiu enviar mais rápido e com maior confiança. Incrível!
Um Único Hash
Podemos ir mais longe? Para o Bluesky, a resposta é não. A contenção era nosso problema original, não o número de funções hash ou outros fatores, portanto, de acordo com a lei de Amdahl, não recebemos nenhum benefício adicional...
Fonte: Hacker News · Resumido por HeadlinesBriefing